Машинное зрение, как ключевая технология для обработки изображений и принятия решений в промышленной и автоматизированной сферах, требует высокой точности обработки изображений при одновременном соблюдении множества инженерных ограничений, таких как работа в реальном времени, миниатюризация и энергоэффективность. Эти требования привели к глубокой интеграции машинного зрения и периферийного интеллекта, что породило новую область исследований — интеллектуальные системы машинного зрения в реальном времени.
В данной статье систематически рассматривается прогресс в этой междисциплинарной области с трех точек зрения: эволюция алгоритмов, совместное проектирование аппаратного и программного обеспечения и инженерные приложения.
Во-первых, обобщается разработка интеллектуальных алгоритмов машинного зрения, представленных сверточными нейронными сетями и графическими трансформерами, с акцентом на роль методов сжатия моделей, включая обрезку, квантование и проектирование облегченной архитектуры, в обеспечении развертывания на периферии.
Во-вторых, рассматриваются платформы периферийных вычислений, подходящие для задач интеллектуального машинного зрения, и обсуждаются типичные стратегии совместной оптимизации аппаратного и программного обеспечения при развертывании алгоритмов искусственного интеллекта.
Кроме того, на основе анализа типичных приложений, таких как интеллектуальные подключенные транспортные средства, системы городского видеонаблюдения и робототехника, в статье подчеркиваются преимущества и потенциал систем периферийного зрения в сценариях, чувствительных к задержке.
Наконец, в ней определяются текущие проблемы, включая системную интеграцию, вычислительную эффективность, энергоэффективность и уровень интеллекта, а также рассматриваются перспективные направления, такие как вычисления внутри сенсора, вычисления в оперативной памяти, нейроморфные вычисления и развертывание больших моделей на периферии устройства. В целом, этот обзор подчеркивает, что глубокая синергия между алгоритмами, оборудованием и приложениями станет ключевым путем к реализации автономного, адаптивного и перцептивно-интеллектуального машинного зрения, основанного на периферийном интеллекте.
1. Введение
Машинное зрение — это ключевая технология, обеспечивающая интеллектуальное восприятие и принятие решений в реальном времени посредством автоматизированного получения изображений и алгоритмической обработки. В эпоху Интернета вещей и стремительного развития интеллекта машинное зрение служит «глазами» интеллектуальных систем, наделяя устройства способностью воспринимать и понимать окружающую среду. Оно широко применяется в промышленной инспекции, автономном вождении, медицинской диагностике и системах «умного города» [1]. Между тем, появление передовых алгоритмов искусственного интеллекта (ИИ) привело к значительным прорывам в таких задачах, как обнаружение объектов и распознавание образов, значительно превосходя традиционные методы. Следовательно, интеграция ИИ и машинного зрения стала важной тенденцией как в академических исследованиях, так и в промышленных приложениях [2].
Однако из-за вычислительно интенсивного характера алгоритмов ИИ существующие интеллектуальные системы машинного зрения часто используют парадигму, в которой при развертывании разделяются процессы сбора и обработки данных [3] . Если данные могут обрабатываться локально на периферии, конфиденциальная информация не обязательно должна передаваться в облако, что значительно снижает потенциальные риски безопасности, связанные с передачей данных и облачным хранением. Например, в автономном вождении бортовые камеры захватывают информацию об окружающей среде, которая передается по коммуникационным сетям в удаленные вычислительные центры, где мощные серверы выполняют планирование траектории, обнаружение пешеходов и другие задачи, прежде чем отправить результаты обратно в транспортное средство [4] . Такой подход создает ряд проблем. Передача всех визуальных данных в облако для централизованной обработки неизбежно увеличивает задержку, серьезно снижая способность системы принимать решения в реальном времени. Более того, в средах с плохой сетевой связью или сильными электромагнитными помехами скорость отклика системы может резко снизиться или даже полностью выйти из строя. Кроме того, уязвимости в протоколах облачной связи представляют потенциальные риски для безопасности данных и конфиденциальности в системах машинного зрения [5] .
Для решения проблем задержки и безопасности, возникающих из-за этого разделения, граничные вычисления предлагают уникальные преимущества благодаря своей архитектуре обработки данных вблизи источников. Согласно определению Ши и др. [6], граничные вычисления — это распределенная вычислительная платформа, которая размещает вычисления ближе к источникам данных для обеспечения низкой задержки, высокой надежности и энергоэффективной обработки и принятия решений в реальном времени. Основываясь на этой концепции, исследователи предложили граничный интеллект (EI), который расширяет граничные вычисления от простой передачи и предварительной обработки данных до локального вывода и обучения ИИ [7]. Эта возможность особенно важна для сложных задач машинного зрения, требующих мгновенного принятия решений и автономных действий. Например, в сценариях автономного вождения, даже при сбоях связи, граничные устройства на борту транспортного средства могут независимо выполнять ключевые задачи, такие как обнаружение объектов, планирование траектории и экстренное торможение, тем самым обеспечивая безопасность системы и операционную стабильность.
Если машинное зрение можно рассматривать как «глаза» интеллектуальных систем, то EI функционирует как «мозг», наделяя систему способностью принимать решения и когнитивными способностями. Благодаря этой архитектуре интеграции «глаз-мозг» система может эффективно завершить полный цикл восприятия-принятия-действия на периферии, обеспечивая баланс между производительностью в реальном времени, энергоэффективностью и безопасностью, тем самым закладывая основу для следующего поколения интеллектуальных систем машинного зрения [8] . Такие системы называются системами интеллектуального машинного зрения на периферии (EIMV). Как показано на рис. 1, система EIMV способна выполнять обнаружение, сегментацию, распознавание, отслеживание и классификацию, позволяя интеллектуальным устройствам работать в широком диапазоне передовых областей, включая автономные транспортные средства, интеллектуальное наблюдение, воплощенный интеллект, навигацию ракет, медицинскую диагностику и космические приложения [9], [10], [11].
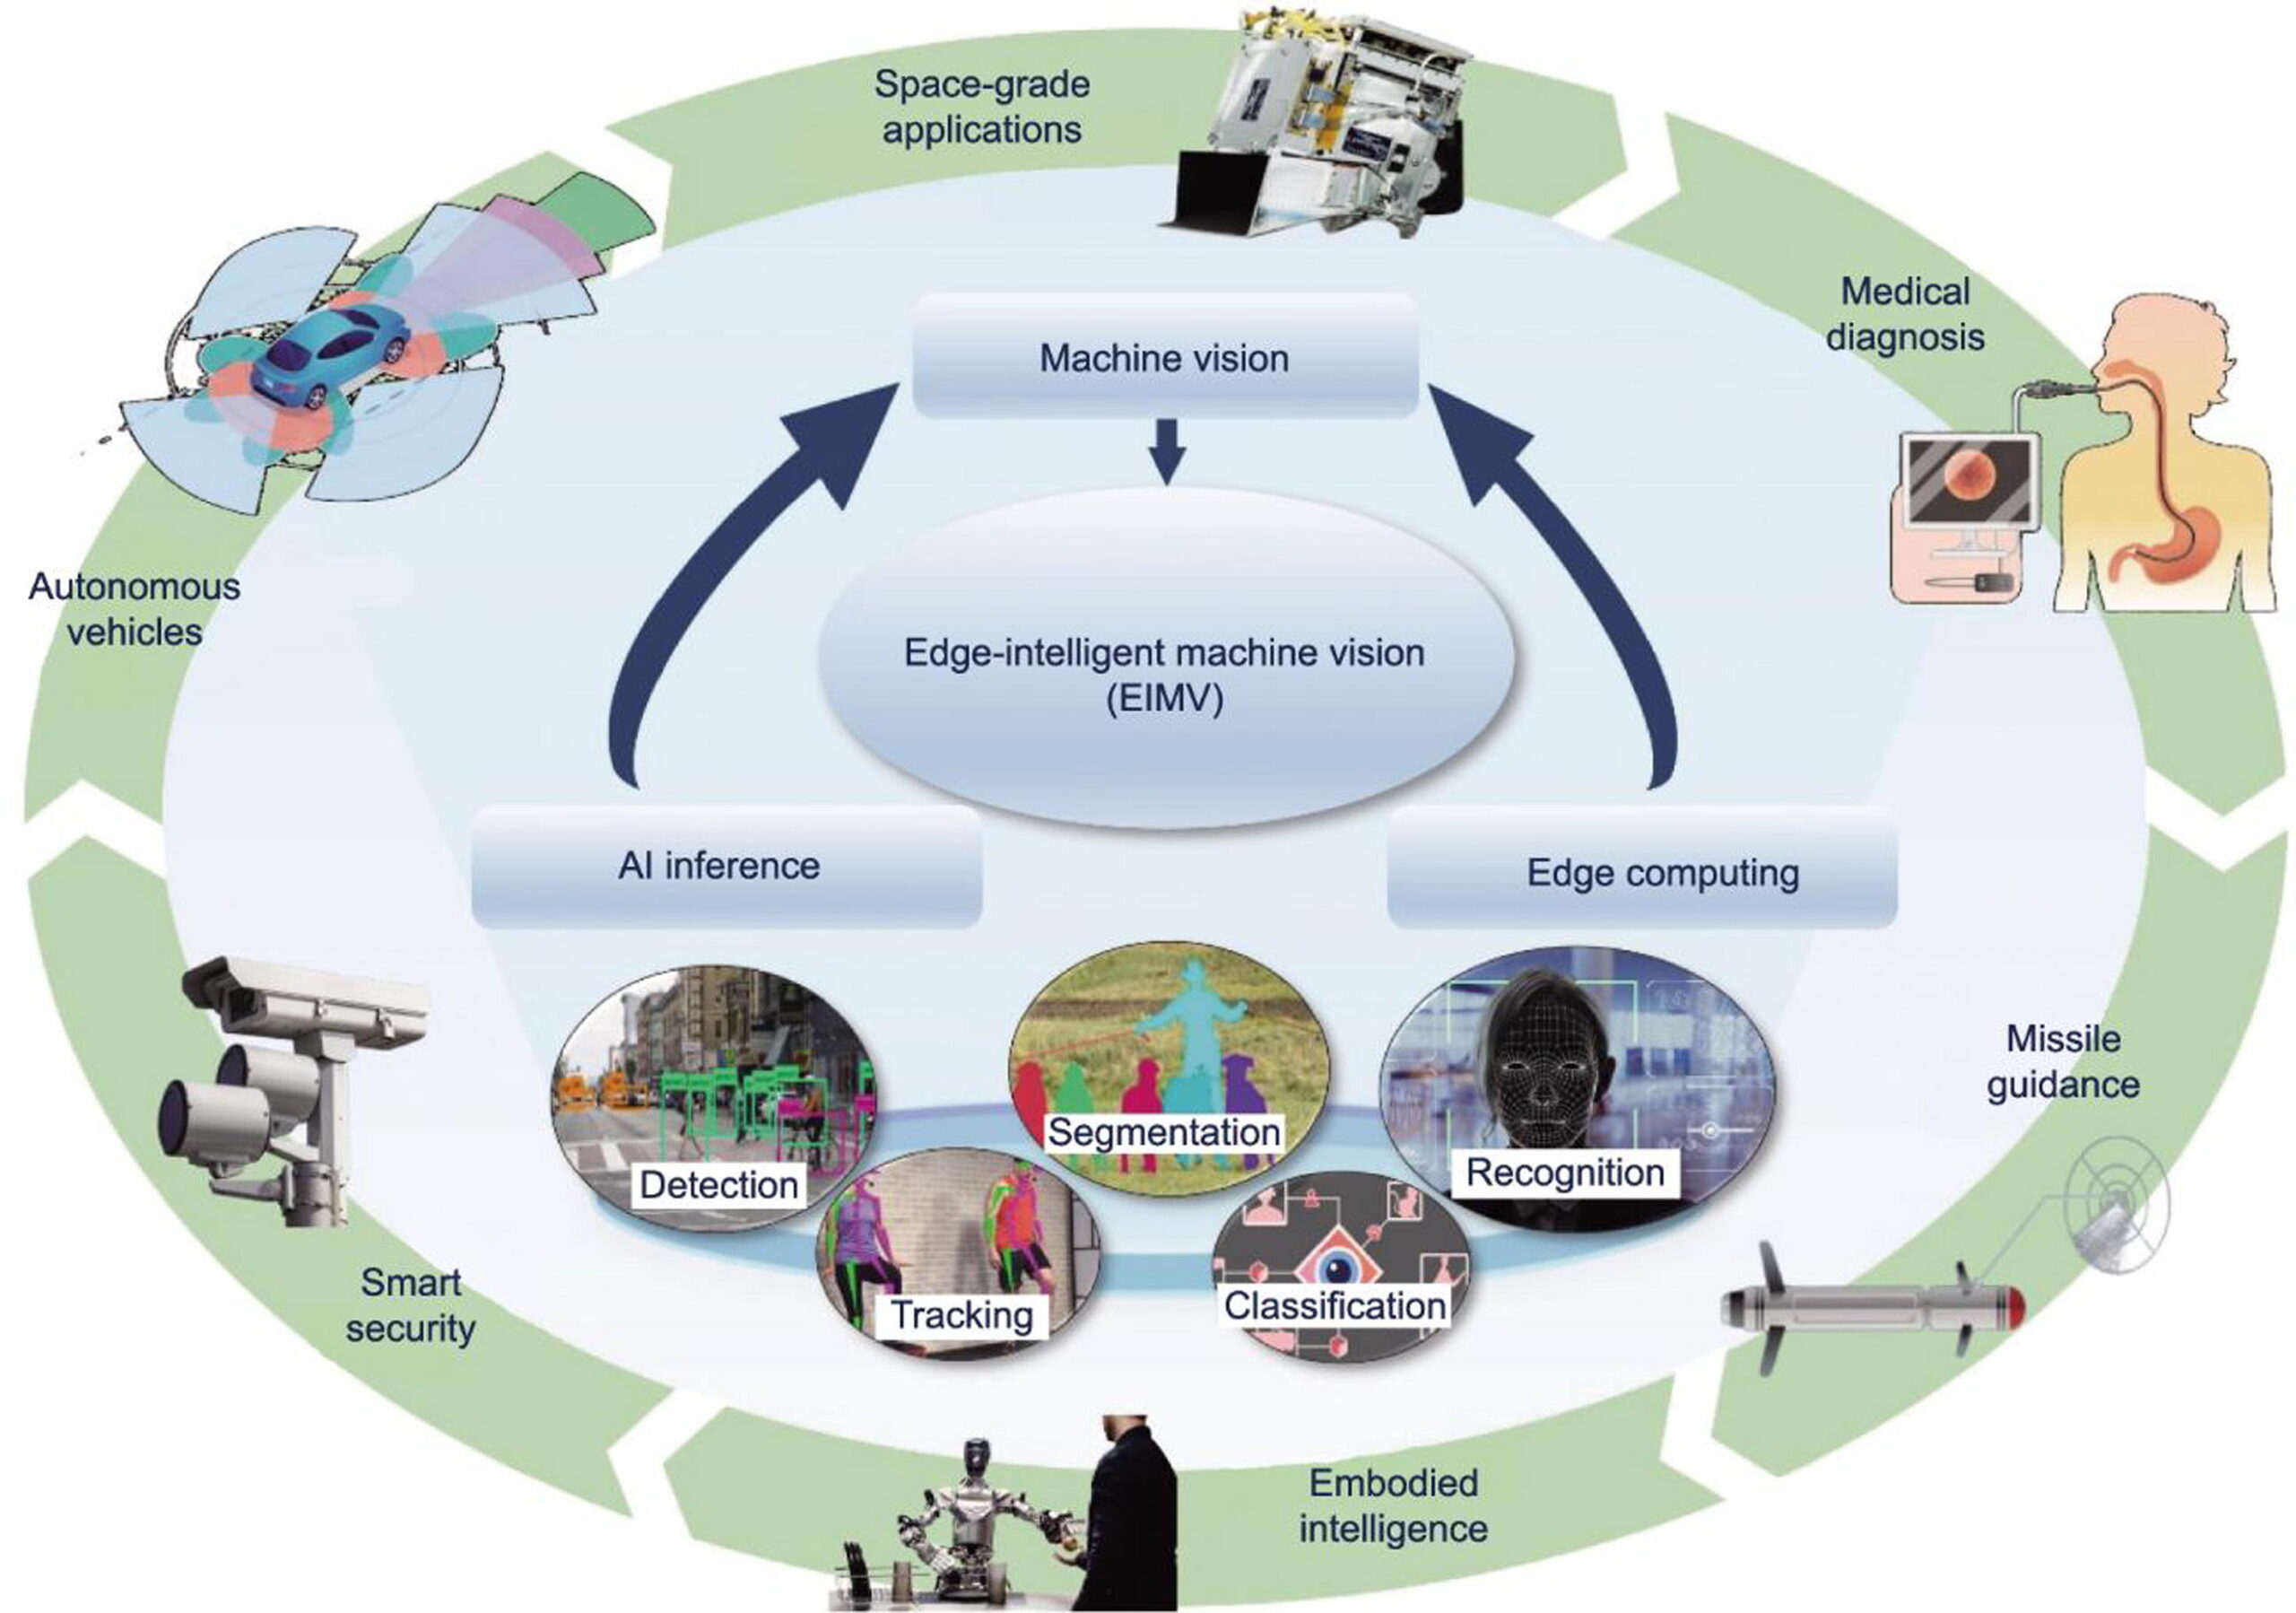
Рис. 1. Интеграция EIMV: слияние машинного зрения и EI обеспечивает визуальное восприятие и принятие решений в реальном времени непосредственно на устройстве. Машинное зрение выполняет ключевые задачи, такие как обнаружение, сегментация, распознавание, отслеживание и классификация, а граничные вычисления обеспечивают низкую задержку и высокую эффективность. Объединенная структура EIMV поддерживает интеллектуальные приложения в автономном вождении, интеллектуальной безопасности, воплощенном интеллекте, медицинской диагностике, наведении ракет и космических приложениях.
Тем не менее, из-за ограниченных ресурсов чипов для граничных вычислений, системы периферийного машинного зрения долгое время были ограничены выполнением базовых задач, таких как коррекция изображений, фильтрация шума или выделение областей интереса (ROI). EI по-прежнему представляет значительные проблемы в обработке больших объемов данных, выводе сложных моделей ИИ и миниатюризации с низким энергопотреблением. Эти проблемы можно суммировать в трех ключевых областях.
1.1. Данные компьютерного зрения, требующие интенсивного хранения.
1.2. Вычислительно-интенсивные модели ИИ
Алгоритмы глубокого обучения, такие как сверточные нейронные сети (CNN) и графические трансформеры (ViT), привели к огромному прогрессу в визуальном восприятии. Однако это улучшение производительности произошло за счет быстрого роста размера модели и вычислительной сложности. Например, ResNet-50 содержит более 25 миллионов параметров и требует более четырех миллиардов операций с плавающей запятой (FLOP) на один вывод [15], в то время как ViT-B превышает 86 миллионов параметров и 17 миллиардов FLOP [16]. Эти огромные вычислительные и запоминающие требования значительно превосходят возможности большинства периферийных устройств, что делает вывод в реальном времени непосредственно на устройстве чрезвычайно сложной задачей.
1.3. Сложное совместное проектирование аппаратного и программного обеспечения.
Современные платформы для граничных вычислений часто используют гетерогенные архитектуры (например, графический процессор (GPU), тензорный процессор (TPU), программируемая пользователем вентильная матрица (FPGA) и специализированная интегральная схема (ASIC)), каждая из которых имеет свои собственные вычислительные модели, иерархии памяти и характеристики энергопотребления. Эффективное выполнение одной модели обработки изображений на этих разнообразных платформах требует оптимизации на уровне оператора, планирования памяти и параллельного проектирования. Кроме того, ограниченная кроссплатформенная совместимость, фрагментированные наборы инструментов разработки и отсутствие единых стандартов совместного проектирования еще больше усложняют развертывание. Для приложений, критически важных с точки зрения задержки, таких как автономное вождение и управление роботами, вопрос о том, как в полной мере использовать потенциал оборудования и минимизировать задержку и энергопотребление, сохраняя при этом точность вывода, остается актуальной проблемой.
Существующие обзоры по этой теме в основном сосредоточены на одном аспекте проблемы, например, на общих фреймворках ИИ на периферии [10], практическом развертывании моделей ИИ [17] или специфическом для ViT сжатии и ускорении [18] . В отличие от них, данная статья направлена на более комплексное исследование последних достижений в области конвергенции машинного зрения и ИИ.
В ней анализируются проблемы развертывания и решения для алгоритмов интеллектуального зрения на аппаратном обеспечении периферийных вычислений, при этом совместно рассматриваются эволюция моделей, совместное проектирование аппаратного и программного обеспечения, гетерогенные периферийные платформы и репрезентативные инженерные приложения в рамках единой ориентированной на EIMV структуры. На примере типичных примеров в статье дополнительно демонстрируется потенциал практического применения этой области. Наконец, рассматриваются будущие направления исследований в области совместной оптимизации аппаратного и программного обеспечения, инноваций в алгоритмах интеллектуального зрения и кроссплатформенной совместимости, подчеркивая важность маломощных, высокопроизводительных и адаптивных алгоритмов для развития систем EIMV.
2. Машинное зрение на периферии сети: задачи, модели и оптимизация.
Благодаря постоянному совершенствованию возможностей периферийных вычислений, область применения машинного зрения на периферии расширилась от простого сбора и передачи данных до многоуровневых задач интеллектуального восприятия и принятия решений. Различные уровни задач машинного зрения и различные модели глубокого обучения существенно различаются по своим требованиям к вычислительным ресурсам, сложности моделей и аппаратным платформам. Поэтому систематическая классификация этих аспектов имеет важное значение.
Как показано на рис. 2 , визуальную обработку на периферии можно анализировать по трем направлениям: задача (анализ сцены), модель (изучение признаков) и оптимизация (упрощение модели). На уровне задачи периферийное зрение охватывает как низкоуровневые задачи улучшения качества изображения, такие как шумоподавление, коррекция и восстановление изображения, так и высокоуровневые задачи семантического анализа, включая обнаружение объектов, семантическую сегментацию и распознавание действий.
На уровне модели ядро опирается на архитектуры глубокого обучения, такие как CNN и ViT, для извлечения дискриминативных и репрезентативных признаков. На уровне оптимизации используются такие методы, как обрезка, квантование и проектирование облегченной архитектуры, чтобы уменьшить вычислительные и запоминающие затраты моделей, обеспечивая их адаптацию к энергоэффективности и ограничениям реального времени периферийных устройств.
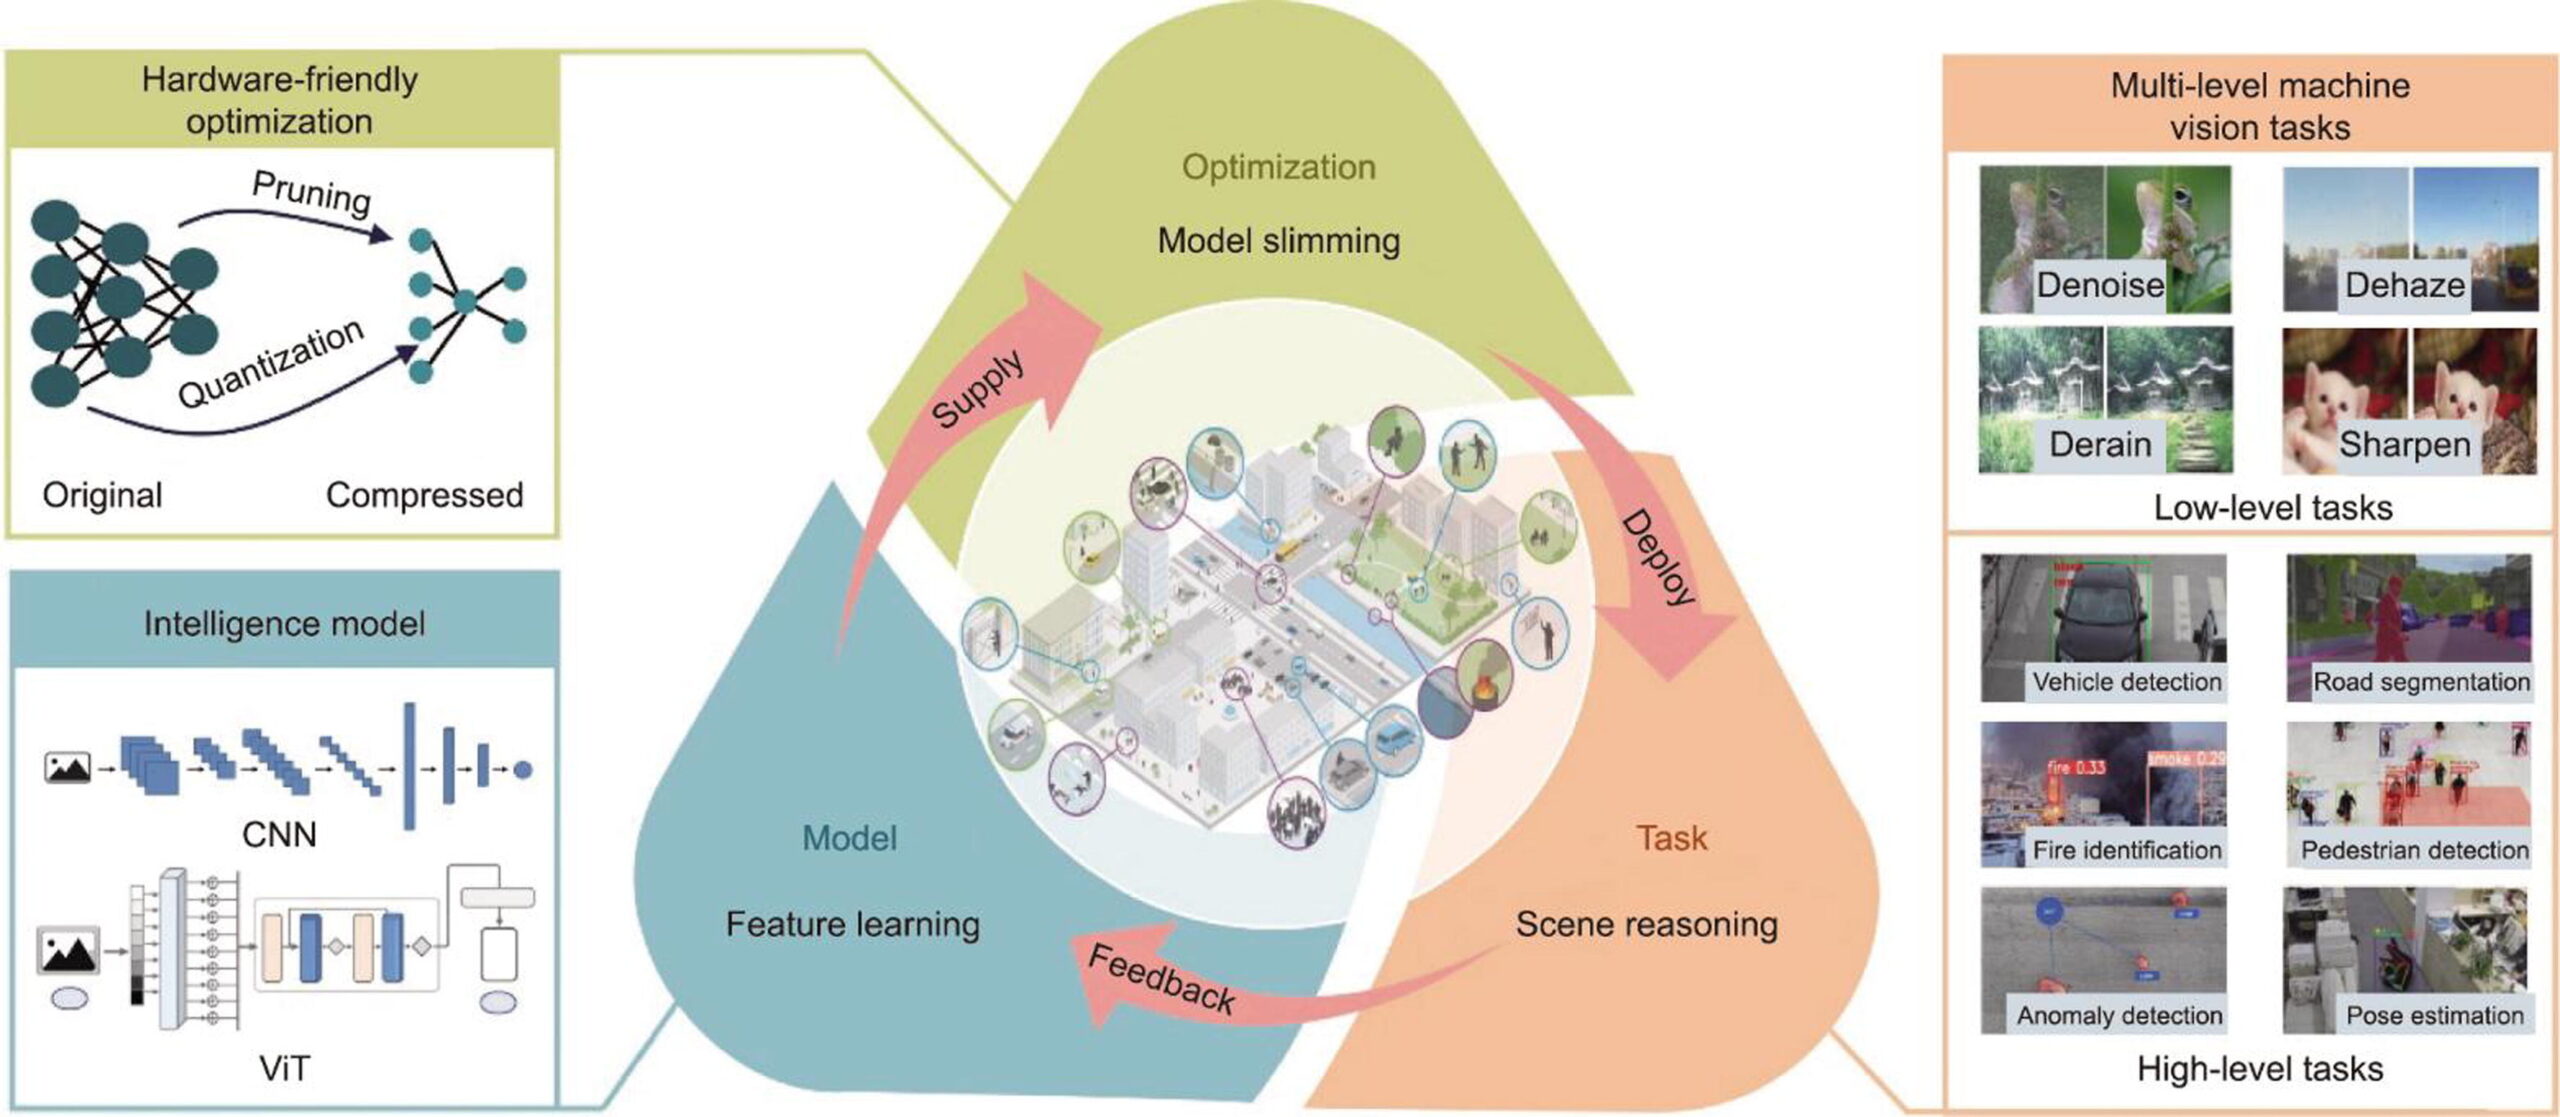
Рис. 2. Обзор EIMV, где обучение признакам, оптимизация модели и анализ сцены взаимодействуют в замкнутом цикле. Модели обеспечивают возможности решения задач, оптимизация гарантирует эффективное развертывание, а требования задачи постоянно стимулируют эволюцию модели и алгоритма.
2.1. Задачи машинного зрения на периферии сети
В этом разделе обобщены типичные задачи обработки изображений на краю экрана, методы, сценарии применения и вычислительные платформы, о которых сообщалось с 2020 года, как показано в таблице 1 [19], [20], [21], [22], [23], [24], [25], [26], [27], [28], [29], [30], [31], [32], [33], [34], [35], [36]. В зависимости от вычислительной сложности эти задачи, как правило, можно разделить на задачи обработки изображений низкого уровня и задачи обработки изображений среднего/высокого уровня [37], [38]. Эта классификация не только помогает уточнить требования к аппаратным ресурсам различных приложений компьютерного зрения, но и предоставляет рекомендации по выбору подходящих алгоритмов и стратегий оптимизации.
Таблица 1. Типичные задачи, методы, сценарии и вычислительные платформы для применения периферийного зрения.
| Категория | Задача (год) | Метод | сценарий на краю | Платформа |
|---|---|---|---|---|
| Низкий уровень | Шумоподавление (2024) [19] | Не DL | Камера дистанционного зондирования | FPGA |
| зрение | Шумоподавление (2022) [21] | Не DL | Видеорегистратор | ASIC |
| Шумоподавление/демозаика (2022) [20] | CNN | процессор обработки изображений | FPGA | |
| Улучшение (2022) [22] | ВИТ | Беспилотный летательный аппарат | Встроенный графический процессор | |
| Исправление (2023) [23] | Не DL | Спутник | Процессор | |
| Исправление (2022) [24] | Не DL | Эндоскоп | FPGA | |
| Извлечение ключевых точек (2022) [25] | CNN | Мобильный робот | FPGA | |
| Дехазе (2023) [27] | Не DL | Камера видеонаблюдения | FPGA/ASIC | |
| Обезлив (2022) [26] | CNN | Автономный транспорт | Встроенный графический процессор | |
| Средний/высокий | Распознавание объектов (2022) [28] | CNN | Смартфон | Процессор |
| уровень зрения | Распознавание объектов (2023) [29] | CNN/ViT | Терминал «умный дом» | Процессор |
| Распознавание объектов (2024) [30] | ВИТ | Терминал распознавания номерных знаков | FPGA | |
| Обнаружение объектов (2024) [31] | CNN | Промышленный робот | ASIC | |
| Обнаружение объектов (2024) [32] | ВИТ | радар с синтезированной апертурой | FPGA | |
| Обнаружение объектов (2022) [33] | CNN | робот-уборщик | Встроенный графический процессор | |
| Отслеживание (2021) [34] | CNN | Автоматизированное транспортное средство | Процессор | |
| Сегментация (2022) [36] | CNN | Автономный транспорт | Встроенный графический процессор | |
| Сегментация (2024) [35] | ВИТ | Медицинский диагностический терминал | Встроенный графический процессор |
Низкоуровневые визуальные задачи сосредоточены на первоначальной обработке изображений или видео, направленной на улучшение качества данных, а не на выполнение семантического анализа. Типичные примеры включают шумоподавление изображений [19], [20], [21], улучшение изображений [22], коррекцию изображений [23], [24], базовое извлечение признаков [25] и повышение контрастности [26], [27].
Вычислительные требования этих задач относительно невелики, поскольку они в основном улучшают качество изображения с точки зрения текстурной и структурной информации. Часто их можно выполнить с помощью традиционных методов, таких как фильтрация или выравнивание гистограммы, которые предъявляют ограниченные требования к вычислительной мощности и хорошо подходят для маломощных центральных процессоров (ЦП) и ПЛИС. Кроме того, процессоры обработки изображений (ISP) на основе ASIC широко используются в интеллектуальных камерах и встроенных системах машинного зрения.
В целом, для решения простых визуальных задач используются зрелые и стабильные алгоритмы, что делает их идеальными для сред с ограниченными ресурсами, где энергоэффективность и производительность в реальном времени имеют первостепенное значение, обеспечивая долгосрочное и стабильное развертывание.
В отличие от задач низкого уровня, которые делают упор на качество изображения, задачи визуального анализа среднего/высокого уровня сосредоточены на семантическом понимании и рассуждениях о сцене. Примерами таких задач являются распознавание объектов [28], [29], [30], обнаружение объектов [31], [32], [33], отслеживание объектов [34] и семантическая сегментация [35], [36]. Эти задачи требуют извлечения сложных и иерархических признаков, опираясь на модели глубокого обучения, такие как CNN и ViT, для достижения точного представления признаков и вывода.
Исторически подобные задачи обычно выполнялись в облаке; однако с развитием аппаратного обеспечения для периферийных вычислений и появлением легковесных архитектур моделей все большее число задач компьютерного зрения среднего и высокого уровня переносится на периферию. Встроенные графические процессоры (EmbeddedGPU) стали наиболее распространенным выбором благодаря их мощным возможностям параллельной обработки, в то время как программируемые логические интегральные схемы (FPGA) часто используются в сценариях, чувствительных к энергопотреблению и стоимости, благодаря своей программируемости и превосходной энергоэффективности. В некоторых случаях сверхлегкие модели могут даже работать на центральных процессорах (CPU), хотя их адаптивность и обобщающая способность, как правило, ограничены.
В целом, задачи визуализации среднего и высокого уровня составляют основную движущую силу эволюции EI, однако их высокая вычислительная сложность предъявляет жесткие требования к оптимизации моделей и совместному проектированию аппаратного и программного обеспечения для эффективного внедрения.
2.2. Модели глубокого обучения на периферии сети
В сценариях граничных вычислений, из-за ограничений вычислительной мощности, хранения и энергетических ресурсов, системы, как правило, используют компактные модели глубокого обучения с меньшими размерами параметров. Хотя эти «легковесные модели» меньше по масштабу, чем большие языковые модели, они все же выполняют основные задачи, такие как понимание, обнаружение и распознавание изображений, выступая в качестве ключевой поддержки для достижения EI [7], [39]. Поэтому, помимо обзора структурной эволюции моделей глубокого обучения, необходимо также изучить, какие семейства моделей подходят для различных ограничений развертывания на граничных условиях.
Структурная эволюция моделей глубокого обучения прошла этапы от локального сверточного моделирования до глобального моделирования внимания. Ранние CNN использовали локальные рецептивные поля, совместное использование весов и операции пулинга для достижения прорывов в классификации изображений, обнаружении объектов и семантической сегментации [40].
Репрезентативные архитектуры, такие как сверточная нейронная сеть Янна ЛеКуна (LeNet), сверточная нейронная сеть Алекса (AlexNet) и сверточные нейронные сети Visual Geometry Group (VGGNet), заложили фундаментальную основу современного компьютерного зрения, обеспечив иерархическую абстракцию от низкоуровневых текстур до высокоуровневой семантики и, таким образом, обучение все более богатым представлениям признаков [41]. С увеличением глубины и ширины сети введение остаточных сетей и плотных сетей эффективно смягчило проблему исчезающего градиента и улучшило повторное использование признаков между слоями, достигнув беспрецедентных уровней точности на крупномасштабных наборах данных, таких как ImageNet [42].
Однако сверточные нейронные сети по своей природе полагаются на фиксированные сверточные ядра для локального восприятия, что делает их неэффективными для захвата зависимостей на больших расстояниях в удаленных пространственных областях. Для преодоления этого ограничения исследователи ввели механизм внимания, который явно моделирует корреляции признаков для повышения способности сети к захвату глобальной информации [43]. Типичные архитектуры, такие как сеть сжатия и возбуждения (SENet) [44] и модуль внимания сверточных блоков (CBAM) [45], интегрируют внимание к каналам и пространству в сверточные признаки, значительно улучшая различимость признаков.
Вдохновленная успехом механизмов самовнимания в обработке естественного языка, архитектура трансформера была адаптирована к визуальным задачам, что привело к разработке ViT [16]. ViT делит изображение на последовательности фрагментов фиксированного размера и использует многоголовочное самовнимание (MHSA) для моделирования зависимостей на больших расстояниях, обеспечивая сквозное визуальное понимание без сверточных операций. Последующие модели, такие как трансформер Swin [46] и пирамидальный визуальный трансформер (PVT) [47], усовершенствовали иерархические конструкции и стратегии разбиения окна, превзойдя традиционные сверточные модели в задачах обнаружения объектов и семантической сегментации.
Несмотря на их высокую репрезентативную способность, трансформеры страдают от квадратичной вычислительной сложности по отношению к разрешению входных данных, что создает серьезные проблемы для развертывания на периферийных устройствах с ограниченными вычислительными и памятьными ресурсами. Для решения этой проблемы в недавних исследованиях изучались гибридные архитектуры, сочетающие сверточные нейронные сети и трансформеры, направленные на баланс между эффективностью локального извлечения признаков и глобальным семантическим моделированием.
Типичными примерами являются Conformer [48] и ConvNeXt [49]. Первый использует параллельные сверточные ветви и механизм самовнимания для достижения взаимодополняющего обучения локально-глобальному представлению, в то время как второй включает в себя основанные на трансформерах схемы нормализации и активации в рамках чисто сверточной структуры, достигая оптимального компромисса между производительностью и эффективностью.
С точки зрения развертывания на периферии сети, различные семейства моделей демонстрируют различные преимущества при разных ограничениях ресурсов. Модели на основе сверточных нейронных сетей (CNN) обычно больше подходят для сценариев со сверхнизкими ограничениями ресурсов, таких как маломощные встроенные камеры, микророботы и потоковые системы на базе FPGA/ASIC, поскольку операции свертки отличаются высокой регулярностью, шаблоны доступа к памяти предсказуемы, а модели проще квантовать и ускорять на аппаратном уровне.
CNN с механизмом внимания, такие как SENet и CBAM, подходят для сценариев с несколько более свободным бюджетом ресурсов, где требуется ограниченное моделирование глобального контекста без введения полной вычислительной нагрузки трансформеров. Чистые трансформерные модели, хотя и сильны в обучении глобального представления, больше подходят для периферийных платформ с относительно более высокими вычислительными возможностями и пропускной способностью памяти, таких как встроенные графические процессоры (GPU) или нейронные процессоры (NPU), особенно когда разрешение входных данных умеренное и доступны квантование или специализированные матричные ускорители.
Гибридные архитектуры CNN-трансформатор часто оказываются выгодными в промежуточных сценариях на периферии сети, где важны как локальная эффективность, так и глобальное моделирование, поскольку они обеспечивают лучший баланс между точностью и стоимостью развертывания. Поэтому выбор архитектуры модели на периферии не должен зависеть исключительно от точности, а должен основываться на типе задачи, целевом показателе задержки, доступной памяти, энергетическом бюджете и возможностях аппаратного ускорения.
2.3. Оптимизация модели с учетом аппаратных возможностей.
Хотя производительность моделей глубокого обучения в задачах компьютерного зрения продолжает улучшаться, эти достижения сопровождаются резким увеличением количества параметров модели и вычислительных требований, что создает серьезные проблемы для вычислительной мощности и энергоэффективности периферийных устройств. Для снижения нагрузки на хранение и вычисления была предложена концепция сжатия модели, целью которой является уменьшение вычислительных и оперативных ресурсов при сохранении репрезентативной способности модели с помощью таких методов, как обрезка, квантование и проектирование облегченной архитектуры [50].
Среди этих методов обрезка снижает вычислительные и логистические требования к модели за счет удаления избыточных параметров или структур, что делает ее одним из самых ранних и широко изученных методов сжатия моделей [51]. Распространенные подходы включают неструктурированную обрезку, которая удаляет отдельные веса на основе величины, и структурированную обрезку, которая удаляет более крупные компоненты, такие как каналы, фильтры или слои [52], [53], [54].
Первый обеспечивает большую гибкость, но менее удобен для аппаратного обеспечения, в то время как второй обеспечивает более низкие коэффициенты сжатия, но позволяет эффективно ускорять работу на аппаратных платформах, таких как FPGA и GPU. В недавних исследованиях были предложены динамическая обрезка и мелкозернистая структурированная обрезка для повышения стабильности и аппаратной адаптивности обрезанных моделей [55]. В целом, обрезка эффективно снижает вычислительную нагрузку и энергопотребление периферийных устройств, сохраняя при этом точность модели.
Квантование снижает требования к хранению и вычислениям за счет уменьшения числовой точности (битовой ширины) параметров и активаций в глубоких нейронных сетях (DNN), тем самым повышая скорость вывода и энергоэффективность. Параметры модели традиционно представляются в виде 32-битных значений с плавающей запятой, но использование низкобитных представлений (например, 8-битных, 4-битных или даже 2-битных) может значительно снизить как затраты на память, так и на вычисления, при этом контролируя снижение точности [56].
С точки зрения аппаратного обеспечения, квантование эффективно не только потому, что уменьшает размер модели, но и потому, что позволяет более эффективно отображать арифметические операторы на специализированные схемы. Например, квантование INT8 позволяет заменить операции умножения-накопления (MAC) с плавающей запятой на операции MAC с фиксированной запятой и целочисленными значениями, которые лучше соответствуют путям передачи данных цифровых сигнальных процессоров (DSP) FPGA и элементов обработки ASIC, тем самым повышая пропускную способность и снижая энергопотребление. В более аппаратно-ориентированных проектах квантование с использованием степени двойки может дополнительно заменить умножения простыми операциями сдвига и сложения, что значительно снижает использование DSP на ПЛИС и повышает параллелизм.
На практике 8-битное квантование успешно применяется в коммерческих платформах для вывода результатов, таких как NVIDIA TensorRT [57] и Intel OpenVINO [58], с минимальной потерей точности. Для 4-битного квантования в большинстве исследований используется постобучение с последующим переобучением для уменьшения снижения точности [59], [60]. Между тем, бинарные нейронные сети (БНН) представляют собой крайнюю форму квантования, сводящую параметры к 1-битным значениям. Однако это часто приводит к значительному снижению точности из-за серьезной потери информации, которую можно лишь частично компенсировать с помощью специализированных стратегий обучения, что ограничивает практическую применимость БНН [61], [62].
В отличие от обрезки и квантования, которые сжимают существующие сети, облегченная конструкция направлена на снижение вычислительной сложности и количества параметров на архитектурном уровне за счет инноваций. Типичным примером является семейство MobileNet, которое заменяет стандартные свертки на свертки с разделяемой глубиной, значительно уменьшая количество операций MAC [63]. Аналогично, ShuffleNet [64], [65] повышает эффективность за счет перемешивания каналов и групповых сверток, сохраняя выразительную мощность при одновременном снижении вычислительной мощности.
В последние годы структурная репараметризация стала перспективным направлением в исследованиях легковесных моделей. Этот метод вводит многоветвевые структуры во время обучения для улучшения изучения признаков; затем многоветвевые структуры объединяются в одну сверточную ветвь во время вывода, что приводит к повышению эффективности работы. Например, Динг и др. [66], [67] предложили преобразовывать многоветвевые сверточные блоки в эквивалентные одиночные свертки 3 × 3, что значительно упрощает графы вывода и улучшает параллелизм оборудования. Аналогично, для трансформерных архитектур подход тензорного разложения и репараметризации для линейных слоев (TDRL) выполняет разложение и репараметризацию низкого ранга на линейных проекционных слоях, существенно снижая вычислительные и запоминающие затраты при сохранении высокой точности в моделях ViT [68] .
Для повышения практической ценности данного обзора в таблице 2 [49], [50] , [51] , [52], [53], [54], [55], [56], [57], [58], [59], [60], [61], [62], [63], [64], [65] [66] представлено более ориентированное на развертывание сравнение репрезентативных стратегий оптимизации моделей, удобных для аппаратного обеспечения, включая обрезку, квантование, облегченную конструкцию и структурную репараметризацию. Вместо простого качественного обобщения этих методов, в таблице указаны типичные потери точности, репрезентативный эффект сжатия или ускорения, а также удобство для аппаратного обеспечения на основе цитируемых исследований. Результаты подчеркивают, что различные стратегии оптимизации приводят к различным компромиссам между точностью модели, сокращением вычислительных затрат и возможностью развертывания на уровне схемы.
Таблица 2. Типичные стратегии оптимизации модели, оптимизирующие работу с оборудованием.
| Категория | Аппаратное обеспечение | Предста-витель | Потеря точности | Эффект | Удобство исполь-зования обору-дования |
|---|---|---|---|---|---|
| Обрезка | Структу-рированная обрезка | [49] | < 1%–2% | 50% обрезка нейронов/фильтров | Высокий |
| Неструкту-рированная обрезка | [50], [51], [52], [53] | < 0,5% | 9-13-кратное уменьшение количества параметров | Низкий | |
| Квантование | 8-битное квантование | [54], [55], [56] | Незна-чительный | 4-кратное сокращение вычисли-тельных ресурсов/памяти | Высокий |
| 4-битное квантование | [57], [58] | 0,5%–4% | 8-кратное сокращение вычисли-тельных ресурсов/памяти | Очень высокий | |
| Бинарное квантование | [59], [60] | > 3% | 20-кратное сокращение вычисли-тельных ресурсов и памяти | Сверхвысокий | |
| Легкая конструкция | MobileNet / ShuffleNet | [61], [62], [63] | Незначительный | В 8–9 раз меньше вычислений | Середина |
| Пере-параметри-зация | RepVGG/TDRL | [64], [65], [66] | Незначительный | — | Высокий |
RepVGG: перепараметризация сверточных нейронных сетей в стиле Visual Geometry Group.
3. Совместная разработка аппаратного и алгоритмического обеспечения для EIMV
В системах EIMV производительность модели тесно связана с базовой аппаратной архитектурой. Возможность модели выполнять вывод в реальном времени определяется не только сложностью ее сетевой структуры, но и ограничена вычислительной мощностью, пропускной способностью памяти и параллельной архитектурой процессора. Для достижения эффективного визуального восприятия в условиях ограничений по мощности и ресурсам периферийных устройств крайне важно создать механизм совместной оптимизации между алгоритмами и оборудованием, позволяющий моделям в полной мере использовать вычислительный потенциал чипа.
Как показано на рис. 3 , развертывание визуальных моделей на периферии сети обычно основано на многоуровневой гетерогенной архитектуре. От процессоров общего назначения (ЦП и ГП) до специализированных или реконфигурируемых схем (ПЛИС и ASIC) различные платформы демонстрируют разные компромиссы между гибкостью и энергоэффективностью. Процессоры общего назначения обеспечивают быстрое развертывание и многозадачный параллелизм, в то время как специализированные ускорители достигают исключительно высокой энергоэффективности за счет таких методов, как конвейерный параллелизм и повторное использование оборудования. Поэтому в этом разделе основное внимание уделяется двум основным аспектам периферийных визуальных вычислений: аппаратным чипам на периферии и аппаратному ускорению для моделей ИИ.
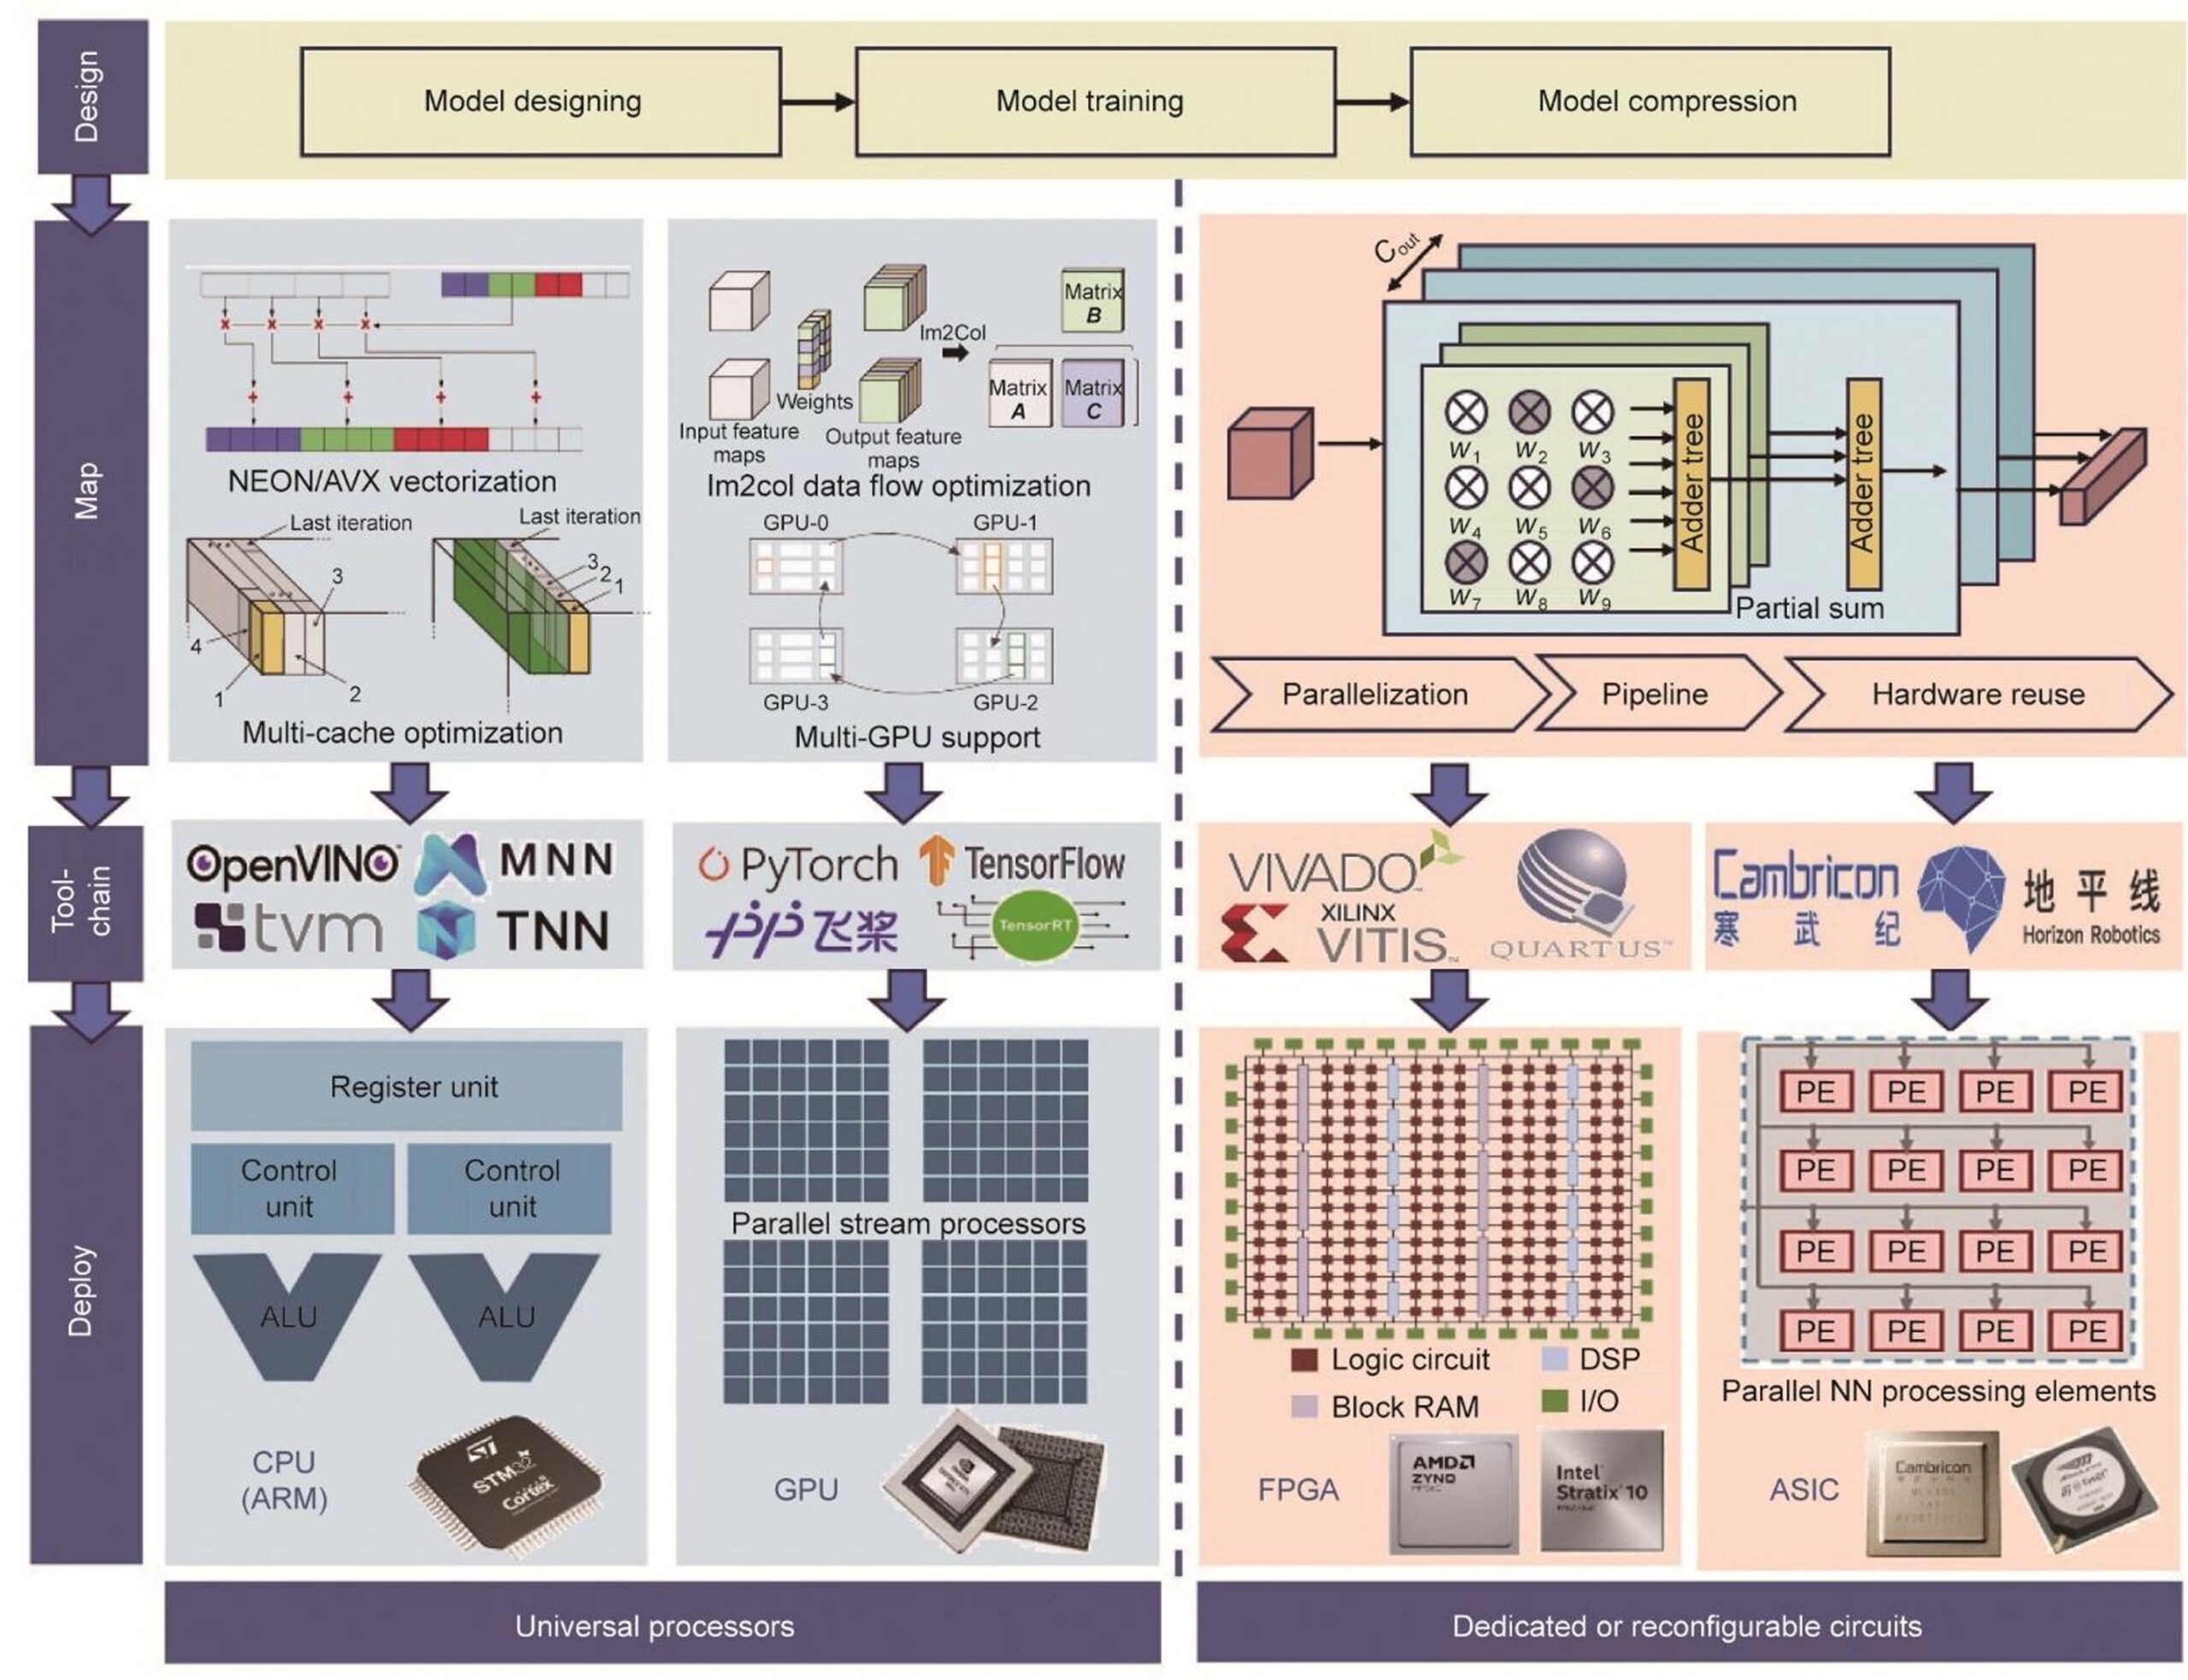
Рис. 3. Обзор гетерогенных фреймворков развертывания для периферийных визуальных вычислений. Рабочий процесс иллюстрирует, как модели машинного зрения преобразуются от этапов алгоритмического проектирования и сжатия к развертыванию на аппаратном уровне, на универсальных процессорах (ЦП и ГП) и реконфигурируемых или специализированных схемах (ПЛИС и ASIC). ARM: усовершенствованная вычислительная машина с сокращенным набором инструкций; PE: обрабатывающий элемент; NN: нейронная сеть; I/O: ввод/вывод; RAM: оперативная память; ALU: арифметико-логическое устройство; AVX: расширенные векторные расширения; NEON: новый движок для объектов следующего поколения. C out : количество выходных каналов; w 1 – w 9 : вес 1–вес 9.
3.1. Аппаратные микросхемы на периферии
В настоящее время вычислительные чипы, подходящие для EIMV, можно условно разделить на два типа: универсальные процессоры и реконфигурируемые или специализированные схемы. Эти два класса дополняют друг друга с точки зрения вычислительной мощности, энергоэффективности, гибкости и цикла разработки, обеспечивая разнообразную аппаратную поддержку для различных уровней задач визуализации.
Как показано в таблице 3, к универсальным процессорам относятся в основном цифровые сигнальные процессоры (DSP), центральные процессоры (CPU) и графические процессоры (GPU).
Таблица 3. Типичные аппаратные микросхемы, подходящие для вычислений в области машинного зрения на периферии сети.
| Категория | Аппаратное обеспечение | Плат-формы | Год выпуска | Узел процесса | Вычисли-тельная мощность | Поставщик |
|---|---|---|---|---|---|---|
| Универ-сальные Процес-соры | ДСП | C7x | 2020 | 16 нм | 0.3 TOPS (FP32) | ТИ |
| Hexagon780 | 2021 | 5 нм | 26 ТОПОВ | Квалкомм | ||
| Процессор (ARM) | Cortex A725 | 2024 | 3 нм | — | РУКА | |
| П550 | 2021 | 7 нм | — | SiFive | ||
| Встроенный графический процессор | Mali G725 | 2024 | 4 нм | 2 TOPS (FP32) | РУКА | |
| Адрено 830 | 2024 | 3 нм | 3 TOPS (FP32) | Квалкомм | ||
| Tegra T234 | 2022 | 8 нм | 4.1 TOPS (FP32) | Nvidia | ||
| FPGA | VC1902 | 2021 | 7 нм | 3.2 TOPS (FP32) | AMD (Xilinx) | |
| Агилекс7 | 2022 | 10 нм | 57 TOPS (INT8) | Intel (Altera) | ||
| Переконфи-гурируемые и настра-иваемые схемы | НПУ | Краевой ТПУ | 2018 | 16 нм | 4 TOPS (INT8) | |
| Этос-U85 | 2024 | — | 4 ТОПА | РУКА | ||
| ARC NPX6 | 2022 | 5 нм | 11 ТОПОВ | Синопсис | ||
| НейПро-М | 2023 | 3 нм | 4 ТОПА | Сева | ||
| Специа-лизиро-ванная ASIC – система | EyeQ | 2022 | 7 нм | 34 TOPS (INT8) | Intel (Mobileye) | |
| ФСД | 2019 | 14 нм | 122 ТОПСА | Тесла | ||
| Drive OrinX | 2022 | — | 254 ТОПСА | Nvidia | ||
| Journey6P | 2025 | 6 нм | 560 ТОПОВ | Horizon Robotics |
- а Отображает только вычислительную мощность одноядерного процессора.
Цифровые сигнальные процессоры (DSP) хорошо известны своей эффективностью в выполнении ресурсоемких численных задач, благодаря выделенным арифметическим блокам, оптимизированным для преобразований Фурье, свертки и фильтрации. Они широко использовались в ранних приложениях обработки изображений и предварительной обработки компьютерных данных. К числу таких продуктов относятся TDA4VM от Texas Instruments (серии C7x/C66x) и Hexagon 780 от Qualcomm. Однако по мере роста сложности алгоритмов и быстрого развития универсальных/параллельных процессоров DSP постепенно были заменены центральными процессорами (CPU) и графическими процессорами (GPU) как по вычислительной мощности, так и по универсальности.
Современные гетерогенные системы на кристалле (SoC) постепенно вытесняют автономные архитектуры DSP. Например, в серии I.MX9 от NXP больше не интегрирован DSP, а вместо этого используются гетерогенные многоядерные процессоры для обработки различных рабочих нагрузок. Эти тенденции привели к значительному снижению доли автономных микросхем DSP на рынке.
Будучи универсальным вычислительным ядром, ЦП предлагает превосходную гибкость и развитую экосистему разработки, что делает его подходящим для небольших задач обработки изображений или задач, не требующих обработки в реальном времени. Однако его последовательная структура обработки ограничивает эффективность в ресурсоемких задачах визуализации, таких как свертка и умножение матриц. В периферийных системах в качестве управляющих ядер обычно используются маломощные ЦП на базе архитектуры ARM (Archive), делегирующие основные вычисления графическим процессорам или специализированным ускорителям. В последние годы процессоры на базе архитектуры RISC-V (например, SiFive P550) улучшили параллельную производительность за счет векторных расширений, тем самым повысив эффективность обработки изображений на периферии.
Графические процессоры (GPU) разработаны с использованием большого количества параллельных тензорных ядер и превосходно справляются с матричными и тензорными вычислениями, что делает их незаменимыми для ускорения глубокого обучения. Однако настольные графические процессоры, как правило, непригодны для периферийных вычислений из-за высокого энергопотребления и громоздких размеров. Для решения этой проблемы появились встроенные графические процессоры для сценариев с низким энергопотреблением. Например, серия NVIDIA Tegra T23X, широко используемая в платформах Jetson Orin, поддерживает приложения для робототехники, дронов и интеллектуальных камер. По сравнению с настольными графическими процессорами (> 100 тераопераций в секунду (TOPS)), встроенные графические процессоры обычно обеспечивают менее 10 TOPS, достигая благоприятного баланса между производительностью, энергоэффективностью и плотностью интеграции.
Хотя эти универсальные процессоры могут напрямую применяться в периферийных системах машинного зрения, их универсальная конструкция часто приводит к избыточным затратам энергии, площади и стоимости, оставляя значительный простор для оптимизации. Следовательно, реконфигурируемые и специализированные схемы часто превосходят их в приложениях, ориентированных на конкретные задачи.
FPGA являются ярким примером реконфигурируемых схем. Они обладают реконфигурируемой логической архитектурой, которая может ускорять сверточные и матричные операции на аппаратном уровне в параллельном режиме, обеспечивая оптимальный баланс между производительностью и энергоэффективностью. Их таблицы поиска (LUT) и программируемые межсоединения позволяют выполнять конвейерные и параллельные операции, что делает их очень подходящими для вывода результатов глубокого обучения и других ресурсоемких задач компьютерного зрения. По мере роста сложности моделей производители FPGA постоянно модернизируют свои вычислительные модули. Например, AMD (Xilinx) представила архитектуру AI Engine в своей серии Versal, обеспечивающую ускорение глубокого обучения на кристалле для интеллектуальных приложений компьютерного зрения на периферии сети.
В категории специализированных микросхем одним из основных классов являются чипы-ускорители для обработки данных в рамках искусственного интеллекта (ИИ) или нейронные процессоры (NPU). Google Edge TPU — это типичный продукт, разработанный специально для обработки данных в задачах машинного зрения на периферии сети. Он обеспечивает производительность 4 TOPS при энергопотреблении всего 0,5 Вт на TOPS. Ускоритель состоит из двумерного (2D) массива процессорных элементов (PE), где каждый PE содержит одно или несколько ядер, и каждое ядро поддерживает несколько параллельных вычислительных каналов. Аналогичным образом, ARM, Synopsys и Ceva представили масштабируемые IP-блоки NPU, предлагающие производительность от 4 TOPS до нескольких сотен TOPS, которые могут быть сконфигурированы в соответствии с ограничениями по энергопотреблению и стоимости периферийных устройств.
Другой формой специализированной схемотехники является специализированная ASIC, разработанная для комплексной оптимизации конкретных задач визуального восприятия и принятия решений. В таких областях, как автономное вождение и интеллектуальная робототехника, эти чипы стали ключевыми элементами практического визуального восприятия. Как указано в таблице 2 [49], [50], [51], [52], [53], [54 ], [55], [56], [57], [ 58], [59], [60], [61], [62] [63], [64], [65], [66] , серия Mobileye EyeQ широко используется в автомобильном зрении с 2004 года . Новейшая модель EyeQ6 Pro, изготовленная по 7-нм техпроцессу, обеспечивает вычислительную мощность 34 TOPS (INT8) и поддерживает синхронную обработку нескольких камер и ускорение глубокого обучения.
Собственный чип Tesla для полностью автономного вождения (FSD), созданный по 14-нм технологии, обеспечивает производительность обработки данных в 144 TOPS благодаря двойной резервированной архитектуре для повышения безопасности. NVIDIA Drive OrinX, комплексный процессор восприятия и планирования для продвинутого автономного вождения, объединяет модули GPU, CPU и ускорителя глубокого обучения (DLA), обеспечивая общую вычислительную мощность более 250 TOPS. Journey 6P от Horizon Robotics, изготовленный по 6-нм технологии, обеспечивает производительность 560 TOPS и широко используется в отечественных системах автономного вождения и сервисной робототехнике.
По сравнению с основными универсальными нейронными процессорами (NPU), специализированные ASIC-чипы архитектурно адаптированы к целевым приложениям, что позволяет глубоко настраивать планирование потоков данных, внутрикристальные межсоединения и механизмы безопасности. Это позволяет им достигать сверхвысокой энергоэффективности и производительности в реальном времени, адаптированной к конкретным задачам. Появление специализированных чипов, ориентированных на конкретные задачи, свидетельствует о сдвиге в области интеллектуальной обработки данных от универсального ускорения к интеграции на уровне приложений, предоставляя новую исследовательскую платформу для совместной оптимизации алгоритмов компьютерного зрения и аппаратного обеспечения в интеллектуальных системах следующего поколения.
Помимо аппаратных возможностей, выбор инструментария разработки критически влияет на практическую применимость моделей EIMV. Типичные фреймворки, такие как NVIDIA TensorRT, Intel OpenVINO, Apache TVM и специализированные потоки FPGA, различаются по поддержке операторов, возможностям квантования, оптимизации графов и кроссплатформенной переносимости.
TensorRT широко используется для вывода на основе графических процессоров, предлагая высокооптимизированное выполнение сверточных нейронных сетей и моделей трансформеров с низкой задержкой. OpenVINO предоставляет зрелый рабочий процесс для процессоров Intel, интегрированных графических процессоров и блоков обработки изображений (VPU) с мощной поддержкой оптимизации INT8 и импорта предварительно обученных моделей.
TVM обеспечивает кроссплатформенную оптимизацию и автоматическую настройку на основе компилятора для гетерогенного оборудования, что позволяет гибко развертывать модели на периферийных устройствах. Потоки, ориентированные на FPGA (например, Vitis AI), предлагают тонкий контроль над потоком данных и энергоэффективностью, но требуют более специфичной для оборудования настройки. Учитывая как аппаратные характеристики, так и особенности инструментария, разработчики могут лучше сбалансировать скорость, точность и энергоэффективность обработки данных в реальных условиях развертывания на периферии сети.
3.2. Аппаратное ускорение для моделей ИИ
Основная цель технологии аппаратного ускорения для моделей периферийных вычислений в области машинного зрения — решение проблемы развертывания и ускорения ресурсоемких и требующих большого объема памяти алгоритмов глубокого обучения на периферийных чипах с ограниченными ресурсами. В этом разделе будут представлены типичные методы ускорения для универсальных вычислительных платформ и специализированных/реконфигурируемых схем.
3.2.1. Модели ускорения для вычислительных платформ общего назначения (CPU/GPU)
Хотя центральные процессоры обладают ограниченной вычислительной мощностью, а графические процессоры страдают от относительно высокого энергопотребления, что ограничивает их использование в периферийных устройствах, оба остаются ключевыми вычислительными платформами для систем периферийного зрения благодаря зрелым программным экосистемам и широкой аппаратной совместимости [17]. В отличие от специализированных схем, эти универсальные платформы не могут быть структурно модифицированы на аппаратном уровне; таким образом, оптимизация их производительности в основном зависит от совместной настройки алгоритма и системы. В условиях ограниченного вычислительного и энергетического бюджета главной задачей является максимизация использования ресурсов и минимизация задержки вывода и энергопотребления в существующих архитектурах чипов [69] .
На вычислительном уровне распараллеливание и векторизация имеют решающее значение для повышения производительности ЦП/ГП. Современные ЦП поддерживают механизмы SIMD (одна инструкция — несколько данных) и SIMT (одна инструкция — несколько потоков) — такие как ARM NEON, AVX-512 и RISC-V V-расширение — которые могут выполнять несколько операций с пикселями или матрицами за цикл. Преобразование сверток или матричных умножений в общую форму матрично-матричного умножения (GEMM) и применение векторизованных ядер может значительно повысить пропускную способность и коэффициент попадания в кэш. Распространенные методы включают разбиение ядер на блоки, развертывание циклов и перестановку весов, которые повышают эффективность оператора без увеличения сложности оборудования [70]. В отличие от них, ГП используют массовый параллелизм за счет тысяч блоков потоков и общей памяти. Исследователи оптимизировали доступ к глобальной памяти с помощью разделения блоков потоков, синхронизации на уровне варпов и повторного использования регистров, тем самым увеличивая параллелизм сверток и пропускную способность [18] . Особенно в маломощных графических процессорах такие методы, как адаптивное мозаичное размещение и повторное использование общей памяти, доказали свою эффективность в снижении задержки доступа к памяти и повышении энергоэффективности [71].
На системном уровне оптимизация памяти и кэша имеет одинаково важное значение. Из-за ограниченной емкости кэша на кристалле в периферийных устройствах задержка памяти часто становится доминирующим узким местом. Для решения этой проблемы были предложены удобные для кэша схемы размещения данных и стратегии предварительной выборки. Для ЦП такие методы, как блокировка и предварительная выборка, удерживают активные данные в кэше L1/L2, минимизируя доступ к основной памяти [17]. На графических процессорах явное управление общей памятью в сочетании с повторным использованием данных и предотвращением конфликтов банков памяти обеспечивает эффективную межпотоковую связь при ограниченном энергопотреблении [72] .
В заключение, хотя центральные и графические процессоры не предназначены специально для обработки изображений на периферии сети, благодаря параллельной/векторизованной оптимизации, планированию кэша и координации на уровне компилятора они могут обеспечить практический баланс между гибкостью и энергоэффективностью, что делает их хорошо подходящими для быстро развивающихся алгоритмов и часто обновляемых моделей в приложениях обработки изображений на периферии сети.
3.2.2 . Модели ускорения для специализированных/реконфигурируемых схем (FPGA/ASIC)
Аппаратное ускорение на специализированных (ASIC) и реконфигурируемых (FPGA) схемах в основном сосредоточено на оптимизации на архитектурном уровне. Используя такие механизмы, как конвейеризация, аппаратный параллелизм, повторное использование оборудования и временное мультиплексирование, эти разработки направлены на повышение вычислительной пропускной способности и энергоэффективности глубоких моделей на периферийных устройствах с ограниченными ресурсами [73]. В отличие от процессоров общего назначения и графических процессоров, которые в значительной степени полагаются на оптимизацию на уровне компилятора, FPGA и ASIC могут напрямую настраивать пути передачи данных и вычислительные блоки на аппаратном уровне, достигая значительных преимуществ в задержке и энергопотреблении для развертывания задач [74].
С архитектурной точки зрения, DLA обычно подразделяются на конструкции на основе линейных буферов и на основе систолических массивов. Архитектура линейного буфера выполняет свертку конвейерным образом, кэшируя последовательные строки изображения на кристалле, что позволяет данным непрерывно передаваться между этапами вычислений. Она может выдавать один пиксель за такт, обеспечивая предсказуемую задержку и низкие накладные расходы на доступ к памяти при высокой пропускной способности [75], [76]. Такие архитектуры хорошо подходят для визуальных задач с фиксированными размерами ядра или стабильными шаблонами скользящего окна. В отличие от этого, архитектура систолического массива отображает операции свертки в крупномасштабные матричные умножения посредством перестановки im2col, выполняя высокоскоростные операции MAC по двумерному массиву PE. Этот подход обеспечивает высокую масштабируемость и программируемость, поддерживая различные размеры ядра и межслойный параллелизм, но он также вносит дополнительные накладные расходы на перестановку данных и доступ к памяти [77], [78]. Ниже более подробно описаны конструкции DLA на основе линейного буфера и систолического массива.
(1) Архитектура на основе линейного буфера. Линейный буфер — это эффективный и структурно простой метод ускорения. Свертка, по сути, выполняет взвешенное суммирование по локальному рецептивному полю карты признаков входных данных. Если бы каждая операция свертки считывала полный входной блок из внешней или большой встроенной памяти, пропускная способность памяти быстро стала бы узким местом, значительно снижая общую пропускную способность. Линейный буфер решает эту проблему, поддерживая на кристалле скользящее окно на уровне строк, что обеспечивает высокую степень повторного использования данных и значительно снижает нагрузку на доступ к памяти [79] .
Как показано на рис. 4 [80] , рассмотрим вход размером N × N (один канал) и ядро 3 × 3, где N — размер ширины и высоты входного изображения. Система выделяет два буфера строк размером 1 × N (первый входящий, первый исходящий) для хранения первых двух входящих строк. По мере поступления потока изображений построчно, пиксели сначала попадают в буфер строк 1; после заполнения данные каскадно передаются в буфер строк 2. Тем временем выходы входного потока, буфера строк 1 и буфера строк 2 подключены к трем массивам сдвиговых регистров. После заполнения буфера строк 2 девять регистров из этих трех путей образуют полное скользящее окно 3 × 3. Это окно сдвигается на один пиксель вправо каждый тактовый цикл по мере поступления новых пикселей, генерируя локальные сверточные фрагменты без какого-либо дополнительного доступа к внешней памяти.
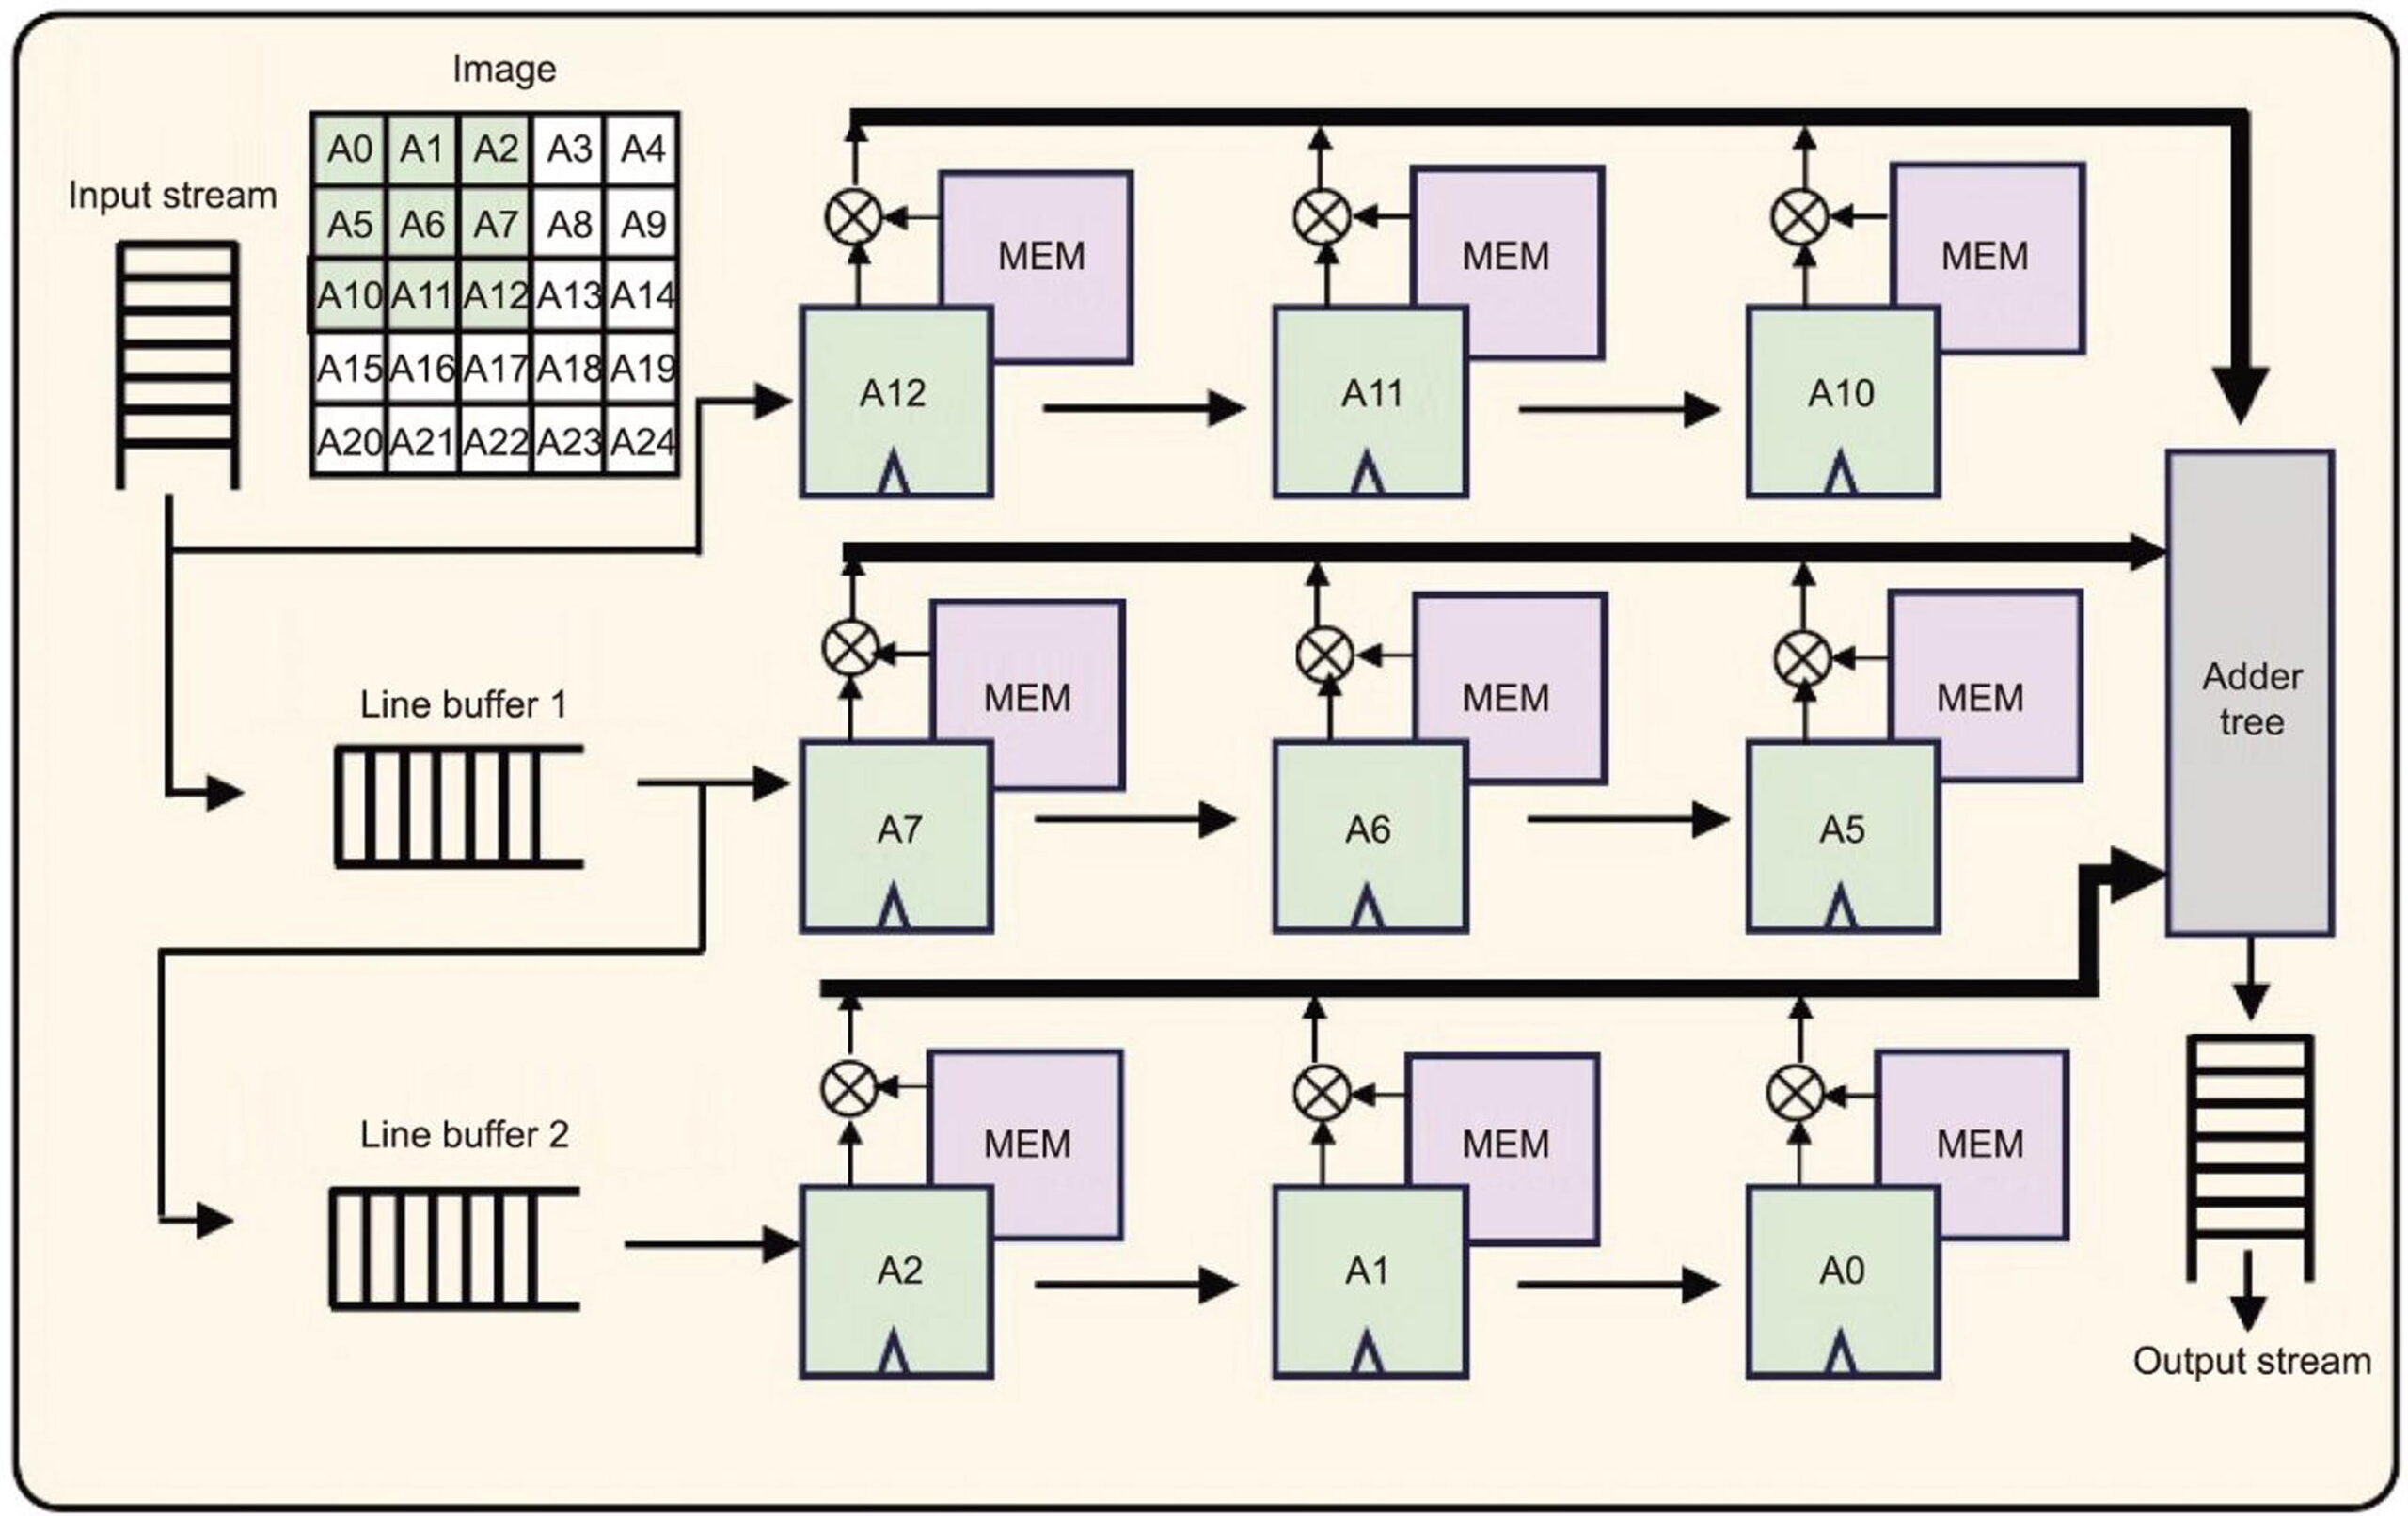
Рис. 4. Блок обработки свертки 3 × 3 на основе двух линейных буферов. A0–A24: индекс пикселя; MEM: фиксированные веса свертки. Воспроизведено из ссылки [80] с разрешения.
В этом тракте данных веса ядра предварительно сохраняются в локальных регистрах. Девять пикселей в окне умножаются параллельно на соответствующие веса ядра, а их произведения суммируются с помощью дерева сумматоров, в результате чего за один такт получается один результат свертки. За исключением задержки, связанной с начальным заполнением буфера, все вычисления выполняются в полностью конвейерном режиме, обеспечивая стабильную пропускную способность и детерминированную задержку.
Благодаря кэшированию смежных строк изображения на чипе, линейный буфер позволяет генерировать окно свертки с минимальным доступом к памяти, что принципиально улучшает повторное использование данных и одновременно снижает внечиповую пропускную способность. Его аппаратная структура является легкой, а логика управления — простой, без зависимости от сложной координации вычислений. Поэтому он особенно подходит для небольших CNN, сверток с фиксированным ядром и потоковых входных данных в реальном времени (например, данные линейной сканирующей камеры), часто встречающихся на периферийных устройствах, обеспечивая энергоэффективное решение для сверточных вычислений для периферийных развертываний [81].
(2) Архитектура на основе систолических массивов. Как в CNN, так и в архитектурах трансформеров, прямой вывод включает в себя огромные операции GEMM. В результате пропускная способность и энергоэффективность матричных вычислений становятся критическими узкими местами для периферийного оборудования. Систолические массивы решают эту проблему, организуя процессоры в пространственно регулярный массив и координируя перемещение данных вдоль фиксированных направлений, тем самым обеспечивая высокую степень повторного использования данных и значительно снижая накладные расходы на доступ к памяти.
Типичная архитектура систолического массива — впервые использованная в Google TPU v1 [77] — предварительно загружает правую матрицу (веса) в регистры PE, следуя потоку данных, стационарному по весам (WS), в то время как левая матрица (активации) поступает в массив построчно. Каждый PE хранит регистр весов, регистр активаций, регистр частичных сумм и регистр управления и выполняет операции MAC через умножитель и сумматор. Во время вычислений веса распространяются вертикально, активации — горизонтально, а частичные суммы накапливаются по диагонали массива. После заполнения конвейера каждый PE работает параллельно, и массив может выдавать новый набор результатов в каждом цикле. С массивом PE размером 256 × 256 TPU v1 может выдавать 256 результатов за цикл, демонстрируя чрезвычайно высокую вычислительную плотность.
Поскольку свертку можно преобразовать в матричное умножение с помощью техники im2col, и поскольку полносвязные слои по своей природе являются матричными умножениями, систолические массивы широко используются для ускорения CNN [82] . Для дальнейшего использования локальности, специфичной для свертки, исследователи разработали оптимизированные потоки данных. Ускоритель Eyeriss, предложенный Массачусетским технологическим институтом (MIT) и Стэнфордским университетом [73], использует стратегию пространственного отображения, в которой сверточные ядра распространяются горизонтально, карты признаков распространяются по диагоналям, а частичные суммы распространяются вертикально, максимизируя повторное использование данных и уменьшая доступ к динамической оперативной памяти (DRAM). Последующие работы были сосредоточены на увеличении пропускной способности и уменьшении накладных расходов на переупорядочивание данных [78] , закрепив систолические массивы в качестве доминирующей архитектуры для современных ускорителей CNN.
Модели трансформеров состоят из блоков внимания и блоков многослойного перцептрона (MLP), в обоих случаях преобладают операции GEMM, что делает их одинаково подходящими для ускорения с помощью систолических массивов. Для обработки нерегулярных форм матриц и многоголовочных размеров в самомовнимании в недавних исследованиях были разработаны специализированные систолические архитектуры. Групповой векторный систолический массив, предложенный в 2023 году, ускоряет как обычный GEMM, так и многоголовочное внимание, достигая задержки вывода в 4,077 мс на ViT-tiny с использованием FPGA ZCU102 [83]. Структура кооперативных систолических массивов (COSA) дополнительно поддерживает настраиваемые во время выполнения гибридные потоки данных с стационарными весами (WS) и стационарными выходами (OS), обеспечивая гибкое ускорение для различных матричных умножений, связанных с вниманием [84].
В целом, систолические массивы — отличающиеся структурированными потоками данных, параллелизмом вычислений и высокой масштабируемостью — стали одной из наиболее перспективных аппаратных архитектур для ускорения работы как сверточных нейронных сетей (CNN), так и трансформеров на периферийных устройствах. Благодаря постоянным инновациям в потоках данных, специфичных для сверток и механизмов внимания, ожидается, что систолические массивы останутся ключевым компонентом будущих интеллектуальных чипов для периферийных устройств.
Поскольку архитектуры на основе трансформаторов стали основным направлением в современных задачах компьютерного зрения, мы дополнительно включили сравнительную таблицу, обобщающую типичные реализации трансформаторных ускорителей. Для обеспечения всестороннего инженерного обзора трансформаторного ускорения, в таблице 4 [85], [86], [87], [88], [89], [90], [ 91], [92], [93] обобщены типичные ускорители FPGA и ASIC для ViT, представленные в последние годы (2022–2026). В таблице указаны аппаратная платформа, целевая модель, численная точность, рабочая частота, энергопотребление и измеренная пропускная способность (гигаопераций в секунду (GOPS)), что подчеркивает компромиссы между производительностью, энергоэффективностью и точностью модели. Выбранные работы охватывают ряд стратегий проектирования, включая квантование смешанных схем, оптимизацию внимания с низким битом и проектирование конвейеров с учетом ресурсов, иллюстрируя текущие отраслевые тенденции в развертывании высокопроизводительных ViT с низкой задержкой на периферийных устройствах.
Таблица 4. Типичные стратегии сжатия моделей, оптимальные для аппаратного обеспечения.
| Произведения (год) | Платформа | Модель | Точность | Частота (МГц) | Мощность (Вт) | Пропускная способность (GOPS) |
|---|---|---|---|---|---|---|
| AutoViT [85] (2022) | ZCU102 | DeiT-B | Смешан-ный | 150 | 10.3 | 1418.4 |
| ВиА [86] (2022) | Альвео U50 | Свин-Т | Float16 | 300 | 39.0 | 309.6 |
| ViTCoD [87] (2023) | ASIC | DeiT-B | / | 500 | 0.3 | 256.0 |
| ViTA [88] (2024) | ASIC | ВИТ | INT8 | 200 | 0.2 | 204.8 |
| EQViT [89] (2024) | Альвео U250 | DeiT-T | INT8 | 250 | 80.6 | — |
| DRViT [90] (2025) | Альвео U250 | ВИТ-Т | INT8 | 140 | 34.1 | 1380.8 |
| HG-PIPE [91] (2024) | ZCU102 | DeiT-T | INT4 | 375 | 21.9 | 3947.5 |
| РЕАТА [92] (2026) | VCK5000 | DeiT-T | INT8 | 1250 | 56.1 | 26302.0 |
| LUT-ViT [93] (2025) | ZCU102 | DeiT-B | Смешан-ный | 150 | 6.5 | 1597.2 |
3.3. Совместное развертывание и планирование ресурсов в практических системах EIMV
Несмотря на существенный прогресс в ускорении отдельных моделей обработки изображений на ЦП, ГП, ПЛИС и ASIC, практические системы EIMV редко организуются вокруг одной изолированной задачи вывода. Вместо этого они обычно включают в себя несколько тесно связанных этапов, включая сбор данных, предварительную обработку, вывод, постобработку, передачу и локальное принятие решений, особенно в сценариях наблюдения, интеллектуального транспорта и робототехники [94].
В реальных условиях развертывания один граничный узел может одновременно поддерживать обнаружение объектов, отслеживание, анализ событий и управление потоками данных, что создает конкуренцию за вычислительные ресурсы, объем памяти, кэш-память и внекристальную пропускную способность. Более того, эти задачи часто имеют разные требования к времени выполнения: ветви обработки информации, связанные с безопасностью, обычно критически важны с точки зрения задержки, в то время как логирование, облачная синхронизация и долгосрочная аналитика могут допускать относительно большие задержки. Такая неоднородность делает наивное или статическое планирование неэффективным и в некоторых случаях может значительно ухудшить производительность в реальном времени.
Для решения этой проблемы в недавних исследованиях начали изучаться методы планирования во время выполнения, адаптированные для параллельных конвейеров вывода на периферийных устройствах. Перейра и др. [95] исследовали многопоточное планирование конвейеров вывода на маломощных периферийных графических процессорах и показали, что ручное совместное планирование нескольких конвейеров при ограничениях пропускной способности и памяти представляет собой сложную задачу. Они также предложили планировщик на основе глубокого обучения с подкреплением для определения времени начала операций на разных уровнях конвейера, улучшив задержку, планируемость и эффективность использования памяти по сравнению с базовыми методами. Этот результат предполагает, что в практических системах EIMV эффективность развертывания зависит не только от сжатия модели или аппаратного ускорения, но и от того, может ли система во время выполнения координировать перекрывающиеся конвейеры вывода с учетом ресурсов.
Помимо локального планирования, межустройственное взаимодействие дополнительно повышает эффективность системы. Чжан и др. [96] представили CrossVision, распределенную структуру для анализа видео в реальном времени с камер, которая использует перекрывающиеся области ROI между соседними камерами для уменьшения избыточной обработки и балансировки рабочей нагрузки. Сохраняя все необработанные визуальные данные на камерах и координируя вывод, CrossVision уменьшает задержку и поддерживает точность. Это демонстрирует, что организация задач на уровне графа между узлами может быть столь же важна, как и локальное аппаратное ускорение.
Взаимодействие облака и периферии — еще одна ключевая стратегия для сверхсложных сценариев, в которых чисто периферийного выполнения недостаточно. Нан и др. [97] предложили архитектуру непрерывного обучения с поддержкой облака, в которой периферия выполняет легковесный вывод, в то время как облако обрабатывает более сложную адаптацию модели и глобальный анализ. Адаптивные фреймворки для разделения DNN, такие как PARTNNer, динамически определяют, какие задачи или слои следует перенести в облако, чтобы минимизировать сквозную задержку при изменяющихся сетевых условиях и нагрузке облака [98] . В этой парадигме чувствительное к задержке восприятие остается на устройстве, в то время как ресурсоемкие или не относящиеся к реальному времени задачи — такие как глобальная агрегация, переобучение или уточнение сцены — могут быть перенесены. Таким образом, разделение и планирование задач определяются требованиями уровня приложения и ограничениями реального времени, а не только вычислительной мощностью.
В промышленных условиях Цзи и др. [99] продемонстрировали, что решения о переносе задач, оптимизированные с помощью улучшенных глубоких Q -сетей, могут дополнительно сбалансировать задержку, точность и использование ресурсов для совместного анализа видео на периферии и в облаке, подчеркивая цели планирования, ориентированные на приложения. В совокупности эти исследования показывают, что совместная оптимизация на системном уровне, сочетающая локальное планирование, межустройственное взаимодействие и адаптивное разделение периферии и облака, имеет решающее значение для масштабируемого развертывания EIMV в реальном времени [94].
В целом, системы EIMV переходят от изолированного ускорения моделей к совместной оптимизации моделей, конвейеров обработки данных, устройств и каналов связи, обеспечивая более реалистичный путь к стабильному, малозадержечному и масштабируемому интеллектуальному компьютерному зрению в реальном времени на периферии сети в сложных приложениях.
4. Типичные области применения EIMV
Периферийные вычисления все чаще используются в машинном зрении, стимулируя инновации и повышая эффективность во многих отраслях. Ниже приводится обсуждение нескольких типичных примеров применения и соответствующих исследований.
4.1. Подключенные и автономные транспортные средства
Благодаря стремительному развитию машинного зрения, глубокого обучения и сенсорных технологий, автомобили превратились из традиционных средств передвижения в интеллектуальные вычислительные платформы, способные к восприятию, принятию решений и обучению. Эти системы, объединяющие связь, восприятие и управление, в совокупности известны как подключенные и автономные транспортные средства (CAV).
Как показано на рис. 5, беспилотные автомобили используют многосенсорное объединение данных, включая данные лидара (LiDAR), камер, радара и датчиков скорости/вала, для сбора информации об окружающей среде, которая затем обрабатывается локально на платформах периферийных вычислений, таких как NVIDIA DRIVE Thor. Это позволяет параллельно выполнять множество визуальных задач, включая навигацию при парковке, обнаружение транспортных средств и мониторинг водителя, — все это внутри автомобиля.
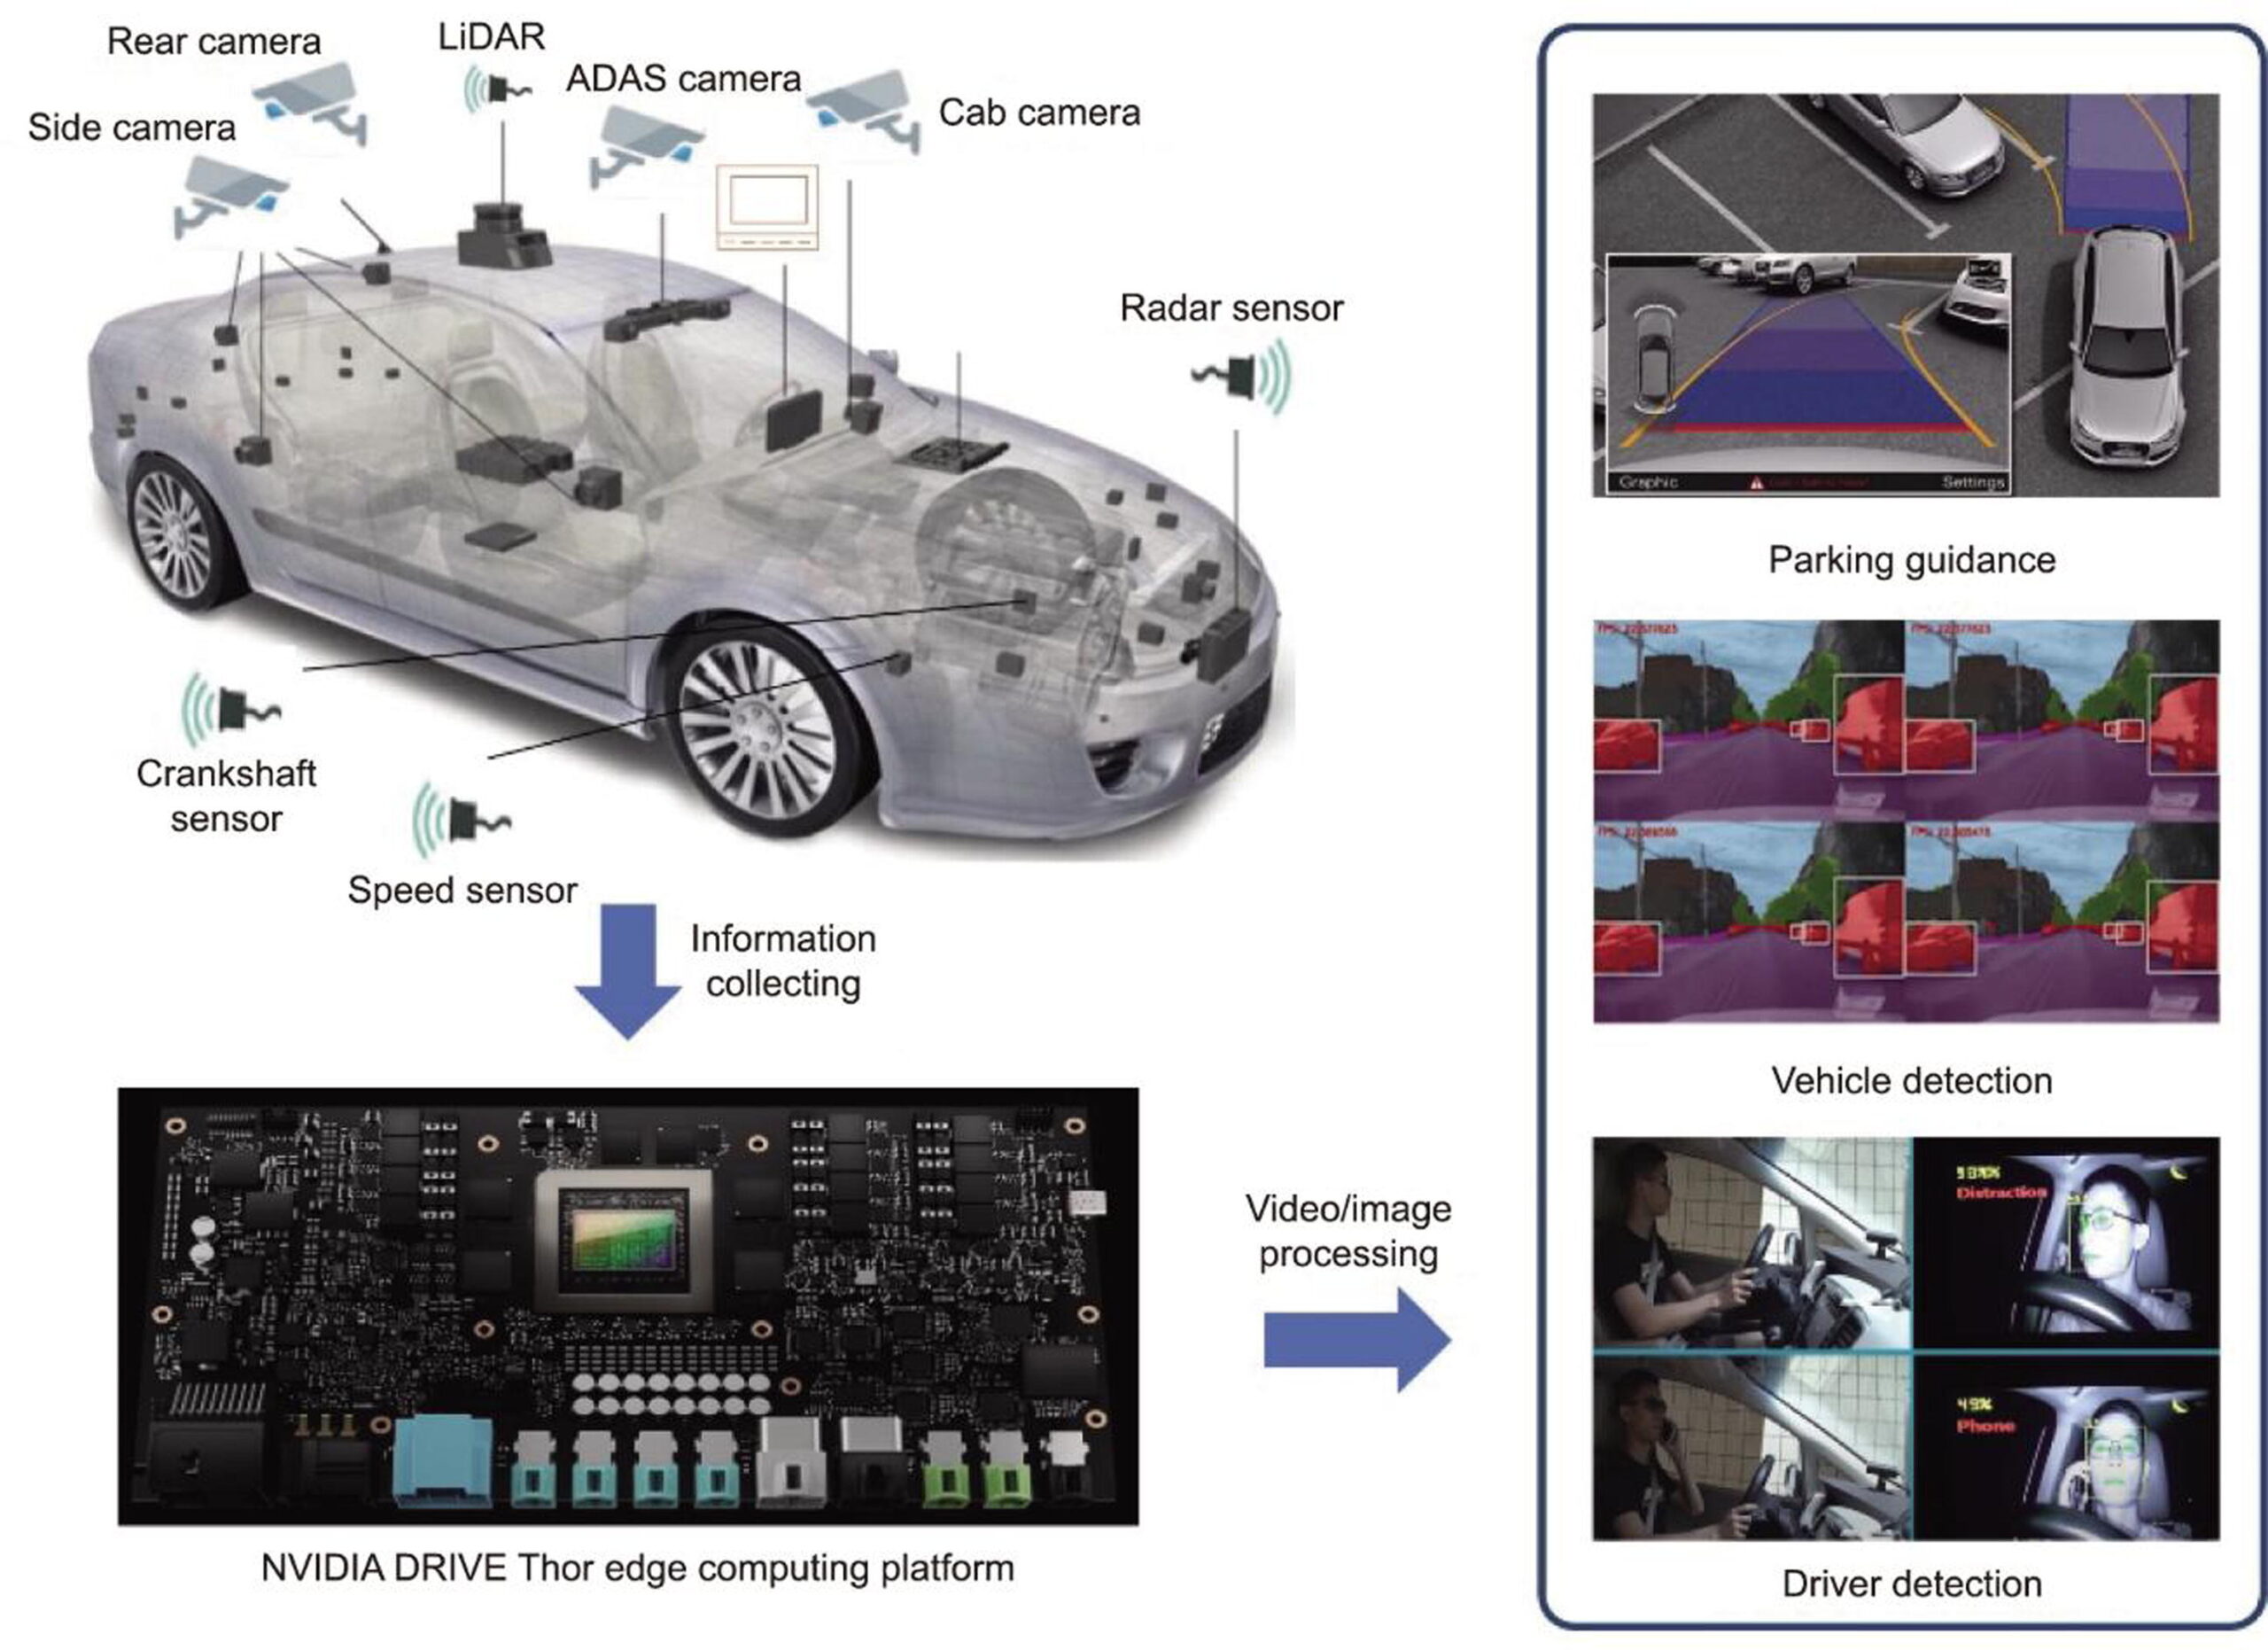
Рис. 5. Платформа NVIDIA DRIVE Thor используется для бортовых вычислений в автомобиле для решения таких задач, как сбор информации и обнаружение целей. ADAS: усовершенствованная система помощи водителю.
Еще в 2016 году в отчете Intel [100] указывалось, что один автономный автомобиль может генерировать 4 ТБ данных в день. К 2022 году в отчете Samsung [101] прогнозировалось, что при более высоком уровне автоматизации, увеличении количества датчиков и более высоком разрешении автономный автомобиль сможет производить до 40 ТБ данных в час. Учитывая ограничения пропускной способности связи и безопасности данных, такие огромные объемы данных не могут быть полностью переданы в облако. Следовательно, бортовые вычислительные блоки должны обладать достаточными возможностями хранения и вычислений в режиме реального времени.
Автономная система вождения обычно включает три основных модуля: восприятие окружающей среды, планирование решений и выполнение управления. На этапе восприятия используются многочисленные визуальные датчики, такие как камеры и LiDAR, для получения исчерпывающей информации об окружающей среде вокруг транспортного средства [102]. Затем объединенные данные датчиков вводятся в модели зрения для обнаружения или сегментации объектов, пешеходов и разделительных полос, обеспечивая критически важную информацию для последующих модулей принятия решений и управления.
В настоящее время алгоритмы визуального восприятия для автономного вождения можно разделить на многомодульные конвейеры и большие многомодальные модели. Многомодульные конвейеры объединяют несколько специализированных моделей и обладают высокой интерпретируемостью, что облегчает отслеживание ошибок и отладку. Большие многомодальные модели обеспечивают мощные возможности принятия решений от начала до конца, интегрируя датчики и управление в единую структуру [103]. Независимо от парадигмы, по мере роста сложности алгоритмов адекватное вычислительное оборудование становится необходимым для достижения производительности вывода в реальном времени.
В промышленной сфере было разработано множество вычислительных платформ, специально предназначенных для приложений CAV. В 2015 году NVIDIA выпустила платформу SoC DRIVE PX для приложений усовершенствованных систем помощи водителю (ADAS), за которой последовали последующие поколения, включая DRIVE PX2 (2017), DRIVE PX Xavier (2017), DRIVE PX Pegasus (2017), DRIVE AGX Orin (2019) и DRIVE Thor (2021) [104]. Поддерживаемый уровень автономности этих платформ постепенно повышался со 2-го уровня до 4-го и 5-го, при этом основные обновления были сосредоточены на расширении количества ядер унифицированной вычислительной архитектуры устройств (CUDA) для поддержки все более сложных моделей машинного зрения.
Предстоящая платформа DRIVE Thor, построенная на основе новейших архитектур CPU и GPU от NVIDIA, может обеспечить производительность в 2 петало-операции с плавающей запятой в секунду (PFLOPS) — или 2000 TOPS — и является первой автомобильной платформой, которая изначально поддерживает алгоритмы ИИ на основе трансформеров. Этот пример демонстрирует эволюцию восприятия автономного вождения от традиционных архитектур на основе CNN к многомодальным базовым моделям. Несколько автопроизводителей, включая BYD, Xpeng, Zeekr и Li Auto, объявили о планах внедрения DRIVE Thor в свои системы автономного вождения следующего поколения [105].
Что касается FPGA, то серия Xilinx Zynq UltraScale+ ZCU104/106 представляет собой платформы для граничных вычислений автомобильного класса. Например, ZCU104, сочетающая гетерогенную архитектуру FPGA + ARM, обеспечивает гибкую масштабируемость и минимизирует энергопотребление, сохраняя при этом полную функциональность. При выполнении задач CNN она достигает производительности 14 изображений·(с·Вт)−1, превосходя графический процессор Tesla K40 (4 изображения·(с·Вт) −1). Для задач отслеживания объектов она может обрабатывать видеопотоки 1080p в реальном времени со скоростью 60 кадров в секунду (fps) [106].
Помимо основных платформ граничных вычислений, появилось несколько специализированных поставщиков решений, которые интегрируют алгоритмы обработки изображений с граничным оборудованием. Например, компания Light Company разрабатывает недорогие многокамерные массивы различных размеров для построения трехмерных (3D) карт окружающей среды с использованием стереоскопического зрения в качестве альтернативы дорогостоящим и ограниченным по дальности системам LiDAR. Каждая камера включает в себя объективы с разным фокусным расстоянием, а ее алгоритм стереоскопического зрения, реализованный на FPGA, генерирует до 95 миллионов точек в секунду. По данным компании, в будущих версиях будет осуществлен переход от развертывания на основе FPGA к развертыванию на основе ASIC для повышения эффективности [107].
Компания Mobileye, еще один лидер отрасли, представила первую в мире интеллектуальную систему помощи при превышении скорости (ISA), основанную исключительно на визуальном восприятии, для производителей оригинального оборудования автомобилей (OEM). Это решение, основанное только на камере и запущенное в серийные автомобили в 2023 году, обеспечивает соответствие новому Общему регламенту безопасности Европейского союза (ЕС), который предписывает автоматическое определение ограничений скорости без использования карт третьих сторон или данных глобальной системы позиционирования (GPS) [108].
В целом, эти разработки демонстрируют четкую технологическую траекторию: автономные транспортные средства эволюционируют в интеллектуальные системы машинного зрения, где объединение данных с нескольких датчиков, вычисления в реальном времени непосредственно в транспортном средстве и совместное проектирование аппаратного и программного обеспечения являются краеугольными камнями архитектур беспилотных автомобилей следующего поколения.
4.2. Интеллектуальные системы мониторинга
Интеллектуальные системы видеонаблюдения, предназначенные для мониторинга и оптимизации транспортного потока и повышения общественной безопасности, становятся неотъемлемой частью современной городской инфраструктуры. Эти системы обеспечивают функции обнаружения в реальном времени, такие как распознавание номерных знаков, распознавание лиц и обнаружение аномалий, что позволяет им выявлять и реагировать на потенциальные угрозы безопасности или преступную деятельность [109] .
В области мониторинга и управления дорожным движением достижение анализа видео в реальном времени и с высокой точностью остается одной из главных задач. Традиционные системы видеонаблюдения часто используют архитектуру взаимодействия «облако-периферия», в которой множество камер непрерывно захватывают видеопотоки на периферии и загружают их на облачные серверы, где алгоритмы обнаружения выявляют нарушения правил дорожного движения, вторжения и другие аномальные события. Однако по мере быстрого увеличения количества камер, возникающий взрывной рост объема данных создает узкие места в передаче и обработке данных на стороне облака [110].
Для решения этой проблемы исследователи все чаще переносят задачи видеоаналитики на периферийные узлы, что позволяет выполнять локальную предварительную обработку изображений, удаление избыточных кадров или обнаружение объектов для снижения нагрузки на облако, экономии полосы пропускания и улучшения времени отклика системы. Например, Никодем и др. [111] разработали облегченную специализированную нейронную сеть размером всего 16 МБ для классификации транспортных средств (мотоциклов, легковых автомобилей, автобусов, полуприцепов, грузовиков и прицепов). Развернутая в системах видеонаблюдения, она работает с максимальным энергопотреблением 20 Вт в течение почти 24 часов, что делает ее подходящей для сценариев мониторинга дорог с низким энергопотреблением. Аналогично, Ван и др. [112] предложили модель обнаружения амплитуды движения на основе пространственно-временных точек интереса (STIP) с многомодальным линейным слиянием признаков для сегментации информативных последовательностей кадров из непрерывных видеозаписей дорожного движения. Затем они применили усеченную сеть YOLOv3 для покадрового обнаружения, достигнув эффективного распознавания транспортных средств на периферийных узлах.
Как показано на рис. 6, камера Hikvision DS-2TD2166-15 AI представляет собой промышленную систему интеллектуального наблюдения на периферии. Она обладает возможностями анализа поведения на устройстве, используя алгоритмы глубокого обучения для обнаружения вторжений, пересечения границ и мониторинга региональных входов/выходов ( рис. 6 (b)). Разбор аппаратной части показывает, что для управления датчиком изображения используется FPGA Intel Cyclone V, оснащенная флэш-памятью Micron и синхронной динамической оперативной памятью (SDRAM) для буферизации изображений, в то время как процессор обработки изображений Intel Movidius MA2450 (VPU) выполняет вывод ИИ на устройстве [113] ( рис. 6 (c)).
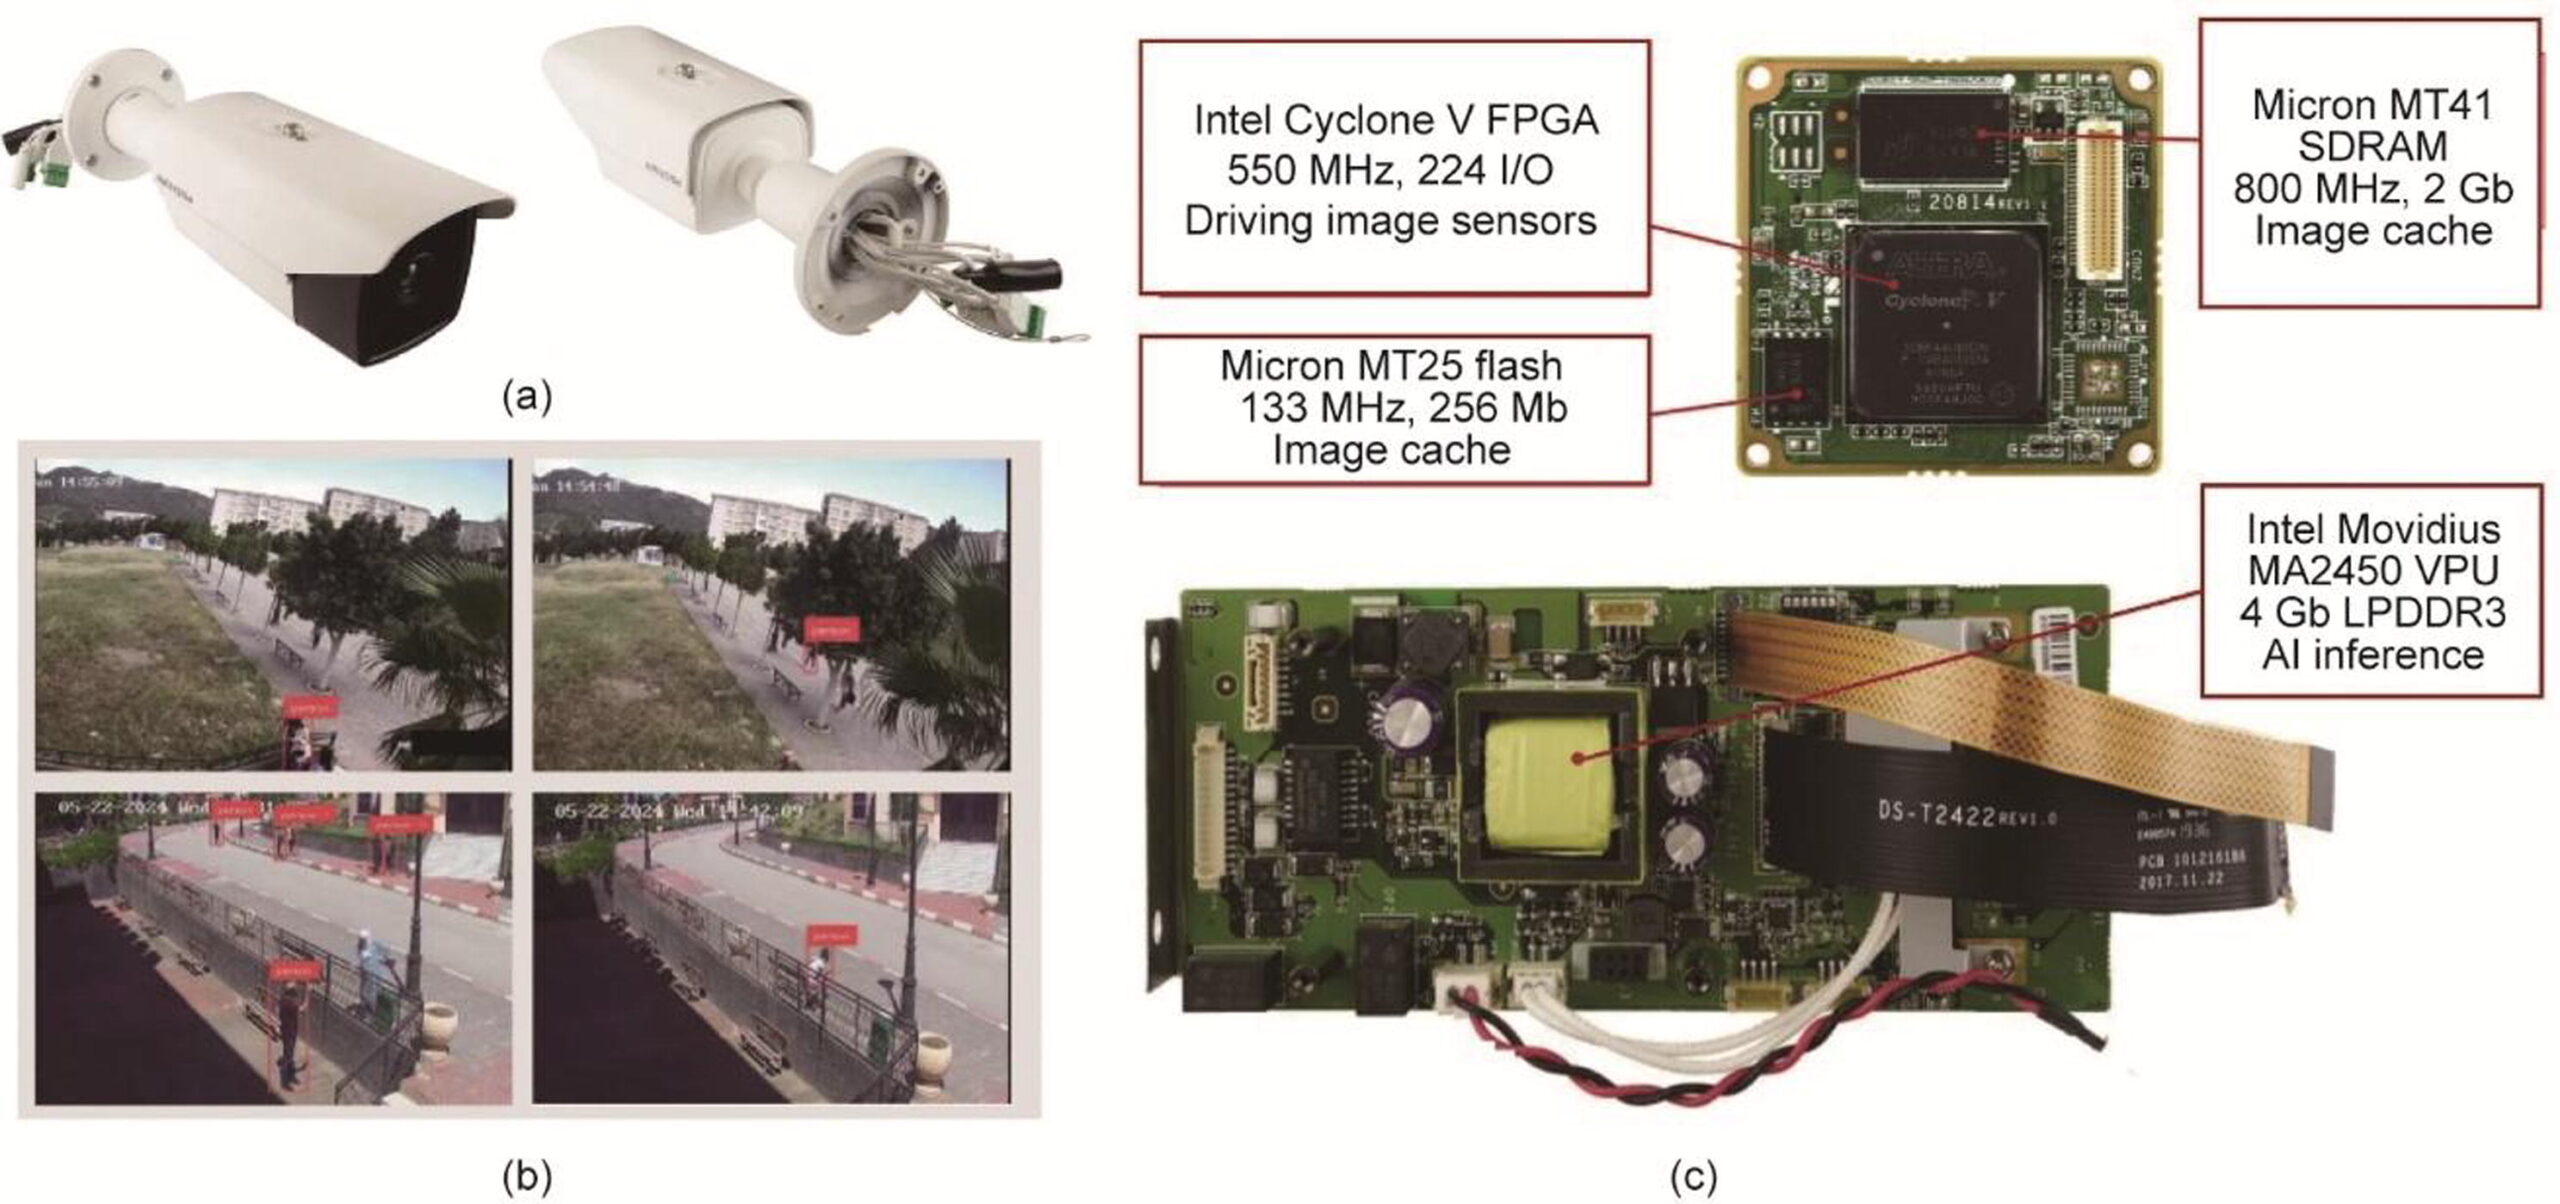
Рис. 6. Камера Hikvision DS-2TD2166-15 с искусственным интеллектом. (a) Внешний вид камеры и (b) обнаружение вторжения человека на камере. (c) Внутренний модуль камеры состоит из FPGA, блока обработки изображений (VPU) и устройств хранения данных.
Пандемия коронавирусной болезни 2019 (COVID-19) еще больше ускорила применение интеллектуальных систем камер на периферии сети в системах эпидемиологического надзора. Конг и др. [114] предложили основанную на периферийных вычислениях систему обнаружения масок, состоящую из этапов восстановления видео, обнаружения лиц и распознавания масок, реализованную на Intel Neural Compute Stick. Система обеспечивает обнаружение масок в реальном времени с помощью маломощных камер, установленных на шине, эффективно поддерживая профилактику и контроль пандемии. Рахман и др. [115] разработали многосенсорную систему Интернета медицинских вещей (IoMT), которая интегрирует визуальные, инфракрасные, слуховые и электрокардиографические (ЭКГ) датчики. Благодаря глубокому анализу визуальных данных на платформах Raspberry Pi или NVIDIA Jetson, она выполняет распознавание боли, анализ эмоций и мониторинг социальной дистанции, расширяя возможности применения в мобильных и носимых медицинских приложениях.
В области распознавания лиц и анализа эмоций Ян и др. [116] реализовали систему мониторинга допроса преступников с использованием NVIDIA Jetson TX2 и Raspberry Pi, напрямую обрабатывая необработанные потоки изображений с каждой камеры для распознавания эмоций по выражению лица подозреваемых. Лю и др. [117] развернули ускорители обнаружения лиц на основе MobileNet-V2 на ПЛИС Intel Arria 10 и Stratix 10, достигнув скорости обнаружения до 763 кадров в секунду и энергоэффективности 8 гигаопераций (GOP)·(s·W)−1 за счет систолической матричной конструкции, матричного мозаичного размещения, квантования с фиксированной точкой и параллельных вычислений. Ву и др. [118] реализовали алгоритм распознавания выражений лица на открытом воздухе на основе внимания на SoC Qualcomm Snapdragon 730G в смартфоне Redmi K30, достигнув скорости вывода приблизительно 40 кадров в секунду, что демонстрирует возможность мобильного вывода в реальном времени на периферии для распознавания эмоций на основе зрения.
В целом, городские интеллектуальные системы мониторинга быстро развиваются в направлении распределенных, периферийно-ориентированных архитектур, которые сочетают в себе обработку визуальной информации с низкой задержкой, интеграцию нескольких датчиков и совместную оптимизацию аппаратного и программного обеспечения. Эти достижения не только улучшают управление дорожным движением и общественную безопасность, но и распространяются на здравоохранение и поведенческую аналитику, формируя технологическую основу следующего поколения умных городов.
4.3. Робототехника и воплощенный интеллект
Роботы представляют собой типичную систему «восприятие-принятие-выполнение». Интеллектуальные роботы используют мультимодальные датчики для получения информации об окружающей среде, проведения анализа в реальном времени и управления исполнительными механизмами для реагирования на сложные сценарии. С инженерной точки зрения, их электромеханические функции часто делятся на четыре иерархических компонента: «мозг» (восприятие и принятие решений), «мозжечок» (поза и управление), «тело» (система привода) и «конечности» (концевые эффекторы) [119], [120], [121]. Поскольку плотность датчиков и вычислительные потребности продолжают расти, каждая подсистема все больше зависит от микросхем периферийных вычислений для поддержки петель обратной связи с низкой задержкой и локального интеллектуального вывода.
Как показано на рис. 7, для различных подсистем робототехники разработаны зрелые решения для граничных вычислений. Например, система на модуле (SOM) Xilinx Kria KR260 обеспечивает поддержку нативной операционной системы роботов ROS2 и встроенный ускоритель вывода ИИ для роботизированных приложений. Она может запускать большинство моделей CNN для робототехнического зрения в реальном времени, выступая в качестве «мозга» для роботизированного восприятия. KR260 работает под управлением нативной операционной системы ROS2, поддерживает высокоскоростную передачу данных SFP+ со скоростью 10 гигабит в секунду (Гбит/с) и интегрирует специализированный ускоритель ИИ для обработки визуальных данных в реальном времени [122]. Для подсистемы «конечностей» компания Hitachi разработала систему захвата робота с визуальным управлением на основе FPGA. Система использует камеры для захвата информации о сцене и выполняет обнаружение объектов и планирование траектории непосредственно на FPGA, направляя концевой манипулятор для выполнения высокоточного захвата в реальном времени и тем самым обеспечивая более безопасное и быстрое управление движением [123]. Эти примеры демонстрируют, что высокая степень параллелизма и низкая задержка периферийных вычислений становятся важными для интеллектуальной эволюции робототехники.
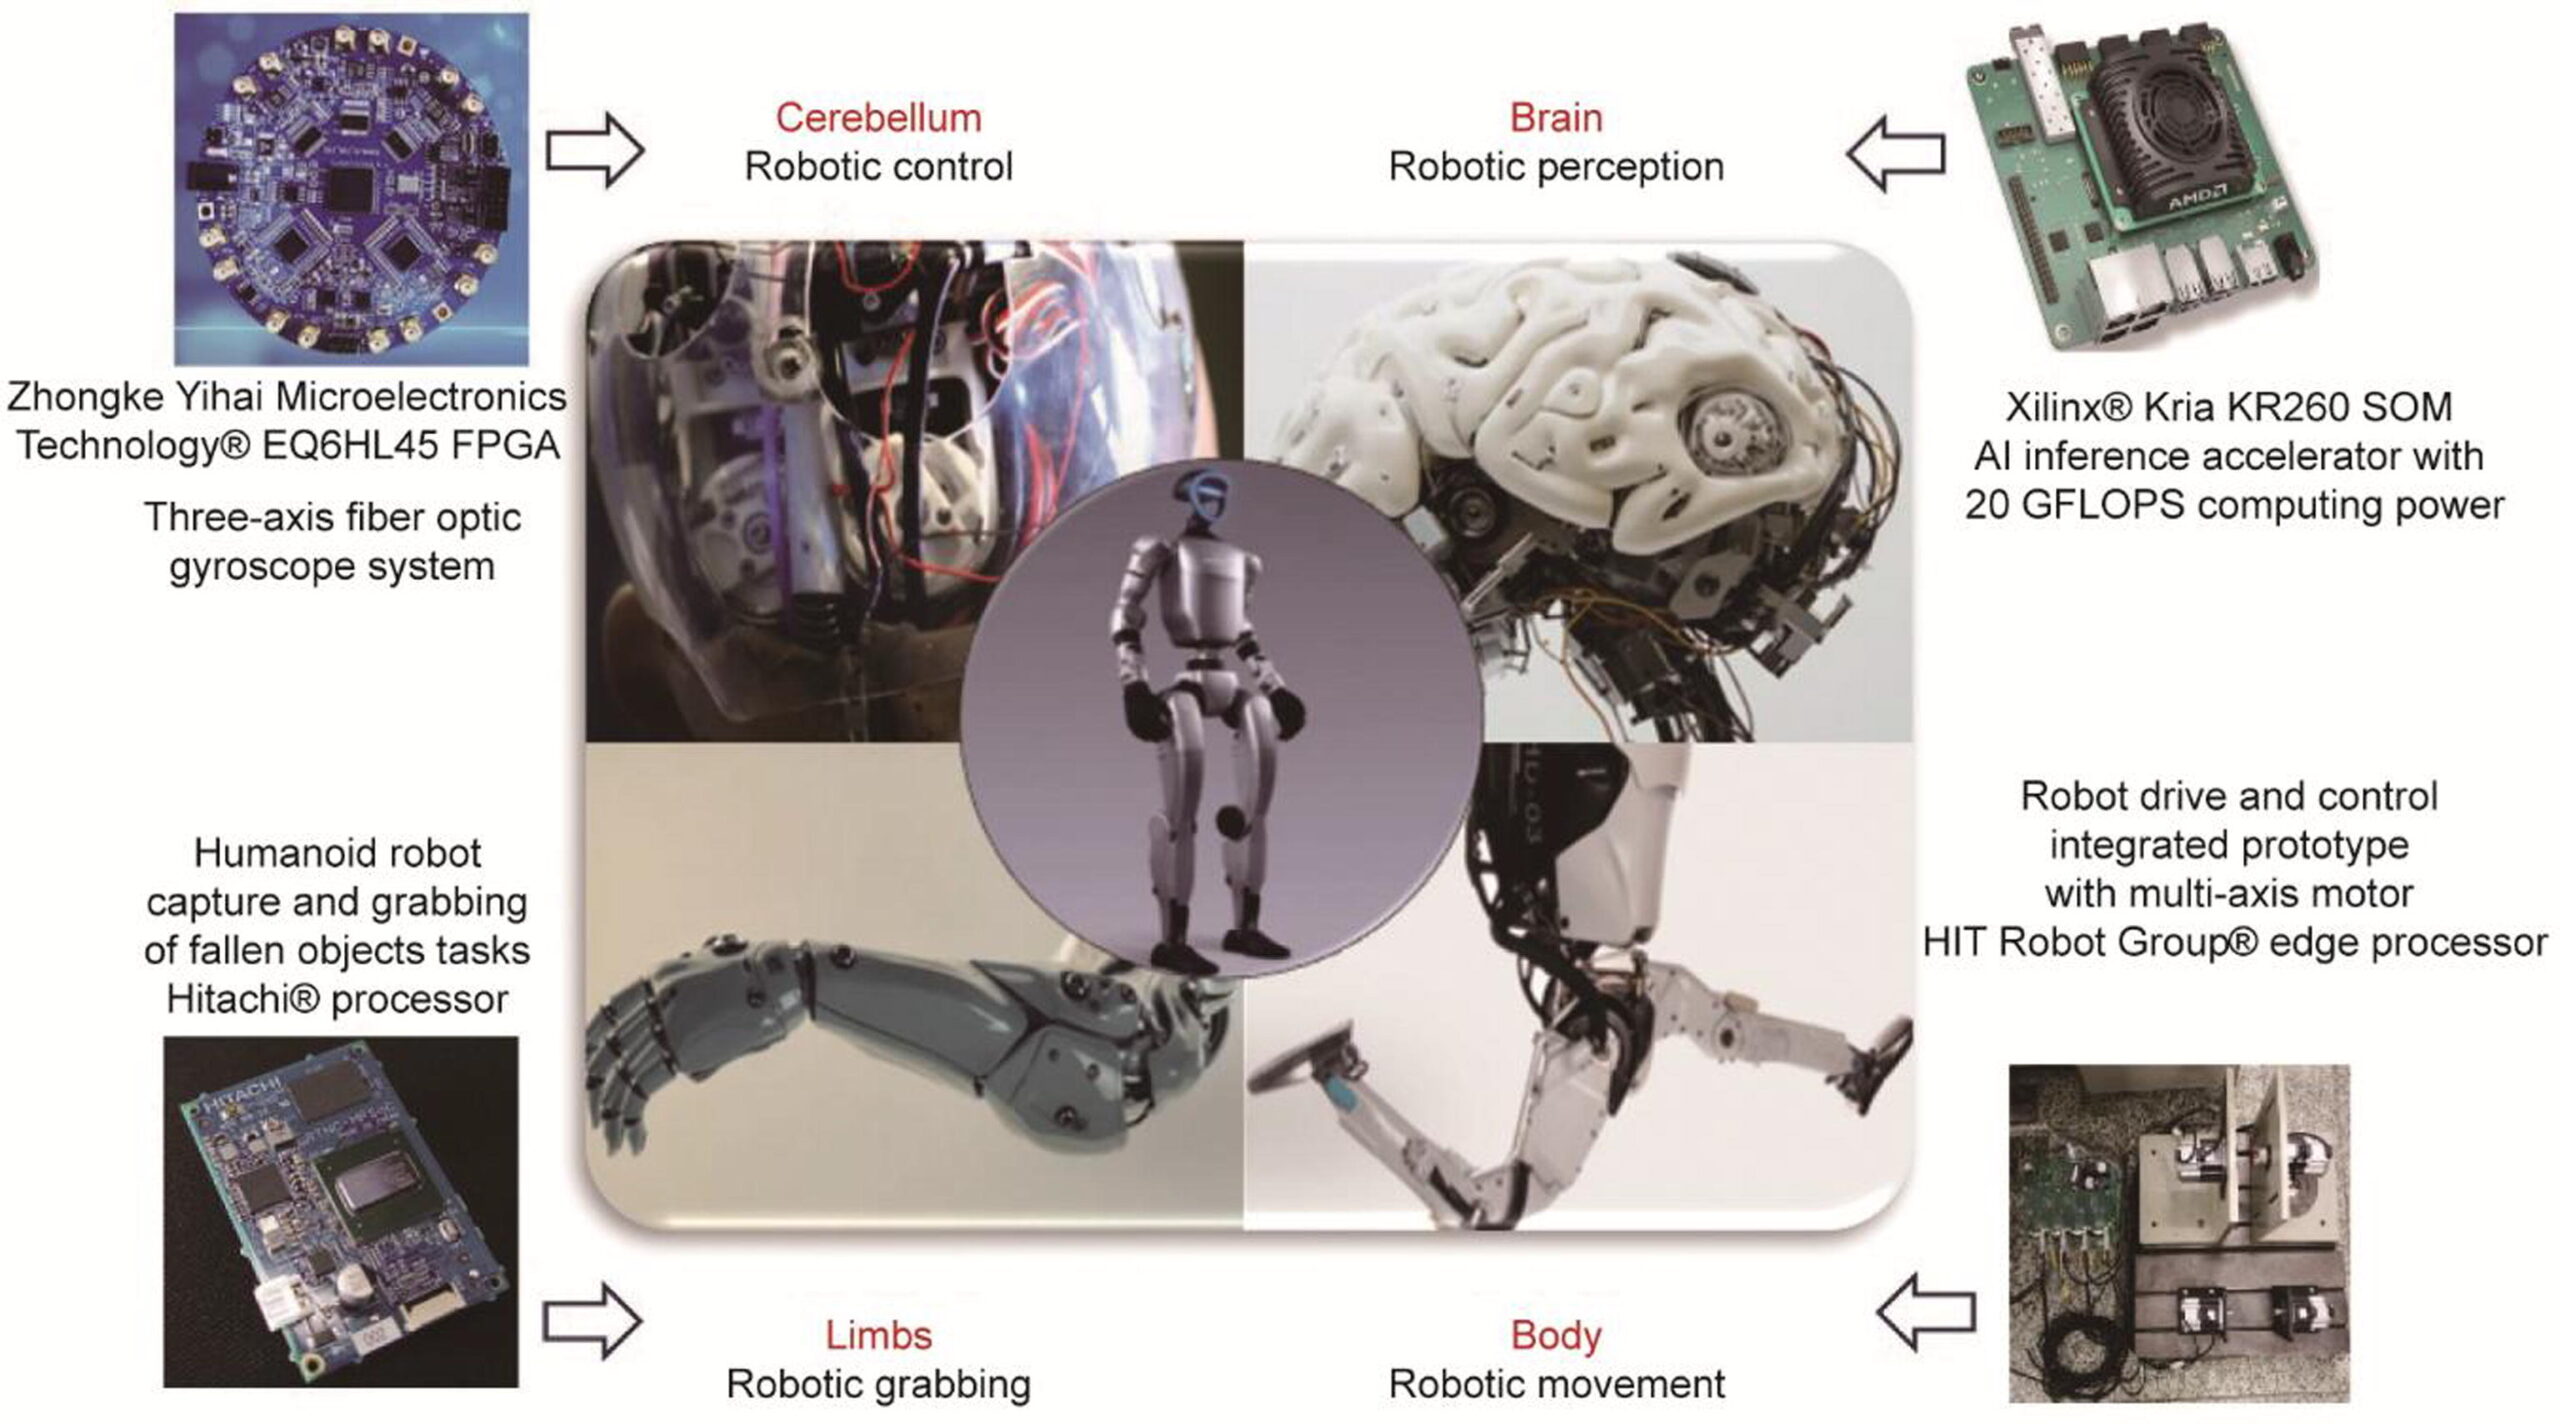
Рис. 7. Основные компоненты робота и соответствующее оборудование.
Опираясь на этот фундамент, интеллектуальная робототехника развивается в направлении воплощенного интеллекта, который делает акцент на адаптивной связи между познанием и поведением посредством непрерывного взаимодействия и обучения в реальных условиях, а не на использовании исключительно предопределенных правил или централизованных моделей на основе облачных вычислений [124], [125]. В отличие от традиционной парадигмы «обучение в облаке – вывод на периферии», воплощенный интеллект требует встроенного онлайн-обучения и адаптации в реальном времени. Однако онлайн-обучение DNN обычно требует значительных вычислительных и запоминающих ресурсов, что делает эффективное обучение на устройстве в условиях периферийных вычислений ключевым направлением исследований [126].
Для решения этой задачи исследователи предложили множество встроенных решений для непрерывного онлайн-обучения (OCL), которые можно условно разделить на технологические решения на основе встроенных графических процессоров (GPU) и программируемых логических интегральных схем (FPGA).
В решениях на основе встроенных графических процессоров эти подходы используют маломощные встроенные платформы графических процессоров (например, Jetson Nano и Orin) с легковесными нейронными сетями или импульсными нейронными сетями (SNN) для непрерывного обучения, управляемого событиями. Например, Путра и др. [127] представили фреймворк SpikeDyn, который выполняет неконтролируемое онлайн-обучение на встроенных графических процессорах. По сравнению с традиционными методами он снижает энергопотребление при обучении на 51% и при выводе на 37%, демонстрируя большой потенциал для локальной адаптации в воплощенных средах.
Решения на основе FPGA ориентированы на оптимизацию вычислительных блоков на аппаратном уровне для ускорения обратного распространения ошибки, особенно на операции деления и градиента во время обучения модели. Мазуз и др. [128] реализовали модули буфера воспроизведения и потокового буфера на FPGA Xilinx Zynq-7100, что позволило осуществлять обновление весов в реальном времени на кристалле и онлайн-обучение. Аналогично, Тан и др. [129] устранили узкие места в пути передачи данных за счет поблочного непрерывного выделения памяти и структурированного повторного использования весов, достигнув пропускной способности обучения 46,99 GFLOPS и энергоэффективности 6,09 GFLOPS·W −1 на платформах FPGA.
Крупномасштабные модели становятся когнитивной и определяющей основу воплощенного интеллекта, что делает их использование на периферии ключевым направлением. Репрезентативным примером является парадигма «зрение-язык-действие» (VLA), которая объединяет мультимодальное восприятие, семантическое рассуждение и планирование управления в единую структуру, позволяя роботам генерировать исполняемые последовательности действий непосредственно из языковых или визуальных входных данных [130] . Например, OpenVLA, выпущенный в 2024 году, построен на основе ViT и LLaMA и содержит 7 миллиардов параметров; он поддерживает эффективную тонкую настройку на потребительских графических процессорах посредством адаптации низкого ранга и может использоваться с квантованием без снижения вероятности успешного выполнения последующих задач [131].
Однако последующие анализы показывают, что чисто авторегрессивный OpenVLA работает всего лишь с частотой около 5–6 Гц, что все еще ниже частоты обновления 50–100 Гц, обычно желаемой для плавного и высокореактивного управления роботами. SmolVLA, выпущенный в 2025 году, решает эту проблему, используя гораздо меньшую по размеру архитектуру (представленную в вариантах 0,24 B/0,45 B/2,25 B) и асинхронный стек вывода, который отделяет выполнение действий от обработки наблюдений, тем самым повышая скорость отклика на доступном оборудовании [132].
В реальных экспериментах эта асинхронная конструкция сократила среднее время выполнения задачи с 13,75 до 9,7 с и увеличила количество успешных циклов захвата и перемещения в пределах фиксированного временного окна с 9 до 19, демонстрируя существенное улучшение практической скорости отклика управления. В более широком смысле, недавние исследования производительности показывают, что системы VLA должны стремиться к задержке вывода примерно в 10–100 мс. Кроме того, они предполагают, что высокочастотное управление роботами более реалистично достигается с помощью иерархических или асинхронных конструкций, где более медленный модуль VLA работает на частоте около 5–10 Гц для восприятия и высокоуровневого рассуждения, в то время как отдельный контроллер низкого уровня работает на гораздо более высокой частоте для обеспечения стабильности выполнения [133].
Эта тенденция также отражена в AnywhereVLA, которая полностью работает на борту потребительского оборудования, используя Jetson Orin NX для восприятия и вывода VLA и Intel NUC для одновременной локализации и картографирования (SLAM), исследования и управления, поддерживая работу в реальном времени и достигая общего показателя успешности выполнения задач в 46% в многокомнатных экспериментах [134].
Вкратце, эволюция от традиционного роботизированного интеллекта к воплощенному интеллекту знаменует собой сдвиг парадигмы от статического вывода к адаптивному сенсомоторному обучению непосредственно на периферии. Благодаря синергии встроенного непрерывного обучения, ускорения на FPGA и легковесных многомодальных больших моделей, разработка роботов движется к автономному, эффективному и физически обоснованному интеллекту, что является важным шагом на пути к реализации по-настоящему воплощенного ИИ.
4.4. Системы спектрального восприятия в реальном времени
Гиперспектральная визуализация (ГСИ) позволяет одновременно получать как пространственную структуру, так и спектральную информацию об изображении. По сравнению с традиционной RGB-визуализацией, она предлагает значительное преимущество многомерного пространственно-спектрального слияния данных, что делает ее ключевым направлением исследований в области машинного зрения. Исторически технология ГСИ в основном использовалась в спутниковых приложениях дистанционного зондирования, таких как моделирование окружающей среды, наблюдение за атмосферой и распознавание военных целей [135].
Благодаря быстрому развитию оптоэлектронных датчиков, вычислительной техники и ИИ, область применения гиперспектральной технологии расширилась от лабораторных и оборонных областей до высокоточных областей, таких как сельскохозяйственный контроль качества продуктов питания и биомедицинский анализ [136], [137]. Эти задачи все чаще выполняются в периферийных средах, таких как промышленные производственные линии или мобильные полевые операции, где системы должны обеспечивать не только высокоточное распознавание, но и миниатюризацию и возможность обработки в реальном времени. Таким образом, интеграция интеллектуальных алгоритмов и чипов для граничных вычислений в гиперспектральные камеры для получения и обработки данных на устройстве стала критически важным путем к эффективному спектральному зрению [138].
Например, Раджеш и др. [139] разработали гибкую систему широкополосного спектрального зондирования на основе глубокого обучения (DLWSS) с использованием реконфигурируемой матрицы субнайквистовской выборки (SNS). Метод использует гетерогенную архитектуру ARM + FPGA для совместной обработки данных и вывода CNN, обеспечивая эффективные аппаратно-программные вычисления. Аналогичным образом, Европейское космическое агентство (ESA) встроило свою собственную камеру HyperScout2 в спутник Φ-sat-1, интегрировав процессор Intel Movidius Myriad 2 VPU для выполнения сегментации облаков в реальном времени на основе гиперспектральных изображений атмосферы непосредственно на орбите с использованием моделей CNN.
Такая конструкция устранила необходимость передачи всех гиперспектральных данных на Землю, значительно сократив пропускную способность канала связи и улучшив время отклика. В течение 70 дней непрерывной работы на орбите система достигла уровня ложных срабатываний 0%, что демонстрирует точность и надежность бортового гиперспектрального анализа с использованием ИИ [140]. Такие интегрированные в спутник архитектуры демонстрируют большой потенциал в наблюдении за Землей, мониторинге окружающей среды и реагировании на чрезвычайные ситуации.
Ло и др. [141] утверждали, что по сравнению с FPGA специализированные ASIC для обнаружения гиперспектральных изображений могут обеспечить превосходную производительность как в плане энергоэффективности, так и в плане обработки в реальном времени. Соответственно, они разработали специализированный чип обнаружения гиперспектральных изображений для применения в дистанционном зондировании беспилотных летательных аппаратов (БПЛА). Чип оснащен специальными модулями аппаратного ускорения для уменьшения размерности спектра, извлечения конечных элементов и оценки их содержания, обеспечивая скорость обработки 62,4 кадра в секунду для гиперспектральных изображений размером 256 × 256 × 64 при потреблении всего 44,3 мВт — что значительно превосходит традиционные решения на кристалле на основе процессоров общего назначения.
Стоит отметить, что наша исследовательская группа разработала интеллектуальную систему обнаружения на основе гиперспектрального зондирования и вычислений, как показано на рис. 8. Система построена на платформе Xilinx ZU19EG MPSoC, объединяющей оптическую визуализацию, предварительную обработку на кристалле и интеллектуальный вывод в единой системе.
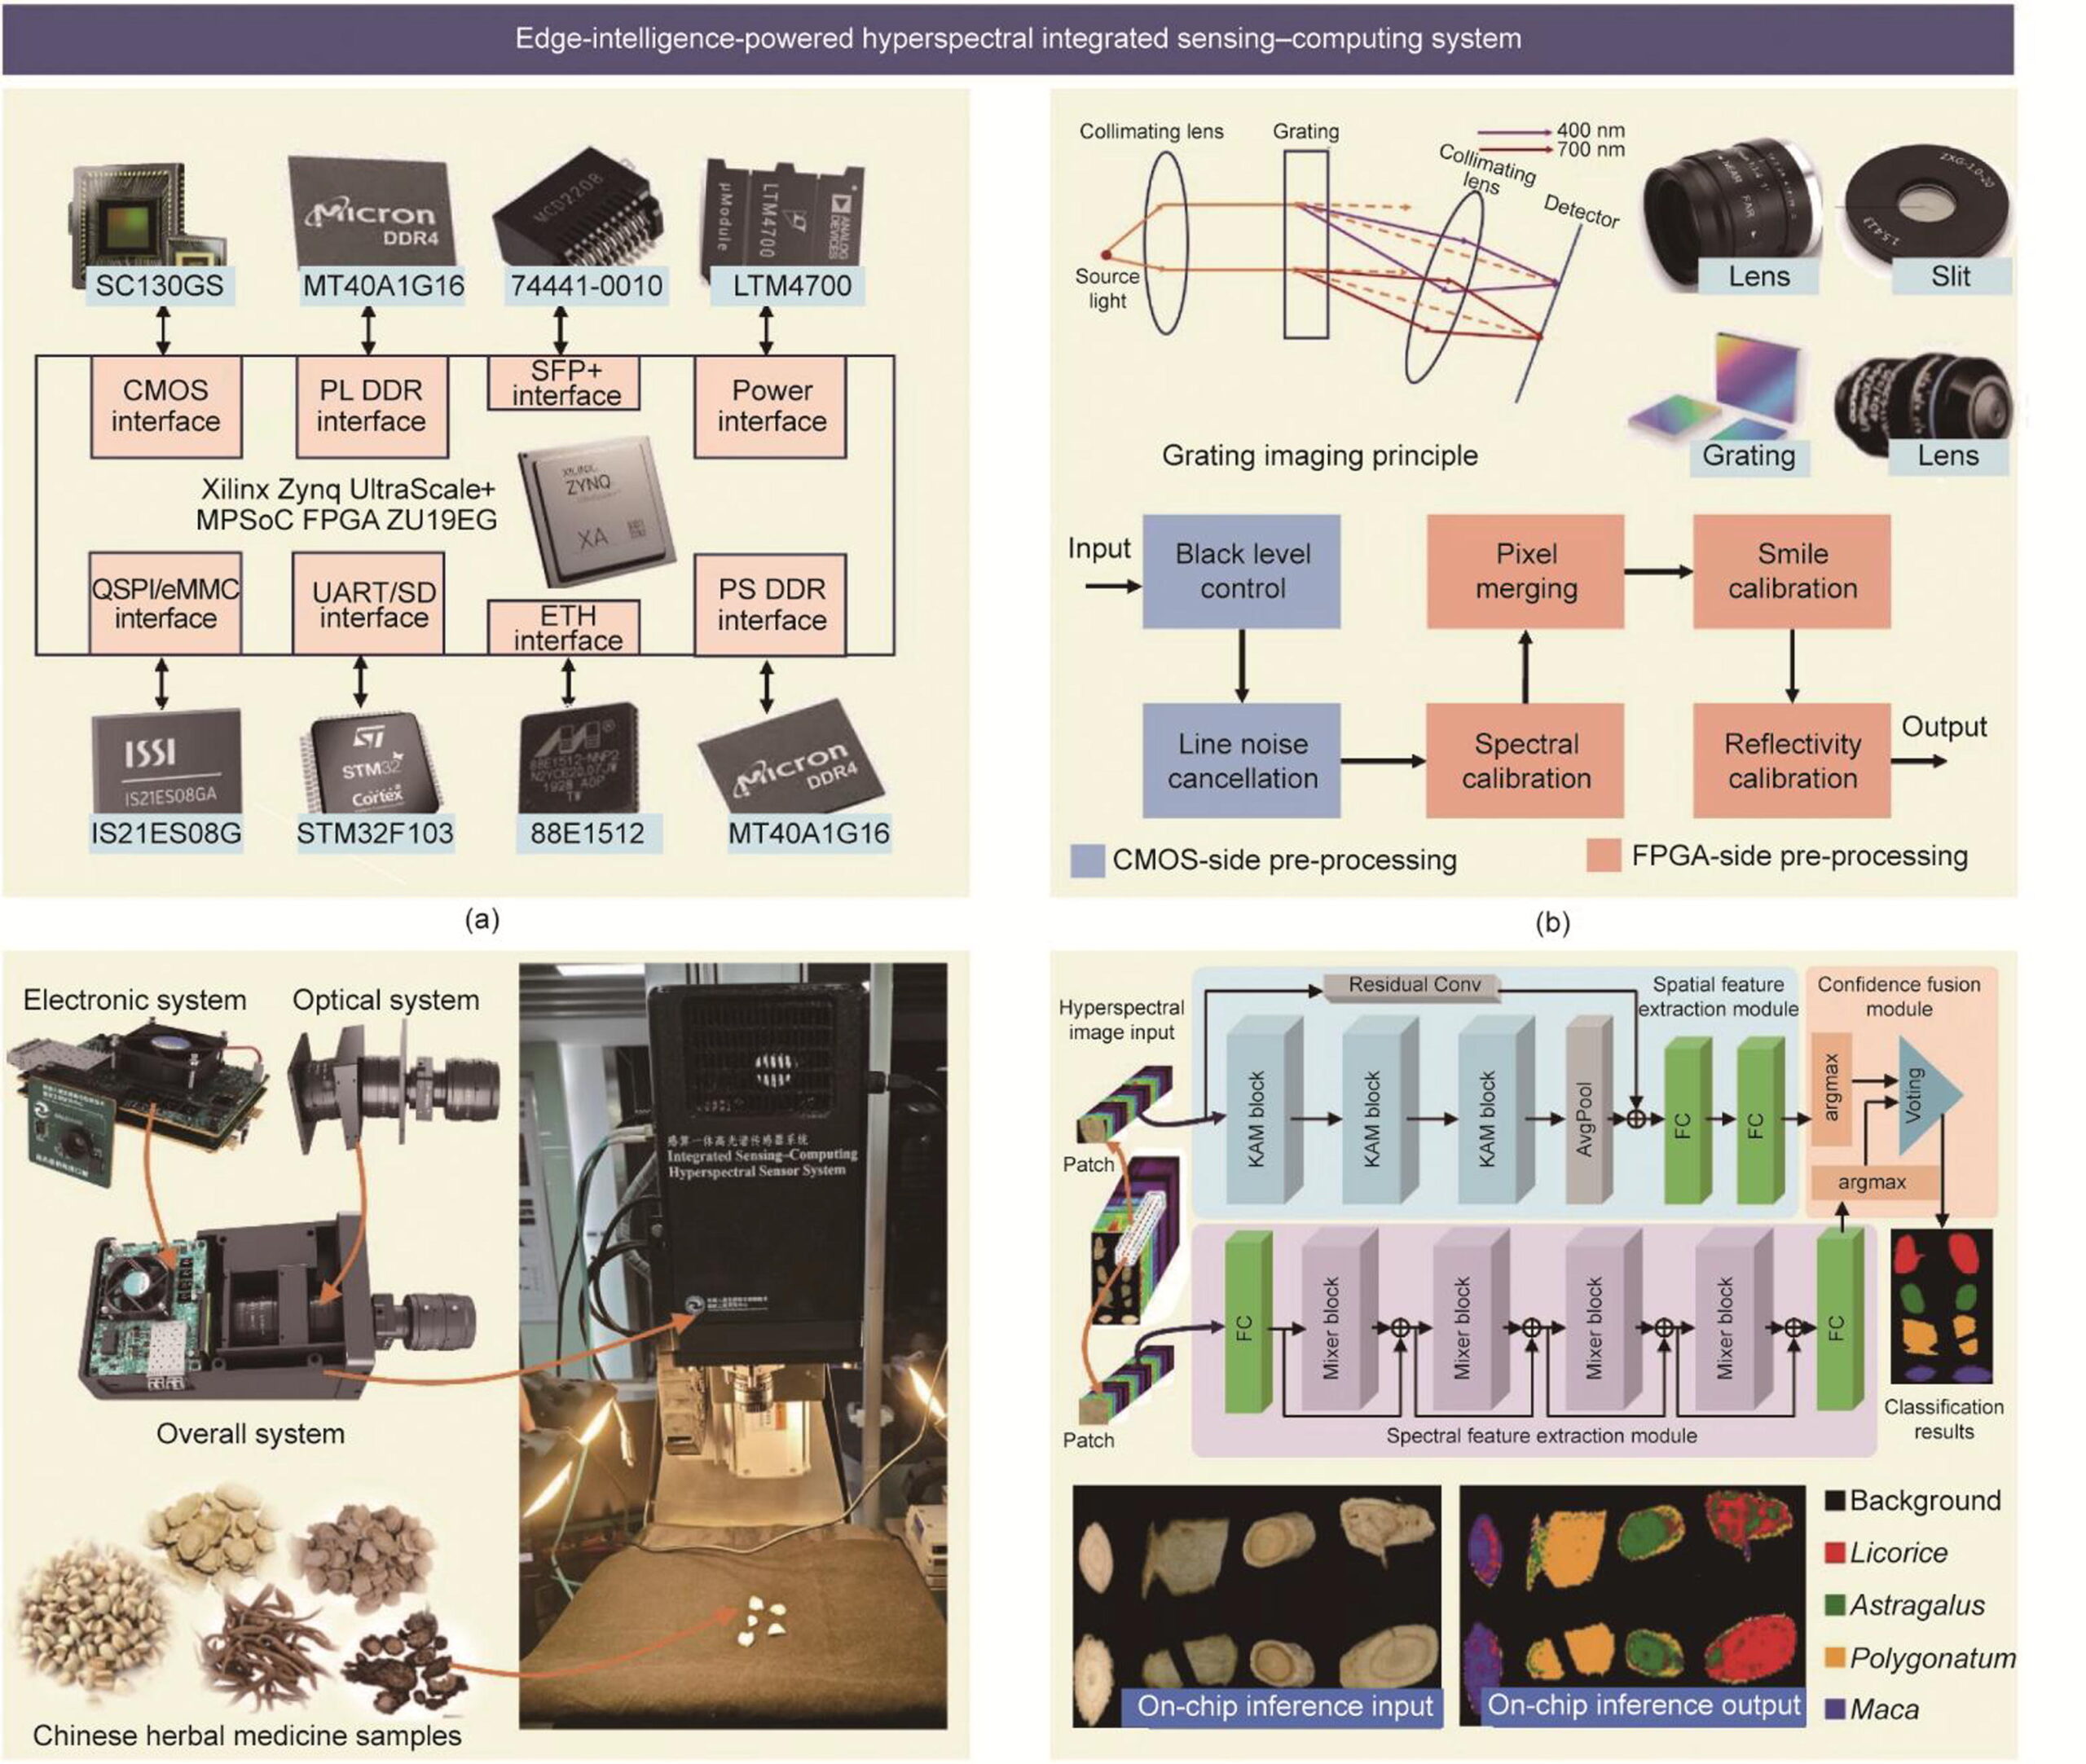
Рис. 8. Интегрированная гиперспектральная сенсорно-вычислительная система на основе периферийного интеллекта. (a) Аппаратная архитектура сенсорно-вычислительного модуля на базе платформы Xilinx ZU19EG MPSoC, объединяющая оптические, запоминающие, коммуникационные и силовые интерфейсы. (b) Рабочий процесс оптической визуализации и калибровки, включая предварительную обработку на стороне комплементарной металл-оксидной полупроводниковой (CMOS) технологии (контроль уровня черного и линейного шума) и предварительную обработку на стороне FPGA (спектральная калибровка, калибровка «улыбки» и отражательной способности). (c) Прототип интегрированной гиперспектральной камеры, объединяющей электронные и оптические подсистемы, применяемый для идентификации образцов китайских лекарственных трав на месте. (d) Встроенная модель периферийного интеллекта, состоящая из модулей извлечения пространственных и спектральных признаков и головки слияния достоверности, обеспечивающая вывод и визуализацию в реальном времени на чипе. PL DDR: программируемая логическая синхронная динамическая память с удвоенной скоростью передачи данных; SFP: малогабаритная подключаемая память; QSPI: четырехканальный последовательный периферийный интерфейс; UART: универсальный асинхронный приемник/передатчик; SD: карта Secure Digital; eMMC: встроенная мультимедийная карта; ETH: Ethernet; PS DDR: синхронная динамическая оперативная память с удвоенной скоростью передачи данных; Conv: свертка; AvgPool: усредняющее пулинг; KAM: сверхлегкая сеть на основе механизма внимания масштаба килобайт; FC: полностью связанная сеть.
Аппаратная подсистема включает модули для интерфейса датчиков на основе комплементарных металл-оксидных полупроводников (CMOS), память с удвоенной скоростью передачи данных (DDR) и высокоскоростной канал передачи данных SFP+ с малой пропускной способностью 10 Гбит/с. Оптическая подсистема использует архитектуру спектральной визуализации с сканирующей разверткой, охватывающую диапазон длин волн 400–700 нм. Встроенная модель интеллектуального анализа границ включает две скоординированные ветви: ветвь извлечения спектральных признаков и ветвь извлечения пространственных признаков, выходные данные которых объединяются с помощью модуля принятия решений на основе достоверности для многомодальной интеграции признаков. Эта архитектура позволяет в режиме реального времени распознавать и визуализировать образцы китайских лекарственных трав (например, Glycyrrhiza uralensis , Astragalus membranaceus и Lepidium meyenii ) непосредственно на стороне датчика.
В ходе практической оценки интегрированная система гиперспектрального зондирования и вычислений демонстрирует высокую эффективность и применимость в реальных условиях. Используя предложенную двухветвевую модель интеллектуального управления на границах на гиперспектральных изображениях китайских лекарственных трав, полученных методом сканирования, система достигает пропускной способности 502 GOPS и задержки 32,2 мкс на фрагмент 9 × 9, при энергопотреблении 14,42 Вт, достигая общей точности классификации 97,8% [142]. Это позволяет проводить высокоточную классификацию образцов в реальном времени с минимальным использованием ресурсов, поддерживая точность классификации, сопоставимую с точностью стандартных решений на базе ЦП и ГП. Результаты показывают, что совместно разработанное аппаратное обеспечение и программное обеспечение интеллектуального управления на границах могут удовлетворить потребности в оперативном гиперспектральном анализе, обеспечивая при этом энергоэффективную работу.
5. Вызовы и перспективы на будущее
В данном обзоре рассмотрены последние достижения на стыке машинного зрения и искусственного интеллекта, с акцентом на проблемы внедрения и решения для интеллектуальных моделей зрения на периферийном оборудовании, проиллюстрированные репрезентативными примерами приложений. В этом разделе изложены ключевые проблемы в системах EIMV и обсуждаются будущие направления.
5.1. Проблемы для EIMV
Хотя EIMV уже применима на практике во многих сценариях, остаются существенные пробелы в системной интеграции, вычислительной эффективности, энергоэффективности и уровне интеллекта. В таблице 5 кратко соотнесена каждая проблема с ее последствиями, существующими решениями, проблемными моментами и вероятными направлениями прорыва.
Таблица 5. Четыре основные проблемы, связанные с EIMV.
| Испытание | Влияние | Существующие решения | Трудности | Прорывные направления |
|---|---|---|---|---|
| Система | Разработка крупных систем и комплексных проектов | Интеграция на уровне платы. Гетерогенные платформы. | Сложные архитектуры. Фрагментированные цепочки инструментов. | Внутрисенсорные вычисления Фотонные вычисления |
| Вывод | Низкая скорость и поток данных | Снижение производительности моделей. Параллелизм и конвейерная обработка. | Скорость против точности. Ограниченные ресурсы. | Вычисления в оперативной памяти |
| Энергия | Кратковременная выносливость | Маломощная ASIC | Управление мощностью | Датчики событий. Вычисления, вдохновлённые работой мозга. |
| Интеллект | Плохая обобщающая способность | Непрерывное онлайн-обучение, поэтапное обучение | Ограниченные ресурсы. Данные низкого качества. | Edge большая языковая модель |
5.1.1. Системы
Системы EIMV объединяют множество датчиков, вычислительных чипов и алгоритмических модулей на единой платформе, что приводит к сложным архитектурам и длительным циклам отладки. По мере расширения сфер применения от автомобильной и промышленной промышленности до робототехники, гетерогенная совместимость и взаимодействие становятся все более сложной задачей. Современная практика основана на интеграции на уровне плат и гетерогенной совместной разработке, часто с использованием единого промежуточного программного обеспечения для объединения модулей. Однако фрагментированные наборы инструментов и сложные системные стеки по-прежнему препятствуют развертыванию и обновлению. Перспективным направлением является ближние/внутрисенсорные вычисления (ISC) и совместное проектирование на системном уровне, встраивание вычислений на стороне датчика для сокращения путей передачи данных и совместное проектирование системы восприятия-вычислений-связи в единый стек для улучшения интеграции и ремонтопригодности.
5.1.2. Вывод
Для обработки изображений в реальном времени основными узкими местами являются задержка и перемещение данных. Распространенные способы решения этой проблемы включают в себя облегчение вычислительных ресурсов, сокращение объема данных, сжатие и аппаратный параллелизм/конвейерную обработку для повышения пропускной способности. Однако компромисс между скоростью и точностью сохраняется, а многозадачность или входные данные высокого разрешения по-прежнему могут перегружать ресурсы. В перспективе фотонные вычисления и вычисления вблизи/в памяти (IMC) могут преодолеть вычислительный барьер: фотоника предлагает ядра со сверхвысокой пропускной способностью и низкой задержкой, а архитектуры вблизи/в памяти уменьшают перемещение данных, открывая новые пути для обработки данных на периферии сети в реальном времени.
5.1.3. Энергия
5.1.4. Интеллект
Внедрение в разных сценариях часто приводит к дрейфу модели, а точность снижается из-за ограниченной обобщающей способности и чувствительности к изменениям распределения. Такие методы, как OCL и инкрементальное обучение, помогают адаптироваться к ограниченному объему данных, но остаются ограниченными вычислительными ресурсами и качеством данных, что влияет на стабильность. Вероятным прорывом станут облегченные локализованные базовые модели обработки больших языков (базовые модели обработки больших языков (LLM)/модели обработки языков для обработки изображений (VLM)) с модульными обновлениями, совместным использованием параметров и низкобитным квантованием, что обеспечит стабильную точность и адаптивность к условиям эксплуатации устройства.
5.2. Перспективы развития EIMV в будущем
Исходя из вышеуказанных проблем, мы выделяем четыре направления исследований в области EIMV, как показано на рис. 9. Будущее EIMV будет зависеть от следующих областей: ① фотоника и ISC для высокоскоростного восприятия; ② ближние датчики и IMC для энергоэффективной обработки; ③ событийно-ориентированное зондирование и нейроморфные вычисления для динамического восприятия; и ④ периферийное развертывание больших моделей «зрение-язык» для адаптивного интеллекта. Хотя эти направления все еще находятся на стадии формирования, несколько недавних исследований уже предоставили предварительные доказательства осуществимости, такие как демонстрации вычислений в памяти на уровне TOPS на ватт, квантование больших моделей со сверхнизким битовым числом и событийно-ориентированные чипы со значительно сниженным энергопотреблением. Поэтому, вместо того чтобы рассматривать эти перспективы как чисто концептуальные, их можно интерпретировать как исследовательские дорожные карты с постепенно достижимыми этапами, измеримыми техническими барьерами и ориентированными на задачи критериями оценки.
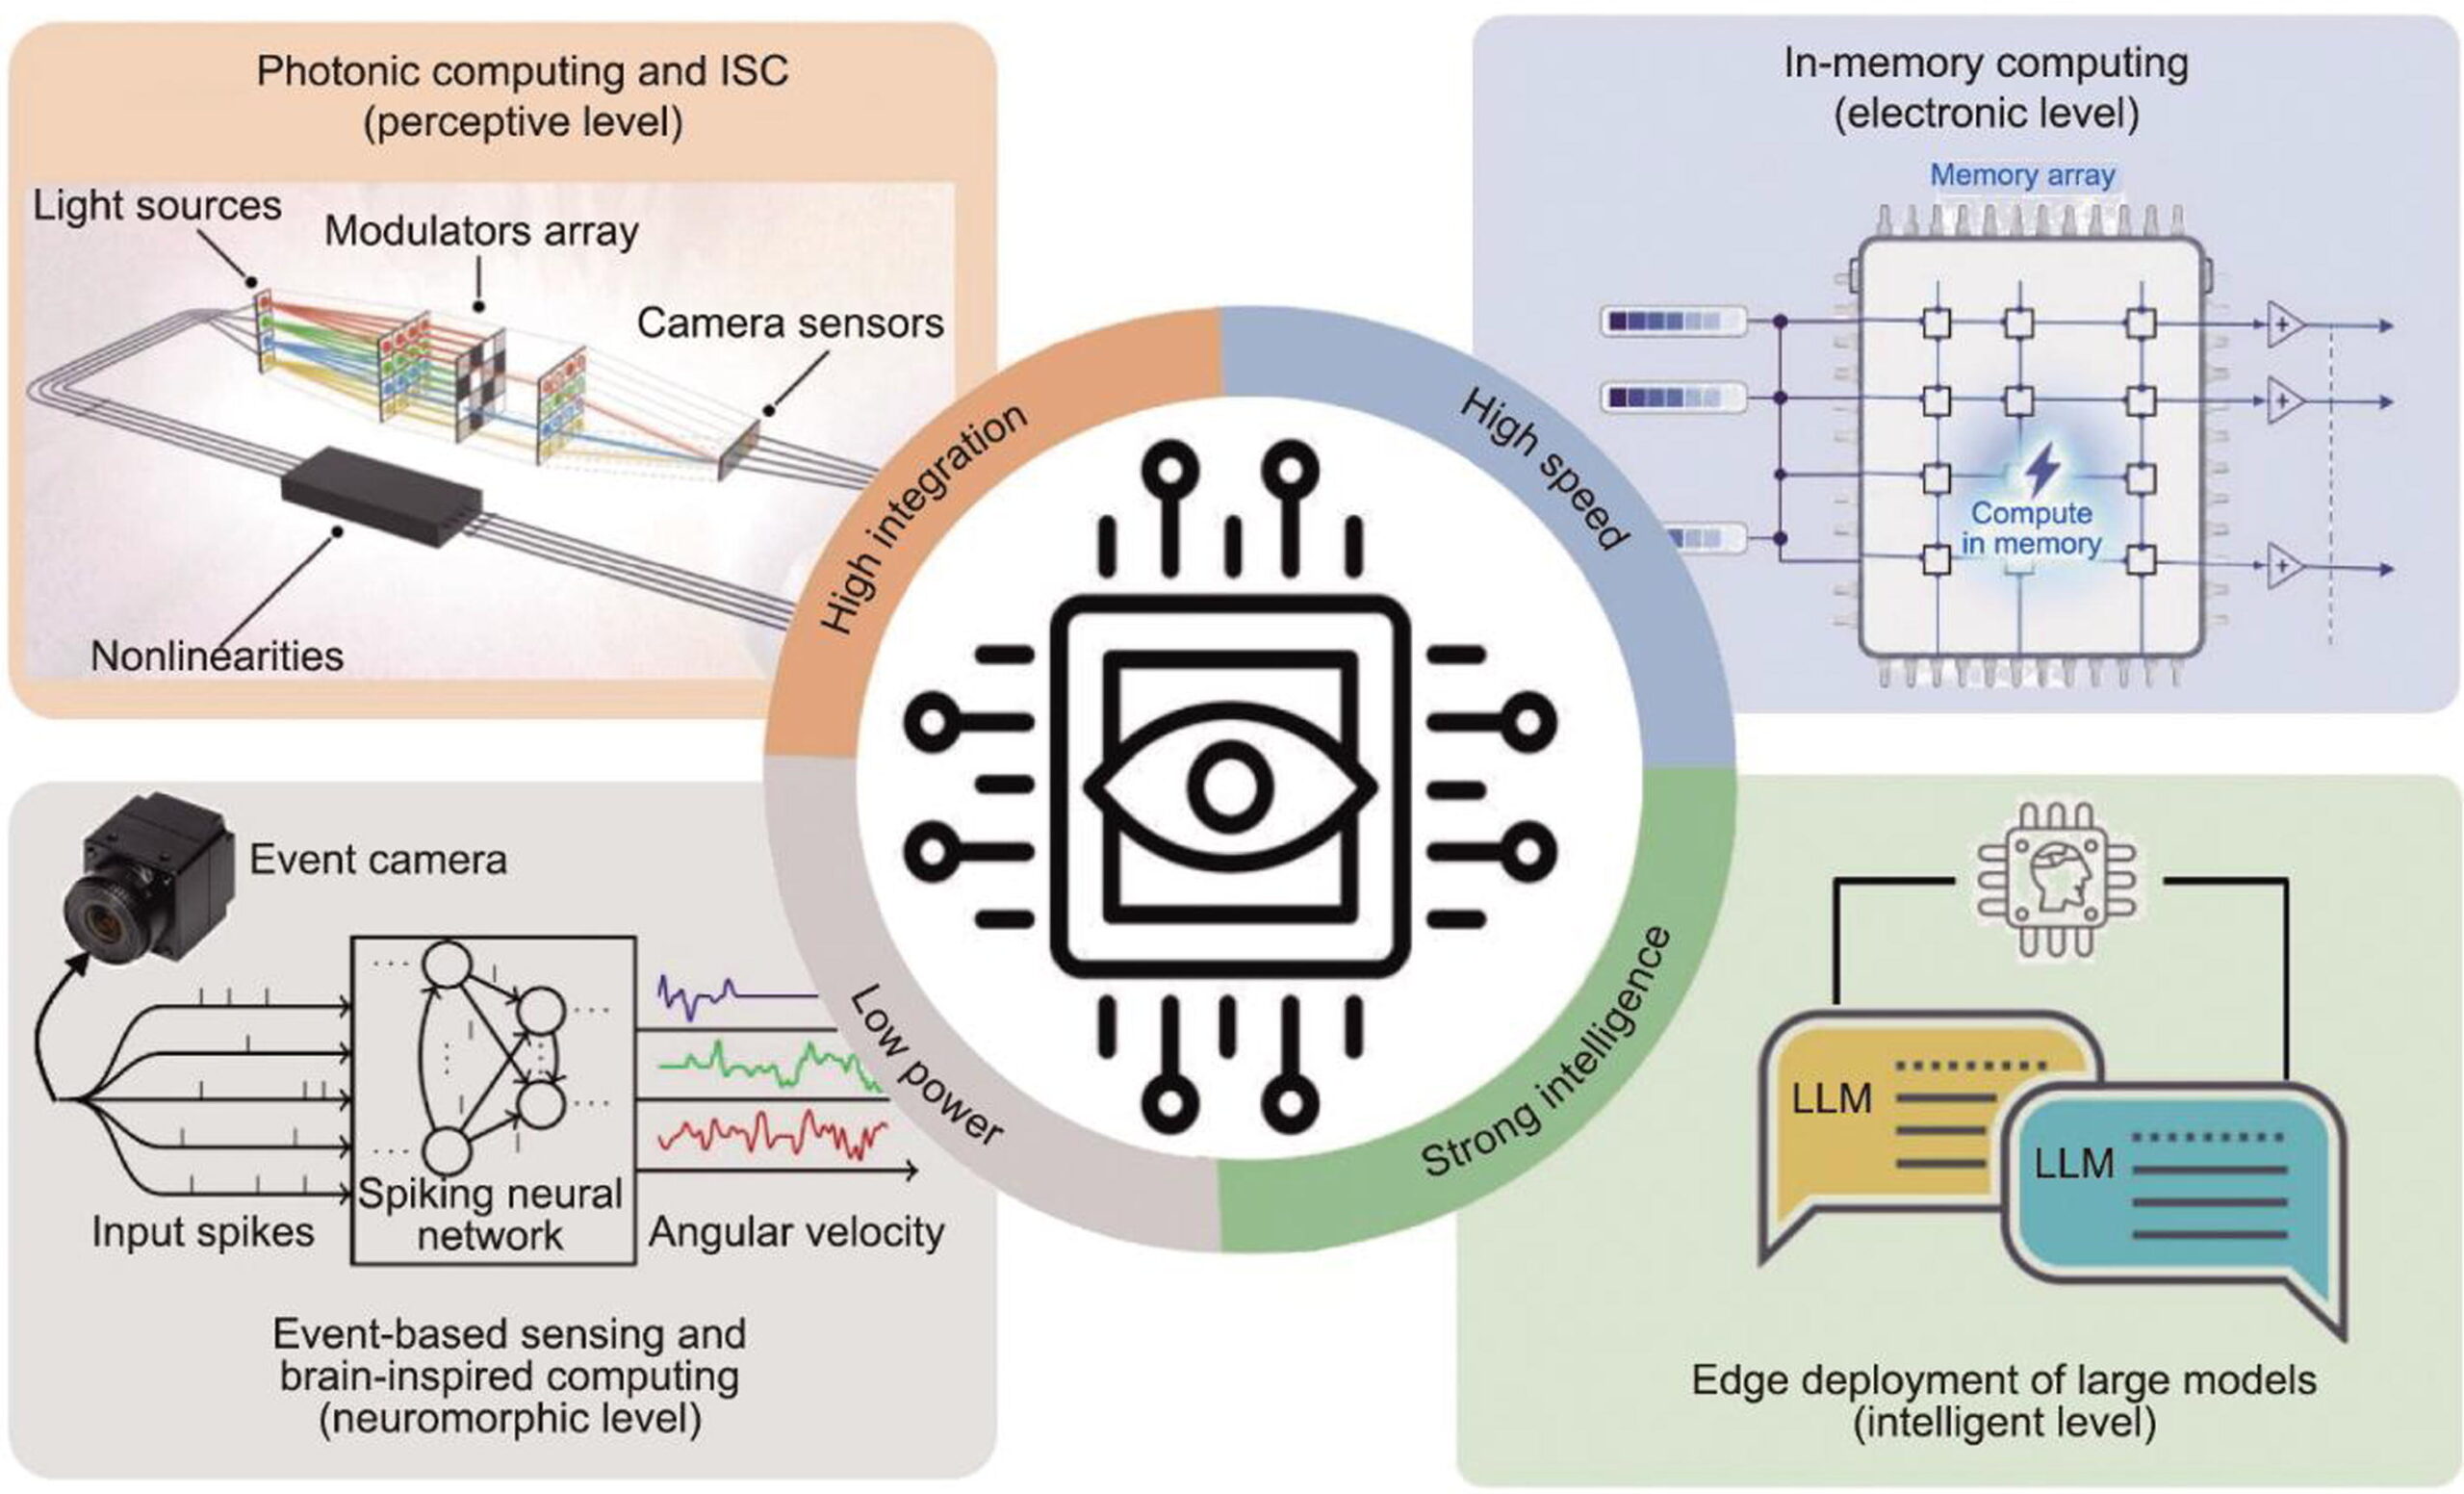
Рис. 9. Четыре перспективных направления развития EIMV.
5.2.1. Фотонные вычисления и ISC
Большинство систем EIMV по-прежнему используют архитектуру «разделения сенсорики и вычислений», где датчики обрабатывают оптический сигнал и фотоэлектрическое преобразование, в то время как интеллектуальные вычисления выполняются отдельными процессорами. Хотя эта конструкция концептуально понятна, частые фотоэлектрические преобразования и передача данных приводят к значительной задержке и энергетическим издержкам. В постмуровскую эпоху стагнация производительности электронных вычислительных систем затрудняет удовлетворение требований к высокоскоростным задачам машинного зрения в реальном времени. Для решения этой проблемы возникла технология ISC, интегрирующая вычислительные блоки непосредственно в датчики, чтобы приблизить обработку к источнику данных и тем самым реализовать новую парадигму «восприятие как вычисление» [143].
В архитектурах ISC вычислительные модули встраиваются в массивы пикселей или схемы считывания, что позволяет каждому пикселю выполнять основные операции, такие как обнаружение границ, извлечение признаков или предварительное распознавание, в дополнение к фотоэлектрическому преобразованию [144]. Благодаря достижениям в области массивов мемристоров, 2D-полупроводников и оптоэлектронных транзисторов, ISC продемонстрировал большой потенциал для маломощной предварительной обработки изображений и распознавания динамических сцен. Например, Чен и др. [145] разработали массив фотонных синапсов на основе MoS2 с функциями памяти и вычислений, позволяющий кодировать признаки непосредственно на стороне датчика. Фабр и др. [146] продемонстрировали, что выполнение линейной свертки и нелинейной активации на уровне пикселей может значительно уменьшить объем выходных данных и требования к полосе пропускания.
Внедрение фотонных вычислений еще больше расширило потенциал ISC. Благодаря массивному параллелизму и сверхширокой полосе пропускания фотоны позволяют добиться порядкового улучшения в умножении матриц на векторы (MVM) и эффективности свертки [3]. Ву и др. [147] предложили некогерентно-когерентный полностью оптический MAC-оператор и разработали полностью оптический сенсорно-вычислительный чип (OPCA), способный к параллельному восприятию светового поля и высокоскоростным вычислениям. Рен и др. [148] представили гибридную архитектуру мемристор-фотоника, которая выполняет оптическое зондирование, хранение и вывод на одном чипе. Богаертс и др. [149] дополнительно продемонстрировали программируемый фотонный вычислительный чип, открывая путь для реконфигурируемой оптической обработки.
В совокупности эти исследования показывают, что интеграция фотонных вычислений и ISC становится ключевым направлением на пути к созданию высокоскоростных и энергоэффективных систем машинного зрения.
5.2.2. Вычисления в оперативной памяти
В системах EIMV частая передача данных изображений и признаков приводит к так называемой проблеме «стены памяти»: физическое разделение вычислительных и запоминающих блоков вызывает резкое увеличение энергопотребления и задержки, становясь основным узким местом для эффективности устройства. Для решения этой проблемы IMC стала ключевой парадигмой в проектировании аппаратного обеспечения для периферийных вычислений. Основная идея заключается в размещении вычислительных блоков рядом с массивами памяти или внутри них, что позволяет выполнять арифметические операции во время доступа к данным, тем самым значительно сокращая перемещение данных и потребление полосы пропускания [150].
Мемристор, энергонезависимое резистивное устройство с непрерывно настраиваемыми и стабильными состояниями проводимости, служит основной материальной платформой для IMC. Благодаря своей способности выполнять матричные операции непосредственно внутри массивов, он естественным образом подходит для свертки и операций с полными связями в нейронных сетях. Например, Яо и др. [151] предложили двумерный массив мемристоров на основе HfAlO, достигший эффективности матричного умножения 156 TOPS·W −1, в то время как Ся и др. [152] продемонстрировали в Nature Electronics перекрестный массив с синапсоподобной пластичностью для задач извлечения визуальных признаков и классификации границ с низким энергопотреблением.
Помимо двумерных массивов и перекрестных устройств, последние достижения расширили возможности IMC до системной интеграции. Ли и др. [153] разработали трехмерную интегрированную резистивную память с произвольным доступом на основе КМОП-технологии (RRAM-CMOS) с послойным управлением программированием, обеспечивающим многобитовую точность и высокую износостойкость при записи. Аналогично, Ван и др. [154] достигли тесной связи матричных вычислений и хранения весов с использованием резистивной памяти, поддерживая вывод 8-битных CNN непосредственно на периферийных устройствах.
Эти разработки указывают на то, что технология IMC развивается от исследования на уровне устройств к реализации на системном уровне и, как ожидается, станет ключевым фактором для преодоления узкого места в перемещении данных и достижения высокоэффективного интеллектуального вывода в будущих системах EIMV.
5.2.3. Сенсорное управление на основе событий и вычисления, вдохновленные работой мозга.
Интеграция событийного зондирования и вычислений, вдохновленных работой мозга, приводит к кардинальным изменениям в современных системах машинного зрения. Традиционные датчики изображения считывают все пиксели через фиксированные интервалы времени, генерируя огромные объемы избыточных данных и создавая высокую нагрузку на пропускную способность. В отличие от них, событийные датчики выдают асинхронные импульсные события только при изменении яркости сцены, тем самым обеспечивая сжатие данных и оптимизацию энергопотребления на аппаратном уровне [155], [156]. Этот механизм восприятия, основанный на изменениях, делает событийные камеры особенно подходящими для высокоскоростных динамических сценариев, таких как автономное вождение, навигация роботов и полет БПЛА [157].
Выходной сигнал событийной камеры представляет собой неструктурированный поток импульсов, содержащий пространственно-временные вариации на уровне пикселей, что принципиально отличается от традиционных покадровых изображений. Из-за их временного разрешения на уровне микросекунд и высокой разреженности сверточные нейронные сети (CNN) испытывают трудности с прямой обработкой таких данных. Ранние подходы преобразовывали потоки событий в псевдокадры для ввода в CNN [158], но это жертвует преимуществом временной точности данных событий.
Чтобы лучше использовать природу сигналов событий, исследователи представили SNN, которые имитируют дискретную импульсную связь биологических нейронов для естественного моделирования асинхронных потоков событий. SNN работают без глобального тактового генератора и используют вычисления, управляемые событиями, достигая высокой временной точности и низкого энергопотребления [159].
Что касается применения, в некоторых работах по событийному зрению сообщалось о полностью асинхронном обнаружении пешеходов на краю и гибридных системах обнаружения объектов на основе SNN и искусственной нейронной сети (ANN), в то время как другие исследования выделили низкосложные краевые преобразователи и нейроморфные технологии для интеллектуальных краевых вычислений в качестве активных направлений исследований [160], [161], [162].
Ву и др. [163] предложили алгоритм пространственно-временного обратного распространения (STBP), позволяющий SNN обучаться непосредственно на импульсных сигналах и достигать высоких результатов на таких наборах данных, как N-MNIST. Чжан и др. [164] дополнительно разработали модель SNN с логарифмическим временным кодированием, эффективно используя временные параметры импульсов для достижения меньшей задержки и большей эффективности вывода. Эти исследования подчеркивают большой потенциал SNN для обработки изображений на основе событий. Кроме того, сочетание SNN и датчиков событий продемонстрировало значительные преимущества на практике. Нейроморфный чип Loihi [165] выполняет асинхронное визуальное распознавание на устройстве с энергопотреблением всего в 100 раз меньшим, чем у графического процессора. В совокупности эти результаты показывают, что слияние событийного зрения и нейроморфных архитектур формирует новую парадигму интеллектуального восприятия с низким энергопотреблением и высокой временной точностью.
5.2.4. Развертывание больших моделей на периферии сети.
Модели с низкой степенью детализации (LLM) продемонстрировали исключительные возможности в многомодальном понимании, семантическом рассуждении и принятии решений, что делает развертывание LLM на периферии сети все более важным направлением исследований. Недавние исследования сосредоточены на том, как развертывать такие модели — масштабы параметров, объем памяти и вычислительная сложность которых значительно превосходят таковые у традиционных сверточных или трансформерных сетей — на периферийных платформах с ограниченными ресурсами.
Например, Фриха и др. [166] отметили, что системы EI, управляемые LLM, обычно используют иерархическую архитектуру «облако–периферия–устройство», где периферийные узлы обрабатывают маршрутизацию задач и вывод промежуточных признаков, в то время как сложные семантические рассуждения остаются в облаке. Такая конструкция поддерживает точность вывода, одновременно снижая накладные расходы на связь примерно на 95%. Кроме того, были предложены различные методы сжатия моделей для снижения высоких требований к ресурсам больших моделей. Алгоритм Wanda обеспечивает 50% разреженность параметров без переобучения, сохраняя при этом точность более 95% [167]. Ма и др. [168] добились трехкратного снижения энергопотребления за счет квантования сверхнизкой точности с 1,58 битами. Более того, SmoothQuant и AWQ, два метода квантования после обучения, успешно развернули модель LLaMA2 с 70 B-параметрами в рамках бюджета памяти GPU в 48 ГБ, что дополнительно подтверждает возможность вывода LLM на устройстве [169] .
Что касается аппаратной части, новые процессоры, такие как NVIDIA IGX Orin и Qualcomm Snapdragon AI Engine, интегрируют блоки ускорения трансформеров, поддерживая вывод в реальном времени моделей с миллиардом параметров при умеренном энергопотреблении [166]. Между тем, EdgeMoE, модель разреженной смеси экспертов (MoE), обеспечивает 4-кратное ускорение вывода на мобильных устройствах за счет механизма динамического управления [170]. Для распределенного обучения на нескольких граничных узлах такие фреймворки, как FATE-LLM и FedBERT, применяют федеративное обучение для выполнения тонкой настройки с сохранением конфиденциальности, что позволяет проводить персонализированное обучение больших моделей без централизованного обмена данными [171].
В целом, благодаря постоянному прогрессу в обучении с учетом квантования, механизмах разреженного внимания и совместной оптимизации программного и аппаратного обеспечения, будущие периферийные устройства будут все чаще способны запускать крупномасштабные модели с семантическим пониманием и возможностями принятия решений.
Чтобы сделать эти перспективы более осязаемыми, в таблице 6 представлена количественная программа исследований по четырем перспективным направлениям. Вместо того чтобы рассматривать их как чисто концептуальные концепции, в таблице выделены имеющиеся на данный момент доказательства их осуществимости, ключевые технические барьеры и ближайшие этапы. Например, недавние исследования уже продемонстрировали фотонный/внутрисенсорный отклик на уровне наносекунд, эффективность IMC на уровне TOPS на ватт, обнаружение событий на уровне микросекунд со значительной экономией энергии и приблизительно 10 Гц внутриустройственную обработку VLA на передовых периферийных графических процессорах. Эти результаты показывают, что будущее развитие EIMV можно оценивать не только на концептуальном уровне, но и с помощью постепенно измеримых целевых показателей производительности.
Таблица 6. Программа исследований для новых направлений EIMV.
| Будущее направление | Имеющиеся данные о целесообразности | Ключевой технический барьер | Краткосрочный этап |
|---|---|---|---|
| Фотоника/ISC | Задержка 6 нс, прогнозируемая мощность на канал 1 мВт и точность выполнения задачи 93%. | Единообразие устройств и масштабируемое совместное проектирование датчиков и алгоритмов. | Задержка менее микросекунды, мощность на уровне милливатт и сохранение точности более 95%. |
| ИМК | 156 TOPS·W −1 (пиковое значение) и 96% точность выполнения задания | Высокая точность, стабильность, долговечность и многоразрядное управление, совместимое с CMOS-технологией. | > 100 TOPS·W −1 (стабильный) |
| Сенсорное управление на основе событий/нейроморфные вычисления | Разрешение по времени на уровне микросекунд, в 100 раз меньшее энергопотребление и в 50 раз более высокая скорость по сравнению с базовыми показателями CPU/GPU. | Стабильность обучения SNN и совместимость алгоритма с чипом. | Сквозное обнаружение/отслеживание на основе событий с очевидными системными преимуществами в снижении задержки и энергопотребления по сравнению с конвейерами, основанными на кадрах. |
| Развертывание больших моделей на периферии сети | Выполнение VLA-интерференции на устройстве с частотой 10 Гц на современных периферийных графических процессорах. | Рост кэша типа «ключ-значение», объем используемой памяти и многомодальная задержка | Ответ на уровне задачи составляет 10–100 мс |
6. Выводы
В данной статье сначала дается систематическое определение EIMV, описывая его как систему обработки изображений нового поколения, интегрирующую визуальное восприятие, интеллектуальные вычисления и взаимодействие на периферии сети. Затем представлен всесторонний обзор ключевых технологий, лежащих в основе EIMV. С алгоритмической точки зрения, в статье рассматриваются типичные задачи визуального восприятия, эволюция моделей и методы оптимизации с использованием облегченных решений. С аппаратной точки зрения, систематически исследуются вычислительные чипы и архитектуры ускорения, подходящие для периферийного зрения, анализируются различные типы процессоров и соответствующие им стратегии аппаратного ускорения для развертывания EIMV. Кроме того, обсуждаются типичные сценарии применения EIMV, такие как подключенные автономные транспортные средства и системы городского мониторинга. Наконец, в статье изложены текущие проблемы и будущие тенденции развития EIMV, а также представлены идеи и ссылки для дальнейших исследований в этой новой области.
Литература
-
Computer-vision research powers surveillance technologyNature, 643 (8070) (2025), pp. 73-79
-
Technology readiness levels for machine learning systemsNat Commun, 13 (1) (2022), p. 6039
-
A future perspective on in-sensor computingEngineering, 14 (2022), pp. 19-21
- [M. Wu, F.R. Yu, P.X. Liu
Intelligence networking for autonomous driving in beyond 5G networks with multi-access edge computingIEEE Trans Veh Technol, 71 (6) (2022), pp. 5853-5866
-
Federated vehicular transformers and their federations: privacy-preserving computing and cooperation for autonomous drivingIEEE Trans Intell Veh, 7 (3) (2022), pp. 456-465
-
Edge computing: state-of-the-art and future directionsJ Comput Res Dev, 56 (2019), pp. 69-89
-
Edge intelligence: paving the last mile of artificial intelligence with edge computingProc IEEE, 107 (8) (2019), pp. 1738-1762
-
On-demand accelerating deep neural network inference via edge computingIEEE Trans Wirel Commun, 19 (1) (2020), pp. 447-457
-
Artificial intelligence-driven mechanism for edge computing-based industrial applicationsIEEE Trans Industr Inform, 15 (7) (2019), pp. 4235-4243
-
Edge intelligence in intelligent transportation systems: a surveyIEEE Trans Intell Transp Syst, 24 (9) (2023), pp. 8919-8944
-
Leveraging edge artificial intelligence for sustainable agricultureNat Sustain, 7 (7) (2024), pp. 846-854
-
Sony Corporation. Sony releases two new global shutter sensors for vision systems [Internet]. Matawan: Vision Systems Design; 2024 Jun 24 [cited 2025 Nov 10]. Available from: https://www.vision-systems.com/cameras-accessories/image-sensors/article/55091825/sony-releases-two-new-global-shutter-sensors.
-
Sony Corporation. IMX238LQJ CMOS image sensor datasheet [Internet]. Brompton: DatasheetCafe; [cited 2025 Nov 10]. Available from: https://www.datasheetcafe.com/imx238-datasheet-cmos-image-sensor-sony/.
-
Edge computing for autonomous driving: opportunities and challengesProc IEEE, 107 (8) (2019), pp. 1697-1716
-
Deep residual learning for image recognition, IEEE, Las Vegas, NV, USA. Piscataway (2016), pp. 770-778
-
An image is worth 16×16 words: transformers for image recognition at scale., arXiv:201011929 (2020)
-
A survey of techniques for optimizing deep learning on GPUsJ Systems Archit, 99 (2019), Article 101635
-
A survey of AI inference technologies for on-device systemsIEEE Internet Things J, 12 (24) (2025), pp. 51927-51950
-
Hardware platform stripe noise estimation and random noise removal frameworkIEEE Trans Geosci Remote Sens, 62 (2024), pp. 1-13
-
Memory-efficient deformable convolution based joint denoising and demosaicing for UHD imagesIEEE Trans Circuits Syst Video Technol, 32 (11) (2022), pp. 7346-7358
-
Realization of a real-time image denoising system for dashboard camera applicationsIEEE Trans Consum Electron, 68 (2) (2022), pp. 181-190
-
Tracker meets night: a transformer enhancer for UAV trackingIEEE Robot Autom Lett, 7 (2) (2022), pp. 3866-3873
-
Real-time terrain correction of satellite imagery-based solar irradiance maps using precomputed data and memory optimizationRemote Sens, 15 (16) (2023), p. 3965
-
Design of real-time image processing system of medical high-definition electronic endoscope based on FPGA, IEEE, Nanjing, China. Piscataway (2022), pp. 1-6
-
MobileSP: an FPGA-based real-time keypoint extraction hardware accelerator for mobile VSLAMIEEE Trans Circuits Syst I Regul Pap, 69 (12) (2022), pp. 4919-4929
-
Lightweight hardware architecture for object detection in driver assistance systemsInt J Pattern Recognit Artif Intell, 36 (7) (2022), Article 2250027
-
VLSI design of saturation-based image dehazing algorithmIEEE Trans Very Large Scale Integr VLSI Syst, 31 (7) (2023), pp. 959-968
-
Smartphone-based real-time object recognition architecture for portable and constrained systemsJ Real-Time Image Process, 19 (1) (2022), pp. 103-115
-
Hand gestures recognition using edge computing system based on vision transformer and lightweight CNNJ Ambient Intell Humaniz Comput, 14 (3) (2023), pp. 2601-2615
-
A mixed-precision transformer accelerator with vector tiling systolic array for license plate recognition in unconstrained scenariosIEEE Trans Intell Transp Syst, 25 (12) (2024), pp. 20280-20294
-
Lightweight convolutional network with integrated attention mechanism for missing bolt detection in railwaysMetrology, 4 (2) (2024), pp. 254-278
-
Wickramasinghe S, Parikh D, Zhang B, Kannan R, Prasanna V, Busart C. VTR: an optimized vision transformer for SAR ATR acceleration on FPGA. In: Proceedings of the SPIE Defense + Commercial Sensing: Image Sensing Technologies: Materials, Devices, Systems, and Applications XI; 2024 Apr 21–26; Long Beach, CA, USA. Bellingham: SPIE; 2024. p. 138–53.
-
Deep learning based litter identification and adaptive cleaning using self-reconfigurable pavement sweeping robot, IEEE, Mexico City, Mexico. Piscataway (2022), pp. 2301-2306
-
Robustifying the deployment of tinyml models for autonomous mini-vehiclesSensors, 21 (4) (2021), p. 1339
-
Edge and cloud computing approaches in the early diagnosis of skin cancer with attention-based vision transformer through hyperspectral imagingJ Supercomput, 80 (11) (2024), pp. 16368-16392
-
Empointmovseg: sparse tensor-based moving-object segmentation in 3D lidar point clouds for autonomous driving-embedded systemIEEE Trans Comput Aided Des Integr Circuits Syst, 42 (1) (2023), pp. 41-53
-
Edge intelligence: on-demand deep learning model co-inference with device-edge synergy, Association for Computing Machinery, Budapest, Hungary. New York City (2018), pp. 31-36
-
A survey on vision transformerIEEE Trans Pattern Anal Mach Intell, 45 (1) (2023), pp. 87-110
-
State of art IoT and Edge embedded systems for real-time machine vision applicationsIEEE Access, 10 (2022), pp. 58287-58301
-
Deep learningNature, 521 (7553) (2015), pp. 436-444
-
Deep learning in visual tracking: a reviewIEEE Trans Neural Netw Learn Syst, 34 (9) (2023), pp. 5497-5516
-
A survey of convolutional neural networks: analysis, applications, and prospectsIEEE Trans Neural Netw Learn Syst, 33 (12) (2022), pp. 6999-7019
-
A general survey on attention mechanisms in deep learningIEEE Trans Knowl Data Eng, 35 (4) (2023), pp. 3279-3298
-
Squeeze-and-excitation networks, IEEE Computer Society, Salt Lake City, UT, USA. Los Alamitos (2018), pp. 7132-7141
-
CBAM: convolutional block attention module, Springer, Munich, Germany. Cham (2018), pp. 3-19
-
Swin Transformer: hierarchical vision transformer using shifted windows, IEEE Computer Society, Montreal, QC, Canada. Los Alamitos (2021), pp. 10012-10022
-
Pyramid vision transformer: a versatile backbone for dense prediction without convolutions, IEEE Computer Society, Montreal, QC, Canada. Los Alamitos (2021), pp. 568-578
-
Conformer: convolution-augmented transformer for speech recognition, ISCA, Shanghai, China. Baixas (2020), pp. 5036-5040
-
Convnext v2: co-designing and scaling convnets with masked autoencoders, IEEE Computer Society, Vancouver, BC, Canada. Los Alamitos (2023), pp. 16133-16142
-
Model compression and hardware acceleration for neural networks: a comprehensive surveyProc IEEE, 108 (4) (2020), pp. 485-532
-
Learning both weights and connections for efficient neural network, Neural Information Processing Systems Foundation, Montreal, QC, Canada. San Diego (2015), pp. 1135-1143
-
Dynamic network surgery for efficient DNNs, Neural Information Processing Systems Foundation, Barcelona, Spain. San Diego (2016), pp. 1379-1387
-
A threshold neuron pruning for a binarized deep neural network on an FPGAIEICE Trans Inf Syst, E101(D):376–86 (2018)
-
NISP: pruning networks using neuron importance score propagation, IEEE Computer Society, Salt Lake City, UT, USA. Los Alamitos (2018), pp. 9194-9203
-
Sanger: a co-design framework for enabling sparse attention using reconfigurable architectureonline, Association for Computing Machinery, New York City (2021), pp. 977-991
-
Understanding the impact of quantization, accuracy, and radiation on the reliability of convolutional neural networks on FPGAsIEEE Trans Nucl Sci, 67 (7) (2020), pp. 1478-1484
-
NVIDIA. Achieving FP32 accuracy for INT8 inference using quantization aware training with NVIDIA TensorRT [Internet]. Santa Clara: NVIDIA Tech Blog; 2021 Aug 10 [cited 2025 Nov 10]. Available from: https://developer.nvidia.com/blog/achieving-fp32-accuracy-for-int8-inference-using-quantization-aware-training-with-tensorrt/.
-
Intel. Easily optimize deep learning with 8-bit quantization [Internet]. Santa Clara: Intel Communities Blog; 2022 Mar 9 [cited 2025 Nov 10]. Available from: https://community.intel.com/t5/Blogs/Tech-Innovation/Artificial-Intelligence-AI/Easily-Optimize-Deep-Learning-with-8-Bit-Quantization/post/1366571.
-
4-bit CNN quantization method with compact LUT-based multiplier implementation on FPGAIEEE Trans Instrum Meas, 72 (2023), Article 2008110
-
Ultra-low precision 4-bit training of deep neural networksAdv Neural Inf Process Syst, 33 (2020), pp. 1796-1807
-
A comprehensive review of binary neural networkArtif Intell Rev, 56 (11) (2023), pp. 12949-13013
-
XNOR-Net: ImageNet classification using binary convolutional neural networks, Springer International Publishing, Amsterdam, The Netherlands. Cham (2016), pp. 525-542
-
Mobilenetv2: inverted residuals and linear bottlenecks, IEEE Computer Society, Salt Lake City, UT, USA. Los Alamitos (2018), pp. 4510-4520
-
ShuffleNet: an extremely efficient convolutional neural network for mobile devices, IEEE Computer Society, Salt Lake City, UT, USA. Los Alamitos (2018), pp. 6848-6856
-
ShuffleNet v2: practical guidelines for efficient CNN architecture design, Springer International Publishing, Munich, Germany. Cham (2018), pp. 116-131
-
RepVGG: making VGG-style convnets great againonline, IEEE Computer Society, Los Alamitos (2021), pp. 13733-13742
-
Diverse branch block: building a convolution as an inception-like unit, IEEE Computer Society, Virtual. Los Alamitos (2021), pp. 10886-10895
-
Boosting vanilla lightweight vision transformers via re-parameterizationJMLR.org, Vienna, Austria. New York City (2024)
-
The deep learning compiler: a comprehensive surveyIEEE Trans Parallel Distrib Syst, 32 (3) (2021), pp. 708-727
-
Automatic generation of high-performance convolution kernels on ARM CPUs for deep learningIEEE Trans Parallel Distrib Syst, 33 (11) (2022), pp. 2885-2899
-
A coordinated tiling and batching framework for efficient GEMM on GPUs, Association for Computing Machinery, Washington, DC, USA. New York City (2019), pp. 229-241
-
Exploiting bank conflict-based side-channel timing leakage of GPUsACM Trans Archit Code Optim, 16 (4) (2019), pp. 1-24
-
Eyeriss: an energy-efficient reconfigurable accelerator for deep convolutional neural networksIEEE J Solid-State Circuits, 52 (1) (2017), pp. 127-138
-
A survey of FPGA-based accelerators for convolutional neural networksNeural Comput Appl, 32 (4) (2020), pp. 1109-1139
-
ChipNet: real-time LiDAR processing for drivable region segmentation on an FPGAIEEE Trans Circuits Syst I Regul Pap, 66 (5) (2019), pp. 1769-1779
-
Data and hardware efficient design for convolutional neural networkIEEE Trans Circuits Syst I Regul Pap, 65 (5) (2018), pp. 1642-1651
-
In-datacenter performance analysis of a tensor processing unit, Association for Computing Machinery, Toronto, ON, Canada. New York City (2017), pp. 1-12
-
Automated systolic array architecture synthesis for high throughput CNN inference on FPGAs, Association for Computing Machinery, Austin, TX, USA. New York City (2017), pp. 1-6
-
A 34-FPS 698-GOP/s/W binarized deep neural network-based natural scene text interpretation accelerator for mobile edge computingIEEE Trans Ind Electron, 66 (9) (2019), pp. 7407-7416
-
KAM-Net: kilobyte-scale ultralightweight attention-based network for glass defect detection with algorithm/hardware co-designIEEE Trans Instrum Meas, 74 (2025), Article 5041310
-
A systematic methodology for characterizing scalability of DNN accelerators using scale-sim, Association for Computing Machinery, Boston, MA, USA. New York City (2020), pp. 58-68
-
Accelerating CNN inference on ASICs: a surveyJ Systems Archit, 113 (2021), Article 101887
-
An integer-only and group-vector systolic accelerator for efficiently mapping vision transformer on edgeIEEE Trans Circuits Syst I Regul Pap, 70 (12) (2023), pp. 5289-5301
-
COSA plus: enhanced co-operative systolic arrays for attention mechanism in transformersIEEE Trans Comput Aided Des Integr Circuits Syst, 44 (2) (2024), pp. 723-736
-
Auto-vit-acc: an FPGA-aware automatic acceleration framework for vision transformer with mixed-scheme quantization, Association for Computing Machinery, Belfast, United Kingdom. New York City (2022), pp. 109-116
-
Via: a novel vision-transformer accelerator based on FPGAIEEE Trans Comput Aided Des Integr Circuits Syst, 41 (11) (2022), pp. 4088-4099
-
Vitcod: vision transformer acceleration via dedicated algorithm and accelerator co-design, Association for Computing Machinery, Montreal, QC, Canada. New York City (2023), pp. 273-286
-
ViTA: a highly efficient dataflow and architecture for vision transformers, Association for Computing Machinery, Valencia, Spain. New York City (2024), pp. 1-6
-
EQ-ViT: Algorithm-hardware co-design for end-to-end acceleration of real-time vision transformer inference on Versal ACAP architectureIEEE Trans Comput Aided Des Integr Circuits Syst, 43 (11) (2024), pp. 3949-3960
-
DRViT: A dynamic redundancy-aware vision transformer accelerator via algorithm and architecture co-design on FPGAJ Parallel Distrib Comput, 199 (2025), Article 105042
-
HG-PIPE: vision transformer acceleration with hybrid-grained pipeline, Association for Computing Machinery (ACM), Newark, NJ, USA. New York City (2024), pp. 1-9
-
REATA: an efficient vision transformer accelerator featuring a resource-optimized attention design on versal ACAPACM Trans Reconfig Technol Syst, 19 (1) (2026), pp. 1-32
-
An FPGA accelerator for vision transformer with quantization and LUT-based operationsIEICE Trans Inf Syst (2025), Article E109-D:41–8
-
Edge video analytics: a survey on applications, systems and enabling techniquesIEEE Commun Surv Tutor, 25 (4) (2023), pp. 2951-2982
-
Multi-stream scheduling of inference pipelines on edge devices—a DRL approachACM Trans Des Autom Electron Syst, 29 (6) (2024), pp. 1-36
-
CrossVision: real-time on-camera video analysis via common RoI load balancingIEEE Trans Mobile Comput, 23 (5) (2024), pp. 5027-5039
-
Large-scale video analytics with cloud–edge collaborative continuous learningACM Trans Sens Netw, 20 (1) (2024), pp. 1-23
-
PArtNNer: platform-agnostic adaptive edge-cloud DNN partitioning for minimizing end-to-end latencyACM Trans Embed Comput Syst, 23 (1) (2024), pp. 1-38
-
Task offloading with enhanced Deep Q-Networks for efficient industrial intelligent video analysis in edge–cloud collaborationAdv Eng Inform, 62 (2024), Article 102599
-
Intel. “Data is the new oil:” Intel announces new investment $250M in autonomous driving [Internet]. Santa Clara: Intel; 2016 Jun 17 [cited 2025 Nov 11]. Available from: https://mobility21.cmu.edu/data-is-the-new-oil-intel-announces-new-investment-250m-in-autonomous-driving/.
-
Samsung Semiconductor. Autonomous driving and the modern data center—why high-performance memory and storage solutions are essential [Internet]. Seoul: Samsung Newsroom; [cited 2025 Nov 11]. Available from: ссылка.
-
Autonomous vehicles on the edge: a survey on autonomous vehicle racingIEEE Open J Intell Transp Syst, 3 (2022), pp. 458-488
-
A survey on multimodal large language models for autonomous drivingIEEE Trans Intell Veh, 9 (5) (2024), pp. 958-979
-
Computing systems for autonomous driving: state of the art and challengesIEEE Internet Things J, 8 (8) (2021), pp. 6469-6486
-
Zhang P. BYD, Xpeng join Zeekr, Li Auto in adopting Nvidia’s next-gen Thor chip [Internet]. Singapore: CnEVPost; 2024 Mar 19 [cited 2025 Nov 11]. Available from: https://cnevpost.com/2024/03/19/byd-xpeng-adopt-nvidia-thor/.
-
TheFifthDriver. Machine learning driving assistance on FPGA [Internet]. Montreal: Hackster.io; [cited 2025 Nov 11]. Available from:https://www.hackster.io/javier-cristian/thefifthdriver-machine-learning-driving-assistance-on-fpga-98f295.
-
Learning to drive in a Day, Association for Computing Machinery, Montreal, QC, Canada. New York City (2019), pp. 8248-8254
-
Mobileye. Mobileye launches the first camera-only intelligent speed assist to meet new EU Standards [Internet]. Jerusalem: Mobileye; [cited 2025 Nov 11]. Available from: https://www.mobileye.com/news/mobileye-launches-the-first-camera-only-intelligent-speed-assist-to-meet-new-eu-standards/.
-
Eyes on the road. Enabling real-time traffic camera analysis with BrainChip Akida [Internet]. San Jose: Edge Impulse; [cited 2025 Nov 11]. Available from: https: https://www.edgeimpulse.com/blog/eyes-on-the-road-enabling-real-time-traffic-camera-analysis-with-brainchip-akida/.
-
Smart traffic monitoring system using computer vision and edge computingIEEE Trans Intell Transp Syst, 23 (8) (2022), pp. 12027-12038
-
Multi-camera vehicle tracking using edge computing and low-power communicationSensors, 20 (11) (2020), p. 3334
-
Edge computing enabled video segmentation for real-time traffic monitoring in internet of vehiclesPattern Recognit, 121 (2022), Article 108146
-
AspenCore Media. Teardown: microbolometer-based intelligent thermal camera. Hong Kong: EE Times Asia; [cited 2025 Nov 11]. Available from: ссылка.
-
Real-time mask identification for COVID-19: an edge-computing-based deep learning frameworkIEEE Internet Things J, 8 (21) (2021), pp. 15929-15938
-
Rahman MA, Hossain MS. An internet-of-medical-things-enabled edge computing framework for tackling COVID-19. IEEE Internet Things J 2021;8(21):15847–854.
-
Real-time facial expression recognition based on edge computingIEEE Access, 9 (2021), pp. 76178-76190
-
Collaborative edge computing with FPGA-based CNN accelerators for energy-efficient and time-aware face tracking systemIEEE Trans Comput Soc Syst, 9 (1) (2022), pp. 252-266
-
Edge-AI-driven framework with efficient mobile network design for facial expression recognitionACM Trans Embed Comput Syst, 22 (3) (2023), pp. 1-17
-
A cerebellum-inspired prediction and correction model for motion control of a musculoskeletal robotIEEE Trans Cogn Dev Syst, 15 (3) (2023), pp. 1209-1223
-
A survey of brain-inspired intelligent robots: integration of vision, decision, motion control, and musculoskeletal systemsIEEE Trans Cybern, 52 (10) (2022), pp. 11267-11280
-
A survey on soft lower limb cable-driven wearable robots without rigid links and jointsRobot Auton Syst, 144 (2021), Article 103846
-
AMD. Kria KR260 robotics starter kit [Internet]. Santa Clara: AMD; [cited 2025 Nov 11]. Available from: https://www.amd.com/en/products/system-on-modules/kria/k26/kr260-robotics-starter-kit.html.
-
Hitachi, Ltd. Research & Development Group. Bringing together AI and FPGA technologies to overcome the shortcomings of robots [Internet]. Tokyo: Hitachi, Ltd.; [cited 2025 Nov 11]. Available from: https://rd.hitachi.com/_ct/17711703.
-
A survey of embodied AI: from simulators to research tasksIEEE Trans Emerging Top Comput Intell, 6 (2) (2022), pp. 230-244
-
Embodied intelligence weaves a better futureNat Mach Intell, 2 (11) (2020), pp. 663-664
-
Embodied neuromorphic intelligence. Nat Commun, 13 (1) (2022), p. 1024
-
SpikeDyn: a framework for energy-efficient spiking neural networks with continual and unsupervised learning capabilities in dynamic environments, Association for Computing Machinery, San Francisco, CA, USA. New York City (2021), pp. 1057-1062
-
Online continual streaming learning for embedded space applicationsJ Real-Time Image Process, 21 (3) (2024), p. 68
-
EF-train: enable efficient on-device CNN training on FPGA through data reshaping for online adaptation or personalizationACM Trans Des Autom Electron Syst, 27 (5) (2022), pp. 1-36
-
Rt-2: vision-language-action models transfer web knowledge to robotic control, PMLR, Atlanta, GA, USA. Cambridge (2023), pp. 2165-2183
-
OpenVLA: an open-source vision-language-action model, PMLR, Osaka, Japan. Cambridge (2025), pp. 2679-2713
-
SmolVLA: a vision-language-action model for affordable and efficient robotics., arXiv:2506.01844 (2025)
-
How fast can I run my VLA? Demystifying VLA inference performance with VLA-perf., arXiv:2602.18397 (2026)
-
AnywhereVLA: language-conditioned exploration and mobile manipulation., arXiv:2509.21006 (2025)
-
Deep learning for hyperspectral image classification: an overviewIEEE Trans Geosci Remote Sens, 57 (9) (2019), pp. 6690-6709
-
IoT, big data, and artificial intelligence in agriculture and food industryIEEE Internet Things J, 9 (9) (2022), pp. 6305-6324
-
Hyperspectral image classification using CNN: application to industrial food packagingFood Control, 125 (2021), Article 107962
-
Unleashing the potential of on-chip ai-powered hyperspectral hardware computing—a tutorialIEEE Trans Circuits Syst II Express Briefs, 71 (3) (2024), pp. 1733-1737
-
Hardware–software co-design of statistical and deep-learning frameworks for wideband sensing on zynq system on chipIEEE Trans Very Large Scale Integr VLSI Syst, 31 (1) (2023), pp. 79-89
-
The Φ-sat-1 mission: the first on-board deep neural network demonstrator for satellite earth observationIEEE Trans Geosci Remote Sens, 60 (3) (2022), Article 5517414
-
44.3mW 62.4fps hyperspectral image processor for MAV remote sensing, IEEE, Honolulu, HI, USA. Piscataway (2022), pp. 74-75
-
An integrated sensing-computing processor for spectral-based Chinese herbal medicine classification with algorithm-FPGA co-designIEEE Trans Ind Electron, 73 (5) (2025), pp. 7995-8006
-
Near-sensor and in-sensor computingNat Electron, 3 (11) (2020), pp. 664-671
-
Machine learning and computation-enabled intelligent sensor designNat Mach Intell, 3 (7) (2021), pp. 556-565
-
Two-dimensional material-based devices for in-sensor computingnpj Unconv Comput, 2(1):19 (2025)
-
From near-sensor to in-sensor: a state-of-the-art review of embedded AI vision systemsSensors, 24 (16) (2024), p. 5446
-
Parallel photonic chip for nanosecond end-to-end image processing, transmission, and reconstructionOptica, 11 (6) (2024), pp. 831-837
-
Optoelectronic devices for in-sensor computingAdv Mater, 37 (23) (2025), Article 2407476
-
Programmable photonic circuitsNature, 586 (7828) (2020), pp. 207-216
-
Memory devices and applications for in-memory computingNat Nanotechnol, 15 (7) (2020), pp. 529-544
-
Fully hardware-implemented memristor convolutional neural networkNature, 577 (7792) (2020), pp. 641-646
-
Memristive crossbar arrays for brain-inspired computingNat Mater, 18 (4) (2019), pp. 309-323
-
Monolithic three-dimensional integration of RRAM-based hybrid memory architecture for one-shot learningNat Commun, 14 (1) (2023), p. 7140
-
A compute-in-memory chip based on resistive random-access memoryNature, 608 (7923) (2022), pp. 504-512
-
Event-driven vision sensor with in-pixel spatial contrast computation capabilities and on-chip AER sequencerIEEE Trans Circuits Syst I Regul Pap, 72 (4) (2025), pp. 1234-1248
-
Event-based vision: a surveyIEEE Trans Pattern Anal Mach Intell, 44 (1) (2022), pp. 154-180
-
240\times 180 130 db 3 μs latency global shutter spatiotemporal vision sensorIEEE J Solid-State Circuits, 49 (10) (2014), pp. 2333-2341
-
Video to events: recycling video datasets for event cameras, IEEE Computer Society, Seattle, WA, USA. Los Alamitos (2020), pp. 3586-3595
-
Networks of spiking neurons: the third generation of neural network modelsNeural Netw, 10 (9) (1997), pp. 1659-1671
-
Real-time pedestrian detection at the edge on a fully asynchronous neuromorphic system, IEEE Computer Society, Melbourne, VIC, Australia. Los Alamitos (2025), pp. 4958-4967
-
Efficient event-based object detection: a hybrid neural network with spatial and temporal attention, IEEE Computer Society, Melbourne, VIC, Australia. Los Alamitos (2025), pp. 13970-13979
-
a vision transformer with low complexity self attention for edge device, IEEE, Montreal, QC, Canada. Piscataway (2025), pp. 1-5
-
Spatio–temporal backpropagation for training high-performance spiking neural networksFront Neurosci, 12 (2018), p. 331
-
Efficient spiking neural networks with logarithmic temporal codingIEEE Access, 8 (2020), pp. 98156-98167
-
Advancing neuromorphic computing with loihi: a survey of results and outlookProc IEEE, 109 (5) (2021), pp. 911-934
-
LLM-based edge intelligence: a comprehensive survey on architectures, applications, security and trustworthinessIEEE Open J Commun Soc, 5 (2024), pp. 5799-5856
-
Sun M, Liu Z, Bair A, Kolter JZ. A simple and effective pruning approach for large language models. 2024. arXiv:2306.11695.
-
The era of 1-bit LLMs: all large language models are in 1.58 bits., arXiv:2402.17764 (2024)
-
SmoothQuant: accurate and efficient post-training quantization for large language models, PMLR, Honolulu, HI, USA. Cambridge (2023), pp. 38087-38099
-
EdgeMoE: epowering sparse large language models on mobile devices., arXiv:2308.14352 (2023)
-
FATE-LLM: a industrial grade federated learning framework for large language models., arXiv:2310.10049 (2023)
Авторы: Bingrui Zhao, Yaonan Wang, Hui Zhang, Hai Wang, Kaiwen Tang, Xiangdong Liao, Yurong Chen, Xuesan Su, Ating Yin