Системы машинного зрения, которые воспринимают, интерпретируют визуальные данные и обрабатывают их в строго ограниченные временные рамки, лежат в основе таких приложений, как автономное вождение и промышленная инспекция, беспилотные летательные аппараты, точное земледелие и хирургия с визуальным контролем.
Предыстория: Глубокое обучение значительно повысило точность обнаружения, сегментации и отслеживания по сравнению с более ранними методами, однако развертывание в реальном времени на оборудовании с ограниченными ресурсами питания и памяти остается серьезной инженерной проблемой, а большие базовые и компьютерно-языковые модели поднимают дополнительный вопрос: вообще ли такие возможности вписываются в конвейер с ограниченной задержкой.
Методы: В данном обзоре собраны данные из 94 источников (2012–2026 гг.), отобранных в соответствии с нарративно-синтетическим подходом с четкими критериями отбора, охватывающими архитектуры обнаружения/сегментации, сжатие, аппаратные платформы, области применения и интеграцию базовых/компьютерно-языковых моделей, включая сжатые большие модели (например, Segment Anything) и квантование, обрезку и дистилляцию на оборудовании GPU, FPGA, NPU и микроконтроллерах (TinyML).
Результаты: Производительность в реальном времени достигается за счет сочетания легковесных архитектур с аппаратно-ориентированным сжатием, а не только за счет повышения точности; компромиссы существенно различаются в зависимости от архитектуры, разрешения и платформы; а базовые/визуально-языковые модели по-прежнему используются в основном в качестве автономных механизмов обработки данных или асинхронных уровней рассуждений. Выводы: В литературе отсутствуют последовательные результаты тестирования производительности в реальном времени, отчеты о надежности/энергопотреблении и зрелая интеграция базовых моделей; в заключение мы предлагаем конкретные направления дальнейших исследований.
1. Введение
Машинное зрение, использование вычислительных методов для извлечения, интерпретации и обработки информации из изображений и видео, за последнее десятилетие перешло от преимущественно автономной, пакетной дисциплины к дисциплине, где оперативность является центральной инженерной проблемой. Автономное вождение, промышленная инспекция, навигация беспилотных летательных аппаратов (БПЛА), точное земледелие и хирургия под контролем изображений — все это требует визуального восприятия, которое не только точно, но и выполняется в ограниченном временном окне, обычно в десятки миллисекунд, чтобы полученное решение оставалось действительным для физического процесса, в который оно поступает [1, 2, 3]. Это обычно называется работой в реальном времени, что отличает машинное зрение в реальном времени от компьютерного зрения в целом, где точность на статических эталонах часто является основным показателем успеха.
Глубокие сверточные нейронные сети (CNN) изменили картину точности визуального распознавания, начиная с крупномасштабной классификации изображений [4, 5, 6] и распространяясь на обнаружение [1, 7, 8, 9], сегментацию [10] и отслеживание [11, 12], хотя большая часть прогресса была обусловлена бенчмарками, вознаграждающими точность при больших вычислительных бюджетах. Внедрение этой точности в условия реального времени с ограниченными ресурсами потребовало собственных параллельных усилий: одноэтапные детекторы, заменяющие двухэтапный конвейер прямой регрессией [1, 8, 13, 14, 15], легковесные архитектуры на основе сверток с разделяемой глубиной [16, 17] и эффективные варианты графических трансформеров, поддерживающие глобальное внимание в рамках бюджета задержки мобильного класса [18, 19, 20, 21].
Аппаратное обеспечение, на котором работают эти модели, также значительно расширилось: кластеры для обучения в облаке, программируемые пользователем вентильные матрицы (FPGA), встроенные в камеры [5, 22, 23], нейронные процессоры (NPU) в мобильных системах на кристалле (SoC) и миниатюрные системы машинного обучения (TinyML) на базе микроконтроллеров с памятью менее мегабайта [24, 25, 26], выходящие за рамки ранней почти исключительной зависимости от графических процессоров (GPU) серверного класса. Сопоставление задачи с нужной точкой на этом спектре обычно требует сжатия модели посредством квантования, обрезки и дистилляции знаний, каждый из которых имеет свой собственный компромисс между точностью и задержкой [24, 27, 28, 29, 30].
Области применения, определяющие эту работу, имеют совершенно разные ограничения. Автономное вождение должно объединять камеру, лидар и радар, ограничивая при этом наихудшую задержку для принятия решений, критически важных для безопасности [31, 32, 33]. Промышленное машинное зрение должно поддерживать частоту кадров конвейерных установок с почти нулевым уровнем ложноотрицательных результатов [23]. Система машинного зрения, установленная на БПЛА, должна работать в рамках жестких ограничений по размеру, весу и энергопотреблению (SWaP), отслеживая небольшие быстро движущиеся цели [34, 35, 36, 37]. Точное земледелие и медицинское зрение имеют свои собственные ограничения в области визуализации и, для медицины, нормативные ограничения [22, 38]. Поскольку эти области литературы редко взаимодействуют друг с другом, синтез, связывающий алгоритмическую, аппаратную и прикладную работу, имеет практическую ценность как для разработчиков архитектуры, так и для инженеров по внедрению.
Именно этот пробел и пытается восполнить данный обзор. Он охватывает работы по машинному зрению в реальном времени, опубликованные в основном в период с 2012 по 2026 год, с особым вниманием к периоду с 2016 года, когда одноэтапное обнаружение и встроенное ускорение начали развиваться одновременно, а также к волне 2023–2026 годов, когда базовые и компьютерно-языковые модели адаптируются для использования в реальном времени и на периферии сети. Цель состоит в том, чтобы предоставить читателям единую точку отсчета, связывающую алгоритмическое проектирование, сжатие и аппаратное ускорение, а также ограничения на уровне приложений — три аспекта, которые обычно рассматриваются в отдельных областях литературы.
Вклад данного обзора заключается в следующем:
-
Она систематизирует архитектурную литературу по обнаружению, сегментации, отслеживанию и, все чаще, моделям взаимодействия зрения, языка и базовых данных вокруг одного общего ограничения — ограниченной задержки на кадр, в отличие от подхода, ориентированного на точность в автономном режиме, который доминирует в большей части исследований в области компьютерного зрения.
-
В нем этот архитектурный подход связывается с литературой по сжатию моделей и аппаратному ускорению, наглядно демонстрируя, как квантование, обрезка, дистилляция знаний и выбор платформы (облако, периферия, устройство, TinyML) совместно определяют, может ли данная архитектура быть фактически реализована в рамках задержки, пропускной способности и энергопотребления целевого развертывания.
-
В нем рассматриваются пять областей применения (автономное вождение, промышленная инспекция, беспилотные летательные аппараты, точное земледелие, медицинское зрение), глубина которых неизбежно неравномерна, учитывая неравномерность распределения соответствующей литературы по ним. Приводятся количественные примеры из основной литературы, демонстрирующие, как универсальные методы реального времени адаптируются к специфическим для каждой области ограничениям и критериям оценки.
-
В статье критически рассматриваются недостатки существующей литературы по машинному зрению в реальном времени — непоследовательные методы бенчмаркинга, недостаточное освещение показателей надежности и энергопотребления, а также все еще незрелая интеграция больших базовых моделей и моделей взаимодействия зрения и языка в конвейеры обработки данных с ограниченной задержкой — и эти пробелы преобразуются в конкретные направления для будущих исследований.
Раздел 2 посвящен смежным работам по архитектурам обнаружения, сегментации в реальном времени, отслеживанию и эффективным базовым архитектурам, а также подразделу, посвященному базовым и компьютерно-языковым моделям. В разделе 3 изложена методология обзора, методы сжатия и аппаратные платформы. Раздел 4 , самая длинная часть, рассматривает литературу по областям применения, подкрепленную четырьмя рисунками и шестью таблицами, посвященными эволюции архитектуры, компромиссам между точностью и скоростью, уровням развертывания и репрезентативным результатам, а также анализирует системы, интегрированные с базовыми и большими языковыми моделями. В разделе 5 критически рассматриваются ограничения и направления дальнейших исследований, а раздел 6 содержит заключение.
2. Связанные работы
2.1. Архитектуры обнаружения объектов для обработки изображений в реальном времени
Современные архитектуры обнаружения объектов условно делятся на две категории: двухэтапные и одноэтапные. Двухэтапные детекторы начинаются с R-CNN и последующих, генерируя независимые от класса предложения регионов, а затем классифицируя и уточняя каждое из них. Fast R-CNN [9] и Faster R-CNN [ 7 ] сокращают затраты на этот конвейер за счет распределения сверточных вычислений между предложениями и замены внешней генерации предложений на обученную сеть предложений регионов, но при этом обрабатывают каждое предложение индивидуально, поддерживая пропускную способность значительно ниже частоты кадров видео на обычном оборудовании [3, 7].
Одноэтапные детекторы обходят все это стороной, рассматривая обнаружение как прямую регрессию по фиксированной сетке. You Only Look Once (YOLO) положил начало этому, используя оригинальную формулировку Редмона и др. [1], предсказывающую ограничивающие рамки и классы по полным изображениям за один прямой проход. Основные версии (YOLO9000/v2 [39], YOLOv3 [ 2 ], YOLOv4 [2]) добавили многомасштабные головки и, с CSPNet, межэтапные частичные связи [40]. От YOLOv5 [41] произошла ветвь: YOLOv5 и YOLOv8 [42] — это версии Ultralytics без статьи; YOLOv6 [2] был разработан независимо для промышленного применения; YOLOv9 [43] вернулся к исходной линии; а YOLOX [2] отделился, без якорей, с развязанной головкой. Основная линейка возобновляется с YOLOv7 [13], YOLOv10 [14] и YOLOv12 [15]. Single Shot MultiBox Detector (SSD) [8] подключает головки к нескольким разрешениям; EfficientDet [44] применяет составное масштабирование [17] с двунаправленной пирамидой признаков. В обзорах [2, 3] отмечается, что каждое поколение жертвует небольшим увеличением параметров ради непропорционального повышения точности при фиксированной частоте кадров.
Более новая ветвь возвращается к обнаружению на основе трансформеров, следуя DETR [45], который переосмысливает обнаружение как задачу прямого предсказания множества, решаемую с помощью двудольного сопоставления, исключая как генерацию якорей, так и подавление немаксимумов (NMS) за счет гораздо большей сложности обучения и, в своей первоначальной форме, задержки вывода, которая неприемлема для использования в реальном времени. RT-DETR [46] нацелен именно на этот недостаток, сочетая эффективный гибридный кодировщик с механизмом выбора запроса, учитывающим пересечение над объединением (IoU), для достижения скорости реального времени, сохраняя при этом формулировку предсказания множества без NMS. Он сообщает о точности, сопоставимой или превосходящей точность детекторов YOLO сопоставимого размера при эквивалентной задержке, что авторы приводят в качестве доказательства того, что детекторам на основе трансформеров больше не нужно отказываться от возможности работы в реальном времени ради архитектурных преимуществ предсказания на основе множеств.
Помимо ограничивающих рамок, задачи на уровне экземпляров и пикселей развиваются по тому же принципу. Mask R-CNN [10] добавляет параллельную ветвь предсказания маски к Faster R-CNN, ценой задержки двухэтапного конвейера, что подталкивает дальнейшую работу к одноэтапной сегментации экземпляров. В обзорах, ориентированных на автомобильную и промышленную отрасли [33, 47], отмечается, что выбор модели редко основывается только на точности эталонного набора данных: скорость вывода на целевой платформе, устойчивость к артефактам, таким как размытие движения, и соответствие производственному конвейеру — все это имеет реальное значение [23].
2.2. Семантическая сегментация в реальном времени
Семантическая сегментация маркирует каждый пиксель, что делает её более ресурсоёмкой с точки зрения вычислительных затрат, чем обнаружение при сопоставимом разрешении. Ранние сети реального времени, такие как ENet [48], отказались от репрезентативной способности, используя агрессивное раннее понижение разрешения и компактный кодировщик-декодер, чтобы достичь интерактивной частоты кадров на встроенных графических процессорах. Более поздние архитектуры с двойным разрешением, такие как DDRNet [49], вместо этого используют две параллельные ветви: глубокую ветвь низкого разрешения для контекста и неглубокую ветвь высокого разрешения для пространственных деталей, широко используемые для сегментации дорожной обстановки.
Сравнительные исследования сегментации в реальном времени [48, 50] показывают, что пространство проектирования в значительной степени определяется несколькими повторяющимися стратегиями: многоветвевая/многоразрешающая обработка, отделяющая контекст от пространственной точности, эффективная факторизация свертки [16] и дистилляция знаний из более крупных сетей учителей. Исследование, ориентированное на дистанционное зондирование [48], показало, что переход от городских изображений к аэрофотоснимкам/спутниковым снимкам заметно меняет их компромисс между точностью и задержкой, что напоминает о том, что производительность сегментации в реальном времени зависит совместно от предметной области, разрешения и оборудования.
2.3. Отслеживание нескольких объектов в системах реального времени
Отслеживание по обнаружению остается доминирующим методом для отслеживания нескольких объектов в реальном времени (MOT): покадровый детектор предлагает рамки, а модуль ассоциации связывает обнаружения в устойчивые треки. SORT [11] формализовал это с помощью фильтра Калмана и присвоения по венгерскому алгоритму на основе перекрытия рамок, достигнув высокой пропускной способности, но страдая от переключения идентичности при окклюзии. DeepSORT [12] добавил к стоимости обученное встраивание внешнего вида, пожертвовав некоторой скоростью ради лучшего сохранения идентичности, и стал распространенной основой для встроенного отслеживания в паре с детекторами семейства YOLO [51]. ByteTrack [52] вместо этого сохраняет и связывает обнаружения с низкой степенью достоверности, а не отбрасывает их, восстанавливая треки, которые в противном случае были бы потеряны из-за окклюзии или размытия движения без дополнительной модели внешнего вида.
Обзоры MOT на основе глубокого обучения [51] показывают, что в режиме реального времени детектор, а не трекер, обычно является основной статьей расходов, поэтому выбор конструкции трекера, как правило, делается с одной целью: минимизировать дополнительную задержку, накладываемую на уже ограниченный по задержке детектор. Та же закономерность наблюдается в слежении с помощью БПЛА [34, 35], где урезанные одноступенчатые детекторы сочетаются с легкими ассоциативными или сиамскими сетевыми трекерами, чтобы оставаться в пределах размеров, веса и энергопотребления небольших воздушных платформ.
2.4. Эффективные магистрали на основе трансформаторов
Исторически сложилось так, что проектирование базовой сети определяло большую часть компромисса между точностью и задержкой, доступного на последующих этапах. Остаточные соединения ResNet [4] позволили создать значительно более глубокие сети без более раннего ухудшения качества простых сетей, в то время как сети в стиле VGG [5] показали, что простые, однородные сверточные стеки 3 × 3 могут достигать конкурентоспособной точности при высоких затратах на параметры. Надежное обучение такой глубины само по себе стало важным шагом вперед: пакетная нормализация [53] снизила чувствительность к инициализации и скорости обучения и используется, в основном без комментариев, практически во всех базовых сетях и детекторах, обсуждаемых здесь и в разделе 2.1 . MobileNetV2 [16] ориентирован на мобильное развертывание непосредственно с помощью разделяемых по глубине сверток и инвертированных остаточных блоков, существенно сокращая операции умножения-накопления (MAC); MobileNetV3 [54] добавил поиск архитектуры с учетом аппаратного обеспечения с помощью алгоритма NetAdapt, показав на 3,2% более высокую точность ImageNet, чем MobileNetV2, при на 20% меньшей задержке; а EfficientNet [17] обобщил это посредством составного масштабирования глубины, ширины и разрешения при фиксированном бюджете.
Архитектура трансформера [55] и визуальный трансформер (ViT) [18] открыли параллельное направление исследований базовых архитектур, построенных на самовнимании, а не на свертке. Оригинальный ViT дорог по сравнению с сопоставимыми сверточными базовыми архитектурами, поэтому в более поздних работах стремились к эффективности в реальном времени: Swin Transformer [19] ограничивает самовнимание локальными, сдвинутыми окнами, переводя сложность с квадратичной на линейную в зависимости от размера изображения; MobileViT [20] смешивает сверточные и трансформерные блоки для лучшего компромисса между точностью и параметрами на мобильном оборудовании; а EfficientFormer [21] использует поиск архитектуры, управляемый задержкой, чтобы соответствовать скорости класса MobileNet, сохраняя при этом большую часть преимущества самовнимания в точности. Гибридные конструкции свертки и внимания по-прежнему превосходят чистые трансформеры по компромиссу в реальном времени, хотя разрыв сокращается с каждым поколением [20, 21].
2.5. Базовые модели и модели «зрение-язык» для визуального восприятия
Отдельное, быстро развивающееся направление работы расширяет архитектуры типа «базовая сеть — головная сеть» с помощью больших, предварительно обученных базовых моделей, связывающих визуальное восприятие с пониманием языка. CLIP [56] совместно обучает кодировщик изображений и текста на больших парах изображений и текста для создания общего пространства встраивания, что позволяет проводить классификацию без предварительного обучения и тонкой настройки, и стал стандартным кодировщиком во многих системах, рассматриваемых ниже. Модель Segment Anything Model (SAM) [57] расширяет это до сегментации на уровне пикселей с помощью задачи с подсказками, кодировщика изображений, кодировщика подсказок и легковесного декодера масок, создающего допустимую маску для ранее не встречавшихся категорий, обученного на наборе данных SA-1B с миллиардом масок. Grounding DINO [58] преследует связанную, ориентированную на обнаружение цель, объединяя детектор-трансформатор с кодировщиком текста для локализации с открытым набором данных, обусловленной языком, без переобучения.
Что касается языка, большие языковые модели (LLM) были объединены с визуальными кодировщиками для создания многомодальных моделей «зрение-язык» (VLM), способных отвечать на открытые визуальные вопросы, создавать подписи и следовать инструкциям. LLaVA [59] соединяет предварительно обученный кодировщик CLIP с LLM через облегченный проекционный слой, точно настроенный на основе машинно-генерируемых данных инструкций, для создания универсального визуального помощника. В обзоре, посвященном робототехническому зрению [60], задокументировано быстрое внедрение одновременной локализации и картографирования (SLAM), 3D-обнаружения, навигации и манипуляций, при этом развертывание в реальном времени, кросс-модальное выравнивание и адаптация предметной области названы центральными открытыми проблемами.
Проблема здесь очевидна: базовые и графические модели, в исходном виде, слишком велики для работы в реальном времени при ограниченных ресурсах. Один только кодировщик SAM обрабатывает более 600 миллионов параметров и несколько сотен миллиардов операций с плавающей запятой (FLOP) на изображение; сопоставимые графические модели обычно требуют серверных графических процессоров для обеспечения интерактивной задержки. Одно из направлений работы устраняет этот пробел, применяя сжатие, описанное в разделе 3.2 : EdgeSAM [61] заменяет кодировщик SAM мобильной магистралью, созданной на основе оригинала, достигая более 30 кадров в секунду (FPS) на смартфонах. Второе направление перепроектирует модель для развертывания на периферии с самого начала (MiniCPM-V [62] обеспечивает производительность уровня GPT-4V на мобильном телефоне). Эти аспекты более подробно обсуждаются в разделе 4.9.
3. Методология
3.1. Методология обзора и выбор источников
Данная статья написана в формате нарративно-синтетического обзора, а не формального протокола систематического обзора, что является преднамеренным выбором: область исследования охватывает несколько крупных, независимо развитых подобластей (обнаружение, сегментация, отслеживание, сжатие, аппаратное ускорение, базовые и компьютерно-языковые модели), каждая из которых уже охвачена специализированными систематическими обзорами. Для проведения единого поиска, соответствующего требованиям PRISMA (Preferred Reporting Items for Systematic Reviews and Meta-Analyses), по всем этим подобластям потребовалась бы поисковая строка либо настолько широкая, что возвращала бы неуправляемый, в значительной степени нерелевантный объем данных, либо достаточно узкая, чтобы незаметно исключить целые подобласти. Название отражает этот выбор, описывая работу как нарративный обзор, а не как всеобъемлющее исследование. Остальная часть этого подраздела максимально четко описывает область исследования, критерии отбора и процесс идентификации источников, насколько это позволяет нарративный формат.
Для включения в исследование «машинное зрение в реальном времени» определяется как любая система, метод или компонент, для которых источник сообщает или явно предназначен для поддержки ограниченной задержки на кадр или на принятие решения, совместимой с онлайн-работой, что подтверждается как минимум одним из следующих признаков: (i) заявленным показателем частоты кадров (FPS) или задержкой на кадр на указанном оборудовании; (ii) явной целью проектирования обработки в реальном времени или в режиме онлайн, независимо от того, сообщается ли показатель FPS; или (iii) статусом базовой архитектуры, набора данных или метода, от которого зависит значительная часть рассмотренной литературы, даже без указания частоты кадров. Эта третья категория, используемая экономно, позволяет включить оригинальные работы по ResNet или Vision Transformer, актуальность которых для реального времени устанавливается косвенно через архитектуры, построенные на их основе.
Критерии отбора: Включены: рецензируемые публикации (журнальные статьи, материалы конференций и главы книг), в том числе те, которые представляют архитектуру, набор данных или метод, ставшие стандартом в области машинного зрения в реальном времени, опубликованные в 2012–2026 годах, на английском языке, поддающиеся независимой проверке. Исключены: непроверяемые источники, источники не на английском языке и источники, выходящие за рамки операционного определения (например, статьи о точности пакетной обработки в автономном режиме без цели исследования в реальном времени). Кандидаты были выявлены с помощью структурированных запросов к IEEE Xplore, ACM DL, SpringerLink, ScienceDirect и MDPI, комбинирующих слова «в реальном времени», «машинное зрение», «обнаружение объектов», «встроенные», «граничные», «FPGA», «TinyML», «модель компьютерного зрения и языка» и «базовая модель» с названиями архитектур («YOLO», «SAM»). Точные подсчеты записей по каждой базе данных, подобные тем, которые отображаются в диаграмме PRISMA, не регистрировались, это ограничение было рассмотрено в разделе 5.1 . На рисунке 1 качественно представлена сводная информация о процессе сужения круга кандидатов до 94 отобранных источников.
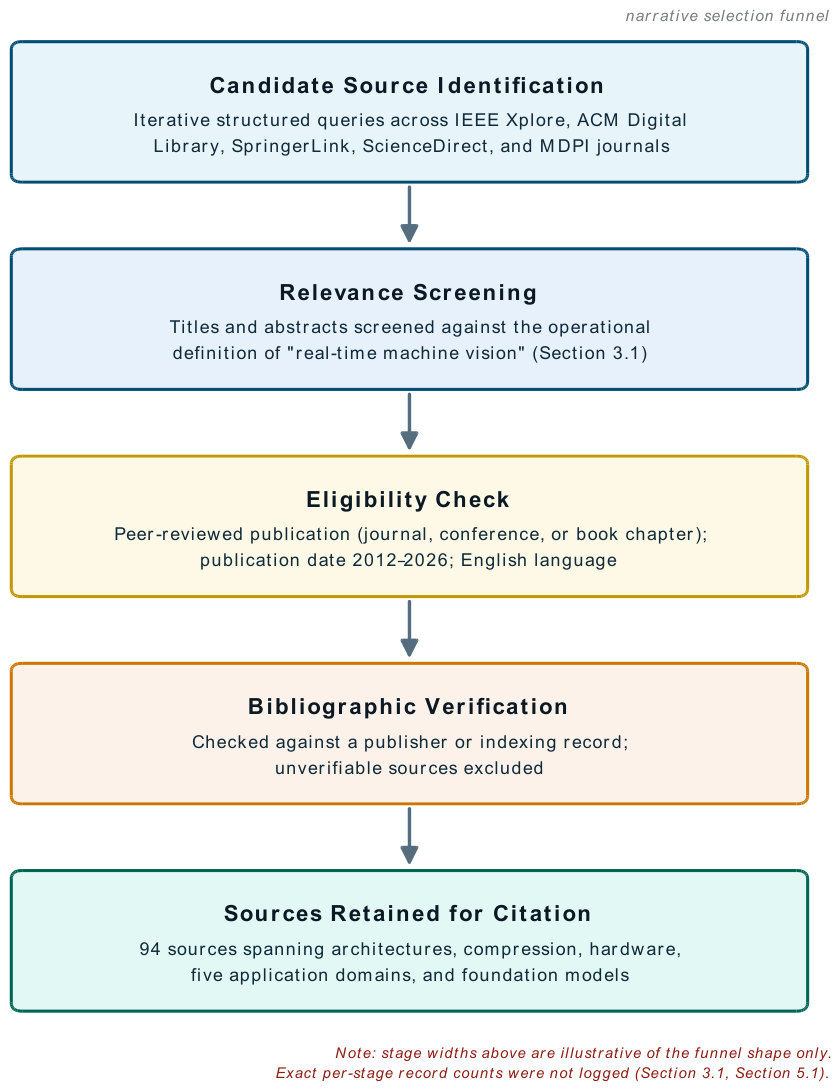
Рисунок 1. Качественная воронка отбора источников для данного нарративного обзора, от идентификации кандидатов и библиографической проверки до 94 источников, отобранных для цитирования. Поскольку это нарративный, а не систематический обзор, ширина этапов иллюстрирует форму воронки и не проверяется по количеству записей на каждом этапе (раздел 3.1 и раздел 5.1).
Пять областей (вождение, промышленная инспекция, БПЛА, сельское хозяйство, медицинское зрение) были выбраны на этапе определения масштаба исследования как реализующие пять качественно различных ограничений на «реальное время»: жесткое, критически важное для безопасности ограничение наихудшей задержки (вождение); ограничение на устойчивую пропускную способность (промышленность); ограничение по размеру, весу и мощности (БПЛА); ограничение по энергии и связности (сельское хозяйство); и ограничение на подтвержденную точность в рамках бюджета кадра, а не на скорость (медицина), разработанное в разделе 4.8 . Другие области, по которым проводились значительные исследования (наблюдение, зрение в условиях низкой освещенности), также рассматривались, но обсуждались менее подробно (раздел 4.8), поскольку их ограничения в значительной степени совпадают с пятью выбранными. Соответственно, глубина охвата различных областей неравномерна: разделы 4.3 и 4.5 опираются на более обширную и разнородную базу данных, чем разделы 4.4 и 4.7, что отражает относительный объем литературы, а не предполагаемый баланс, как это прямо указано в разделе 5.1 .
Поскольку это обзор, а не эмпирическое исследование, описанные ниже «методы» представляют собой технические подходы, описанные в основной литературе, и разделены на сжатие (раздел 3.2), аппаратные платформы (раздел 3.3) и эталонные наборы данных/метрики (раздел 3.4). Новые эксперименты, наборы данных или обучение не проводились; все количественные результаты в разделе 4 получены из оригинальных публикаций или напрямую ссылаются на них.
Позиционирование относительно существующих опросов
Несколько существующих обзоров охватывают часть этой территории. Обзоры, ориентированные на обнаружение (Terven et al. [2]; Zou et al. [3]), углубляются дальше раздела 2.1, но не связывают его с аппаратными или прикладными ограничениями. Обзоры по сжатию [27, 30] углубляются дальше раздела 3.2 , но не организованы вокруг требований реального времени. Обзоры, посвященные конкретным областям (сегментация [48]; отслеживание [51]; БПЛА [37]; вождение [33]; модели VLM для робототехнического зрения [60]), каждый из которых превосходит по глубине любой отдельный подраздел раздела 4, охватывают максимум одну или две области одновременно. В таблице 1 приведено краткое описание этого позиционирования; вклад данного обзора заключается в объединении обнаружения, сегментации, отслеживания, сжатия, аппаратного обеспечения, пяти областей и базовых/языковых моделей зрения в единое повествование, организованное вокруг ограниченной задержки реального времени.
Таблица 1. Позиционирование данного обзора относительно существующих исследований с частично совпадающей тематикой, обсуждавшихся в разделе 3.1.
| Существующее обследование | Глубина обнаружения | Глубина сжатия/водо-непрони-цаемости | Области применения, охваты-ваемые данной областью: | Покрытие Foundation / VLM |
|---|---|---|---|---|
| Тервен и др. [ 2 ] (обзор YOLO) | Очень высокий (специфичный для YOLO) | Низкий | Нет (только архитектура) | Никто |
| Зоу и др. [ 3 ] (20-летнее исследование обнаружения) | Высокий (общее обнаружение) | Низкий | Нет (только архитектура) | Никто |
| Брони-Бедиако и др. [ 48 ] (сегментация) | Нет (ориентировано на сегментацию) | Низкий | Только дистан-ционное зонди-рование | Никто |
| Чапарроне и др. [ 51 ] (опрос ТО) | Умеренный (ориентирован на отслеживание) | Низкий | Нет (только задача) | Никто |
| Виджаякумар и Вайравасундарам [ 37 ] (БПЛА) | Умеренный | Низкий | Только БПЛА | Никто |
| Юртсевер и др. [ 33 ] (исследование автономных транспортных средств) | Умеренный | Низкий | Только автономное вождение | Никто |
| Хан и др. [ 60 ] (опрос VLM с помощью робота-зрителя) | Низкий | Низкий | Только робото-техника | Высокий |
| Этот отзыв | Умеренный | Умеренно-высокий | Пять областей, совместно | Умеренный уровень (специальный раздел) |
3.2. Методы моделирования сжатия и ускорения
В литературе встречаются три метода сжатия: квантизация, обрезка и дистилляция знаний. Квантизация снижает числовую точность (обычно с FP32 до INT8 или ниже), уменьшая объем памяти и затраты на умножение-накопление на поддерживающем оборудовании [24]. Квантизация после обучения применяется после обучения с полной точностью; обучение с учетом квантизации имитирует снижение точности во время обучения и, как правило, теряет меньше точности при заданной битовой ширине [24, 25]. Квантизация только с целочисленной арифметикой, обученная таким образом, улучшила компромисс между задержкой и точностью MobileNet на процессорах ARM как для классификации ImageNet, так и для обнаружения COCO [63]. Сочетание квантизации со структурированной обрезкой (обрезка с учетом квантизации) создает более эффективные модели, чем каждая из них по отдельности, для вывода, критичного к задержке [25].
Обрезка удаляет избыточные параметры или структуры из обученной сети. Неструктурированная обрезка уменьшает отдельные веса по критерию значимости, сокращая количество параметров, но не обязательно задержку без специальной аппаратной поддержки разреженных матриц [28, 30]. Структурированная обрезка удаляет целые каналы, фильтры или слои, уменьшая количество выполняемых плотных тензоров и более надежно приводя к ускорению на оборудовании GPU/FPGA [29]. Применительно к детекторам, обрезка на уровне каналов и слоев моделей семейства YOLO (SlimYOLOv3 [35]; обрезанная YOLOv4 для БПЛА [34]) уменьшает размер модели и количество операций с плавающей запятой на порядок с небольшим снижением средней точности (mAP) при условии тонкой настройки после обрезки [34, 35]. Например, обрезка каналов и слоев YOLOv4 для обнаружения небольших дронов уменьшила размер модели с 245 МБ до 15,1 МБ при сохранении 90,5% mAP и повышении скорости на 60,4% до 69 FPS [64]. Обзоры эффективных CNN и их аппаратного ускорения [65] добавляют, что сети со структурной обрезкой по-прежнему работают на оборудовании общего назначения, в то время как разреженные ускорители могут быть разработаны для экономии энергии и памяти в разреженных сетях. Обзоры методологии обрезки [30] предупреждают, что сообщаемые ускорения сильно зависят от целевого оборудования и программного стека.
Дистилляция знаний обучает меньшую сеть «ученика» воспроизводить распределение выходных данных большей сети «учителя», используя смягченные вероятности учителя в качестве дополнительного сигнала обучения, следуя формулировке, первоначально предложенной Хинтоном и коллегами и теперь подробно рассмотренной в специальных обзорах [ 66 ]: относительная вероятность, которую учитель присваивает неправильным классам, несет информацию, которой нет у одних только жестких меток [27]. Дистилляция работает на уровне цели обучения, а не структуры сети, и часто сочетается с квантованием или обрезкой в упорядоченном конвейере (например, обрезка с последующей тонкой настройкой с учетом квантования с помощью функции потерь дистилляции) [27]. Глубокое сжатие [28], ранний конвейер, сочетающий обрезку, обученное квантование и энтропийное кодирование, задал шаблон, которому до сих пор следуют более поздние конвейеры: взаимодополняющие этапы сжатия, применяемые последовательно, с тонкой настройкой между ними.
Связанный, но отличающийся подход к повышению эффективности — это поиск нейронной архитектуры (NAS), оптимизирующий саму топологию сети. Зоф и Ле [67] охарактеризовали это как обучение с подкреплением; аппаратно-ориентированные варианты включают измеренную задержку/энергию в целевую функцию. Масштабирование EfficientNet [17] и топология слияния EfficientDet [44] являются выгодными результатами. Дополнительные методы: вывод со смешанной точностью почти вдвое уменьшает объем памяти на оборудовании FP16 без риска для точности, характерного для INT8 [68]; оптимизация компилятора (TVM) позволяет использовать слияние операторов для устранения разрыва между FLOPs и задержкой [69], а наборы инструментов (TensorRT, ONNX) применяют аналогичные оптимизации на практике, при этом тест Jetson для 3D-детекторов показал, что TensorRT сохраняет точность обнаружения, значительно увеличивая FPS [70]; Низкоранговая факторизация разлагает тензоры весов с умеренными затратами на точность [71]; а оптимизация доступа к памяти минимизирует внечиповый трафик, решаемый такими ускорителями, как FINN [72].
Теоретическая сложность модели (FLOPs/MACs) коррелирует с измеренной задержкой слабее, чем иногда подразумевается в литературе по сжатию. FLOPs предполагают, что вычислительные ресурсы являются основным ресурсом, но измеренная задержка часто ограничена пропускной способностью памяти: операции с одинаковым количеством FLOPs могут отличаться в несколько раз по задержке в зависимости от схемы доступа к памяти и возможностей оборудования [24, 30]. Поглубоко разделяемые свертки уменьшают количество FLOPs [16], но обеспечивают меньший прирост задержки без специальной аппаратной поддержки, поскольку результирующие слои более зависимы от памяти на каждый FLOP. Обрезка показывает ту же закономерность: неструктурированная обрезка может уменьшить количество FLOPs с небольшим измеренным ускорением при отсутствии поддержки разреженных матриц [28, 30], в то время как структурированная обрезка более надежно приводит к ускорению за счет уменьшения фактически выполняемых плотных тензоров [29]. Уменьшение количества FLOPs само по себе не следует рассматривать как показатель задержки без аппаратного подтверждения.
3.3. Аппаратные платформы для развертывания в режиме реального времени
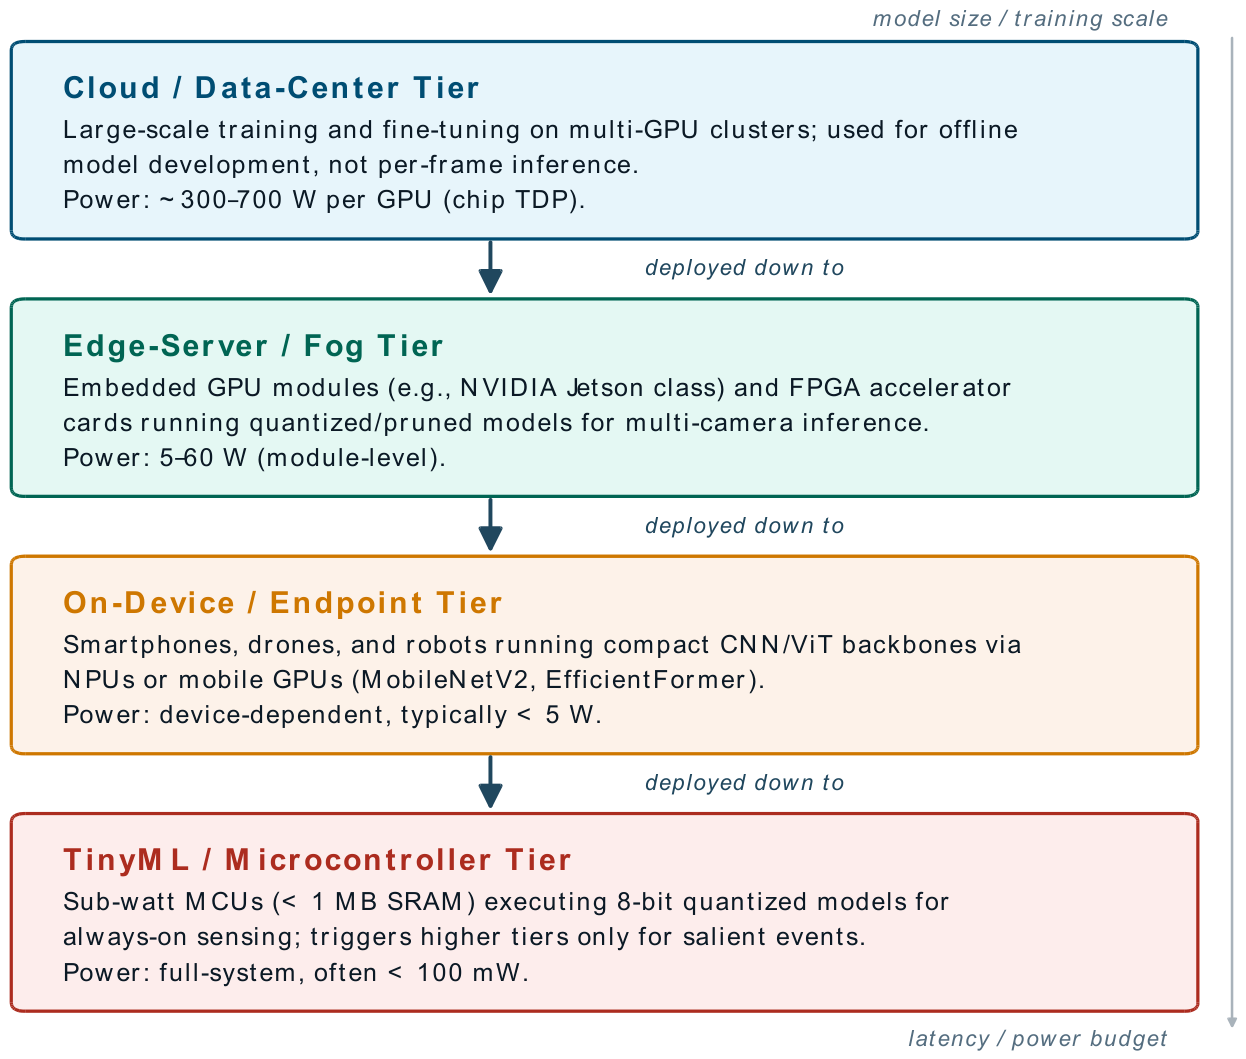
Доступное для машинного зрения в реальном времени оборудование делится на четыре основных уровня, схематически представленных в разделе 4.1 . Облачные системы и системы центров обработки данных используются в основном для обучения, а не для развертывания вывода. Системы периферийных серверов/туманных вычислений (встроенные модули GPU, карты FPGA) обрабатывают многокамерные или высокопроизводительные выводы вблизи данных. Конечные устройства (смартфоны, дроны, роботы) используют компактные магистрали на базе мобильных GPU или NPU, в то время как развертывания TinyML на микроконтроллерах запускают сильно квантованные модели в рамках энергопотребления от доли милливатт до примерно одного ватта [ 24 , 25 , 26 ].
Ускорение на основе FPGA привлекло внимание, поскольку позволяет реализовать поток данных сжатой сети непосредственно в реконфигурируемой логике, минуя накладные расходы процессоров общего назначения. Сообщается, что реализации облегченных CNN на FPGA (MobileNetV2, SqueezeNet, ResNet18) достигают задержки в одну-две миллисекунды, близкой к точности GPU с полной точностью, при значительно меньшем энергопотреблении [ 5 , 22 ]. Этот подход восходит к таким фреймворкам, как FINN [ 72 ], который отображает бинаризованные сети на гетерогенную потоковую архитектуру, достигая задержки менее микросекунды при потреблении менее 25 Вт для классификации небольшого масштаба. Инструментальные цепочки, такие как Xilinx Vitis AI, автоматизируют отображение квантованной модели на битовый поток, хотя достигнутая пропускная способность остается чувствительной к потоку данных и пропускной способности памяти [22, 23].
На другом конце спектра находятся развертывания TinyML, ориентированные на микроконтроллеры с встроенной памятью менее мегабайта и энергопотреблением менее ватта, работающие с агрессивно квантованными (часто 8-битными) моделями, которые часто дополнительно обрезаются или дистиллируются [24, 25, 26]. В настоящее время открытые фреймворки автоматизируют 8- и 16-битное квантование и развертывание на 32-битных микроконтроллерах, и один из таких фреймворков был сравнен с тремя механизмами вывода на двух микроконтроллерах [73], что делает механизм вывода еще одной переменной, о которой следует сообщить. Поскольку они не могут поддерживать непрерывный вывод с полным разрешением, они обычно используют каскадную конструкцию: микроконтроллер обрабатывает недорогую задачу запуска и передает управление на более высокий уровень только после запуска, что является распространенной схемой в обзорах TinyML для умных городов, промышленности и сельского хозяйства [26].
В разделе 4.9 представлены типичные варианты аппаратного обеспечения и набора инструментов на каждом уровне развертывания, основанные на кроссплатформенном бенчмаркинге. Независимые сравнения встроенных графических процессоров, периферийных тензорных процессоров (TPU) и процессоров глубокого обучения на базе FPGA не выявили единого преимущества какой-либо одной платформы по всем показателям: FPGA обычно обеспечивают наименьшую задержку на кадр после компиляции в битовый поток, периферийные TPU предлагают наилучшую точность на ватт для моделей INT8, а встроенные графические процессоры обеспечивают наиболее гибкий путь разработки при более высоком энергопотреблении [74, 75]. Это подтверждает тезис раздела 3.2 о том, что выбор метода сжатия и уровня развертывания взаимосвязаны, а не независимы, поскольку фактическая скорость сжатой модели зависит от того, насколько хорошо ее операции отображаются на целевом оборудовании.
Сравнение задержки на платформах GPU, FPGA, NPU, edge TPU и микроконтроллерных блоков (MCU) более рискованно, чем предполагает многоуровневая структура раздела 4.1. Приведенная цифра зависит от узла процесса/тактовой частоты; численной точности (каждый шаг примерно вдвое-вчетверо уменьшает трафик памяти и вычислительные ресурсы); размера пакета (задержка пакета 1 несопоставима с пропускной способностью пакета 32 [14]); разрешения входных данных; пропускной способности памяти; включена ли передача данных между хостом и устройством; и включены ли предварительная/постобработка. Два исследования, в которых сообщается о «задержке в 30 мс», могут быть несопоставимы при разных соглашениях. Тестирование детекторов на встроенных платформах показывает масштаб эффекта: самые быстрые модели работали примерно за 20 мс, но дополнительная обработка ЦП добавила примерно 25 мс, доведя весь конвейер почти до 50 мс, или около 20 кадров в секунду [76]. Там, где в литературе приводятся данные об этих переменных, мы их отмечаем (например, результаты работы детектора с обрезкой, описанные в разделе 4.5, касаются модели, платформы и задачи [34]); в противном случае утверждения соответственно уточняются.
Энергоэффективность
В большинстве исследований энергоэффективность рассматривается как второстепенное следствие, а не как основной показатель, заслуживающий более прямого рассмотрения, чем качественные диапазоны мощности, представленные в сводке уровней в разделе 4.1 . Показатели мощности, сообщаемые в исследованных источниках, охватывают примерно три порядка величины, а в таблице 2 перечислены переменные, которые затрудняют их сравнение. Бинаризованная реализация FINN на FPGA сообщает о задержке менее микросекунды при потреблении менее 25 Вт [72]; графические процессоры класса Jetson сообщают о потреблении 5–60 Вт в зависимости от модуля и режима питания, при этом задержка варьируется более чем в два раза между режимами [74]; а развертывания TinyML работают в бюджете менее ватта, часто менее 100 мВт, по своей конструкции [24, 25, 26]. Энергоэффективность и необработанная задержка лишь слабо связаны, и почти ни один из основных источников не сообщает стандартизированный показатель энергии на вывод наряду с задержкой и точностью, что ограничивает сравнение между исследованиями (раздел 5.1).
Таблица 2. Переменные, которые искажают результаты сравнения задержки и эффективности на разных платформах ( Раздел 3.3 ).
| Вмешивающаяся переменная | Почему это важно | Репрезентативный заявленный диапазон | Ссылки. |
|---|---|---|---|
| Технологический узел/тактовая частота | Различные версии микросхем обеспечивают разную задержку при одинаковой точности. | Зависит от устройства; редко упоминается в научных статьях, посвященных зрению. | [74] |
| Численная точность (FP32/FP16/INT8) | Каждый шаг повышения точности примерно вдвое или вчетверо сокращает объем операций с памятью и вычислительных ресурсов. | INT8 обычно в 2–4 раза быстрее, чем FP32 на поддерживаемом оборудовании. | [22, 24] |
| Размер партии | Задержка в первом пакете данных несопоставима с пропускной способностью в третьем пакете данных. | В результатах тестов обычно указываются данные по первой или двенадцатой партии, редко — по обеим одновременно. | [14] |
| Входное разрешение | Масштаб вычислений примерно пропорционален количеству пикселей, что увеличивает как задержку, так и точность. | 320–640 пикселей — типичный размер для детекторов реального времени. | [1, 13] |
| Подсистема памяти/пропускная способность | Слои, ограниченные объемом памяти, не получают выгоды от дополнительных вычислительных ресурсов. | Зависит от устройства | [24, 30] |
| Включение передачи данных на хост-устройство | Задержка от начала до конца и задержка только на устройстве могут существенно различаться. | Редко сообщается отдельно. | [22, 23] |
| Включение предварительной/постобработки | NMS и декодирование могут добавлять задержку, которая не включена в некоторые представленные данные. | Часто исключается из основных показателей FPS. | [22] |
3.4. Эталонные наборы данных и метрики оценки
Сравнительные утверждения в Разделе 4 основаны на небольшом количестве повторяющихся эталонных наборов данных. Для обнаружения и сегментации общего назначения Microsoft COCO [77] и PASCAL VOC [78] остаются доминирующими, сообщая mAP при фиксированных или усредненных пороговых значениях IoU. Для обнаружения и сегментации, ориентированных на вождение, Cityscapes [79] и KITTI [80] предоставляют изображения городских и дорожных сцен с пиксельными и 3D-аннотациями, а крупномасштабный Waymo Open Dataset [32] расширяет это за счет многосенсорных записей. Эталонные наборы данных, специфичные для конкретных областей применения, такие как CropDeep [22] для сельскохозяйственных и промышленных наборов данных о дефектах поверхности [23], меньше по размеру, но отражают специфические условия получения изображений для целевого приложения.
Заявленная производительность в реальном времени чаще всего указывается в FPS вместе с соответствующей задаче метрикой точности (mAP для обнаружения, среднее пересечение по объединению (mIoU) для сегментации, точность отслеживания нескольких объектов (MOTA) для отслеживания). Повторяющаяся проблема [30, 48, 50] заключается в том, что показатели FPS редко сопоставимы в разных статьях, поскольку они зависят от размера пакета, разрешения и аппаратного/программного стека. В нескольких обзорах рекомендуется рассматривать заявленную скорость как показатель порядка величины, а не как точное значение, и мы принимаем это предостережение в разделе 4 .
Средняя частота кадров (FPS) и задержка, которые здесь почти повсеместно указываются, являются плохими показателями адекватности работы в реальном времени в критически важных с точки зрения безопасности условиях. Система управления заботится о хвосте распределения задержки, а не о среднем значении: случайный длинный кадр может нарушить крайний срок, даже если средняя частота кадров выглядит нормально. Системы реального времени различают: (i) среднюю задержку/пропускную способность; (ii) хвостовую задержку (95-й/99-й/99,9-й процентиль); (iii) дрожание; (iv) коэффициент несоответствия крайнему сроку; и (v) время выполнения в худшем случае (WCET), аналитически ограниченный предел, который часто требуется для сертификации безопасности. В таблице 3 приведена сводная информация об этих показателях и частоте их указания. Только в литературе, посвященной вождению, и в меньшей степени в промышленной литературе, явно обсуждается изменчивость [31, 33]; в статьях о детекторах в подавляющем большинстве случаев сообщается только средняя частота кадров, что является одним из наиболее очевидных пробелов здесь ( раздел 5.1 и раздел 5.2 ).
Таблица 3. Показатели оценки в реальном времени, выходящие за рамки среднего значения FPS (раздел 3.4), их значимость и частота упоминания в литературе, рассмотренной в данном обзоре.
| Метрическая система | Что оно фиксирует | Актуальность для работы в режиме реального времени | Частота упоминания в исследованной литературе |
|---|---|---|---|
| Средняя задержка/FPS | Среднее время обработки одного кадра | Базовый показатель пропускной способности | Об этом сообщается почти во всех источниках ( Раздел 4.1 ). |
| Задержка в хвосте распределения (95-й/99-й/99,9-й процентиль) | Насколько плохо периодические задержки кадров | Определяет, нарушают ли редкие медленные кадры установленные сроки. | Редко сообщается |
| Дрожь | Дисперсия/разброс задержки для каждого кадра | Устойчивость контура управления зависит от ограниченной дисперсии, а не только от среднего значения. | Редко сообщается |
| Соотношение несоблюдения сроков | Доля кадров, превышающая срок подачи заявки. | Непосредственно связано с поддержанием физической формы в режиме реального времени для выполнения конкретной задачи. | Сообщается в основном в источниках, посвященных автономному вождению [ 31 , 33 ]. |
| Наихудшее время выполнения (WCET) | Аналитически ограниченный верхний предел времени выполнения | Требуется для сертификации безопасности критически важных систем. | Ни в одном из исследованных здесь источников обнаружения/сегментации не зафиксировано. |
В таблице 4 , обобщающей выявленные в этом разделе пробелы в отчетности , в виде единого справочного контрольного списка представлены переменные, которые следует указывать в будущих исследованиях машинного зрения в реальном времени, чтобы результаты можно было воспроизвести и справедливо сравнить с другими работами. В таблице 4 объединены мешающие переменные, обсуждавшиеся в разделе 3.3 (таблица 2), и метрики реального времени, рассмотренные непосредственно выше (таблица 3), в практический, цитируемый контрольный список, вместо того чтобы оставлять их разбросанными по всему тексту.
Таблица 4. Рекомендуемые переменные для воспроизводимой оценки машинного зрения в реальном времени, объединяющие переменные, касающиеся оборудования, рабочей нагрузки и времени, обсуждавшиеся в разделах 3.3 и 3.4.
| Категория | Переменная для отчета | Почему это важно |
|---|---|---|
| Модель | Архитектура, количество параметров, разрешение входных данных | Определяет номинальный объем вычислительных ресурсов и памяти. |
| Точность | Точность численного представления (FP32/FP16/INT8/другие) | Непосредственно влияет на трафик памяти и измеряемую задержку. |
| Размер партии | Размер партии, использованный для приведенного рисунка. | Показатели для первой и третьей партий несопоставимы. |
| Аппаратное обеспечение | Модель устройства, технологический процесс, тактовая частота, режим питания. | Одно устройство может сообщать о разнице в задержке более чем в 2 раза в зависимости от режима энергопотребления. |
| Память | Использование встроенной и внешней памяти, пропускная способность | Слои, ограниченные объемом памяти, не получают выгоды от дополнительных вычислительных ресурсов. |
| Объем работ по трубопроводу | Включаются ли предварительная/постобработка и передача данных между хост-устройством? | Показатели, полученные только на основе анализа данных, занижают сквозную задержку. |
| Статистика времени | Среднее значение, процентиль хвоста распределения (95-й/99-й), дрожание, коэффициент несоответствия сроку. | Одного лишь среднего значения задержки недостаточно для того, чтобы упустить из виду наихудший сценарий поведения. |
| Энергия | Потребляемая мощность и, где это возможно, энергия на единицу вычислительной мощности. | Редко упоминается; необходимо сравнивать эффективность, а не только скорость. |
| Набор данных/метрика | Название набора данных, метрика точности и соглашение об использовании IoU/пороговых значениях. | Данные из разных наборов данных или показателей не подлежат прямому сравнению (см. раздел 4.1 ). |
4. Результаты и обсуждение
4.1. Эволюция архитектуры и компромисс между точностью и скоростью.
На рисунке 2 представлена общая схема конвейера машинного зрения в реальном времени, которая будет использоваться в дальнейшем обсуждении. Получение и предварительная обработка изображений поступают в базовую архитектуру для извлечения признаков, выходные данные которой направляются в специализированный блок; слой оптимизации модели (квантование, обрезка, дистилляция, NAS) находится между обученной архитектурой и платформой развертывания, в то время как цикл ограничений в реальном времени (задержка, пропускная способность, энергопотребление) воздействует на каждый этап одновременно. Это соответствует архитектурной литературе, описанной в разделе 2 : последовательные поколения детекторов повышают точность главным образом за счет более эффективного использования фиксированного бюджета, а не за счет его увеличения. Большинство количественных результатов ниже сообщают только об этапе вывода, прямом проходе базовой архитектуры плюс блок, в виде частоты кадров или задержки; получение, предварительная/постобработка и логика управления являются этапами конвейера, показанными на рисунке 2 , но которые часто исключаются из этого числа или сообщаются отдельно от него ( разделы 3.3 и 3.4 ).
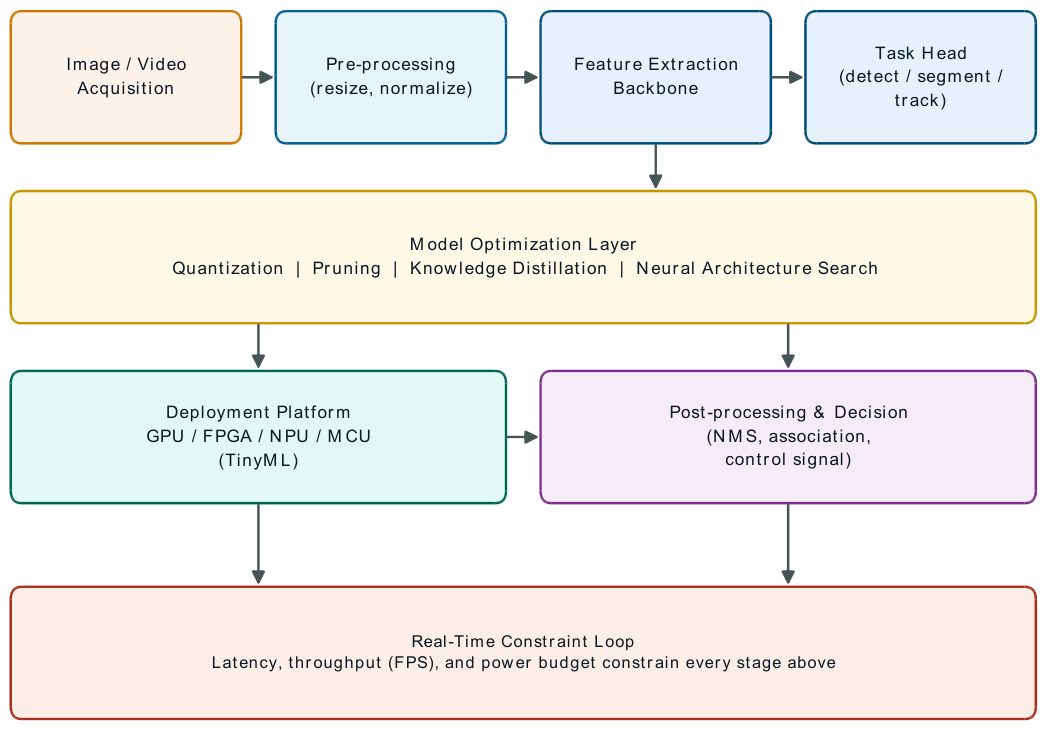
Рисунок 2. Типовой конвейер обработки данных в реальном времени с помощью машинного зрения, от получения изображения через слой оптимизации модели до развертывания и постобработки, ограниченный на всем протяжении контуром контроля задержки, пропускной способности и энергопотребления в реальном времени.
На рисунке 3 прослеживается эта эволюция для линии YOLO из раздела 2.1: основные релизы, ветви сообщества/промышленности и отдельная ветвь YOLOX до самых последних релизов, ориентированных на сквозное обучение/внимание. Обзоры [2, 3] указывают на сети пирамид признаков [81] и межэтапные частичные связи [40] как на идеи с наиболее последовательным положительным эффектом на компромисс между точностью и задержкой. Улучшения группируются в три механизма: репрезентативная эффективность (больше дискриминативных признаков на FLOP, как это делает CSPNet [40]); уточнения присвоения меток/функций потерь, которые улучшают обучение без затрагивания графа вывода, почему выигрыш от «набора бесплатных бонусов» сохраняется между архитектурами [13]; и структурное упрощение, наиболее заметное в головных узлах YOLOv10 без NMS [14]. Эти модели не одинаково портативны: структурные изменения требуют переобучения, в то время как улучшения, зависящие от времени обучения, могут быть добавлены к уже используемым архитектурам без дополнительных затрат. В таблице 5 качественно показано, как каждое основное семейство архитектур находится на этом компромиссе, опираясь на цитируемые обзоры [2, 3, 48, 50, 51]. На рисунке 4 добавлена диаграмма рассеяния репрезентативных показателей точности и скорости для широко цитируемых детекторов [1, 7, 8, 13, 14, 15], показывающая, как линейка детекторов смещается в область работы в реальном времени, обычно иллюстрируемую примерно на уровне 30 кадров в секунду. Эта цифра в 30 кадров в секунду является лишь широко цитируемой иллюстративной конвенцией, а не универсальным критерием: достаточность для работы в реальном времени определяется крайним сроком выполнения конкретной задачи и может быть значительно ниже или выше 30 кадров в секунду в зависимости от приложения (раздел 3.4, таблица 3). Эти данные были получены при различных условиях аппаратного обеспечения и разрешения (раздел 3.4), поэтому их следует рассматривать скорее как ориентировочные, чем строго сопоставимые.
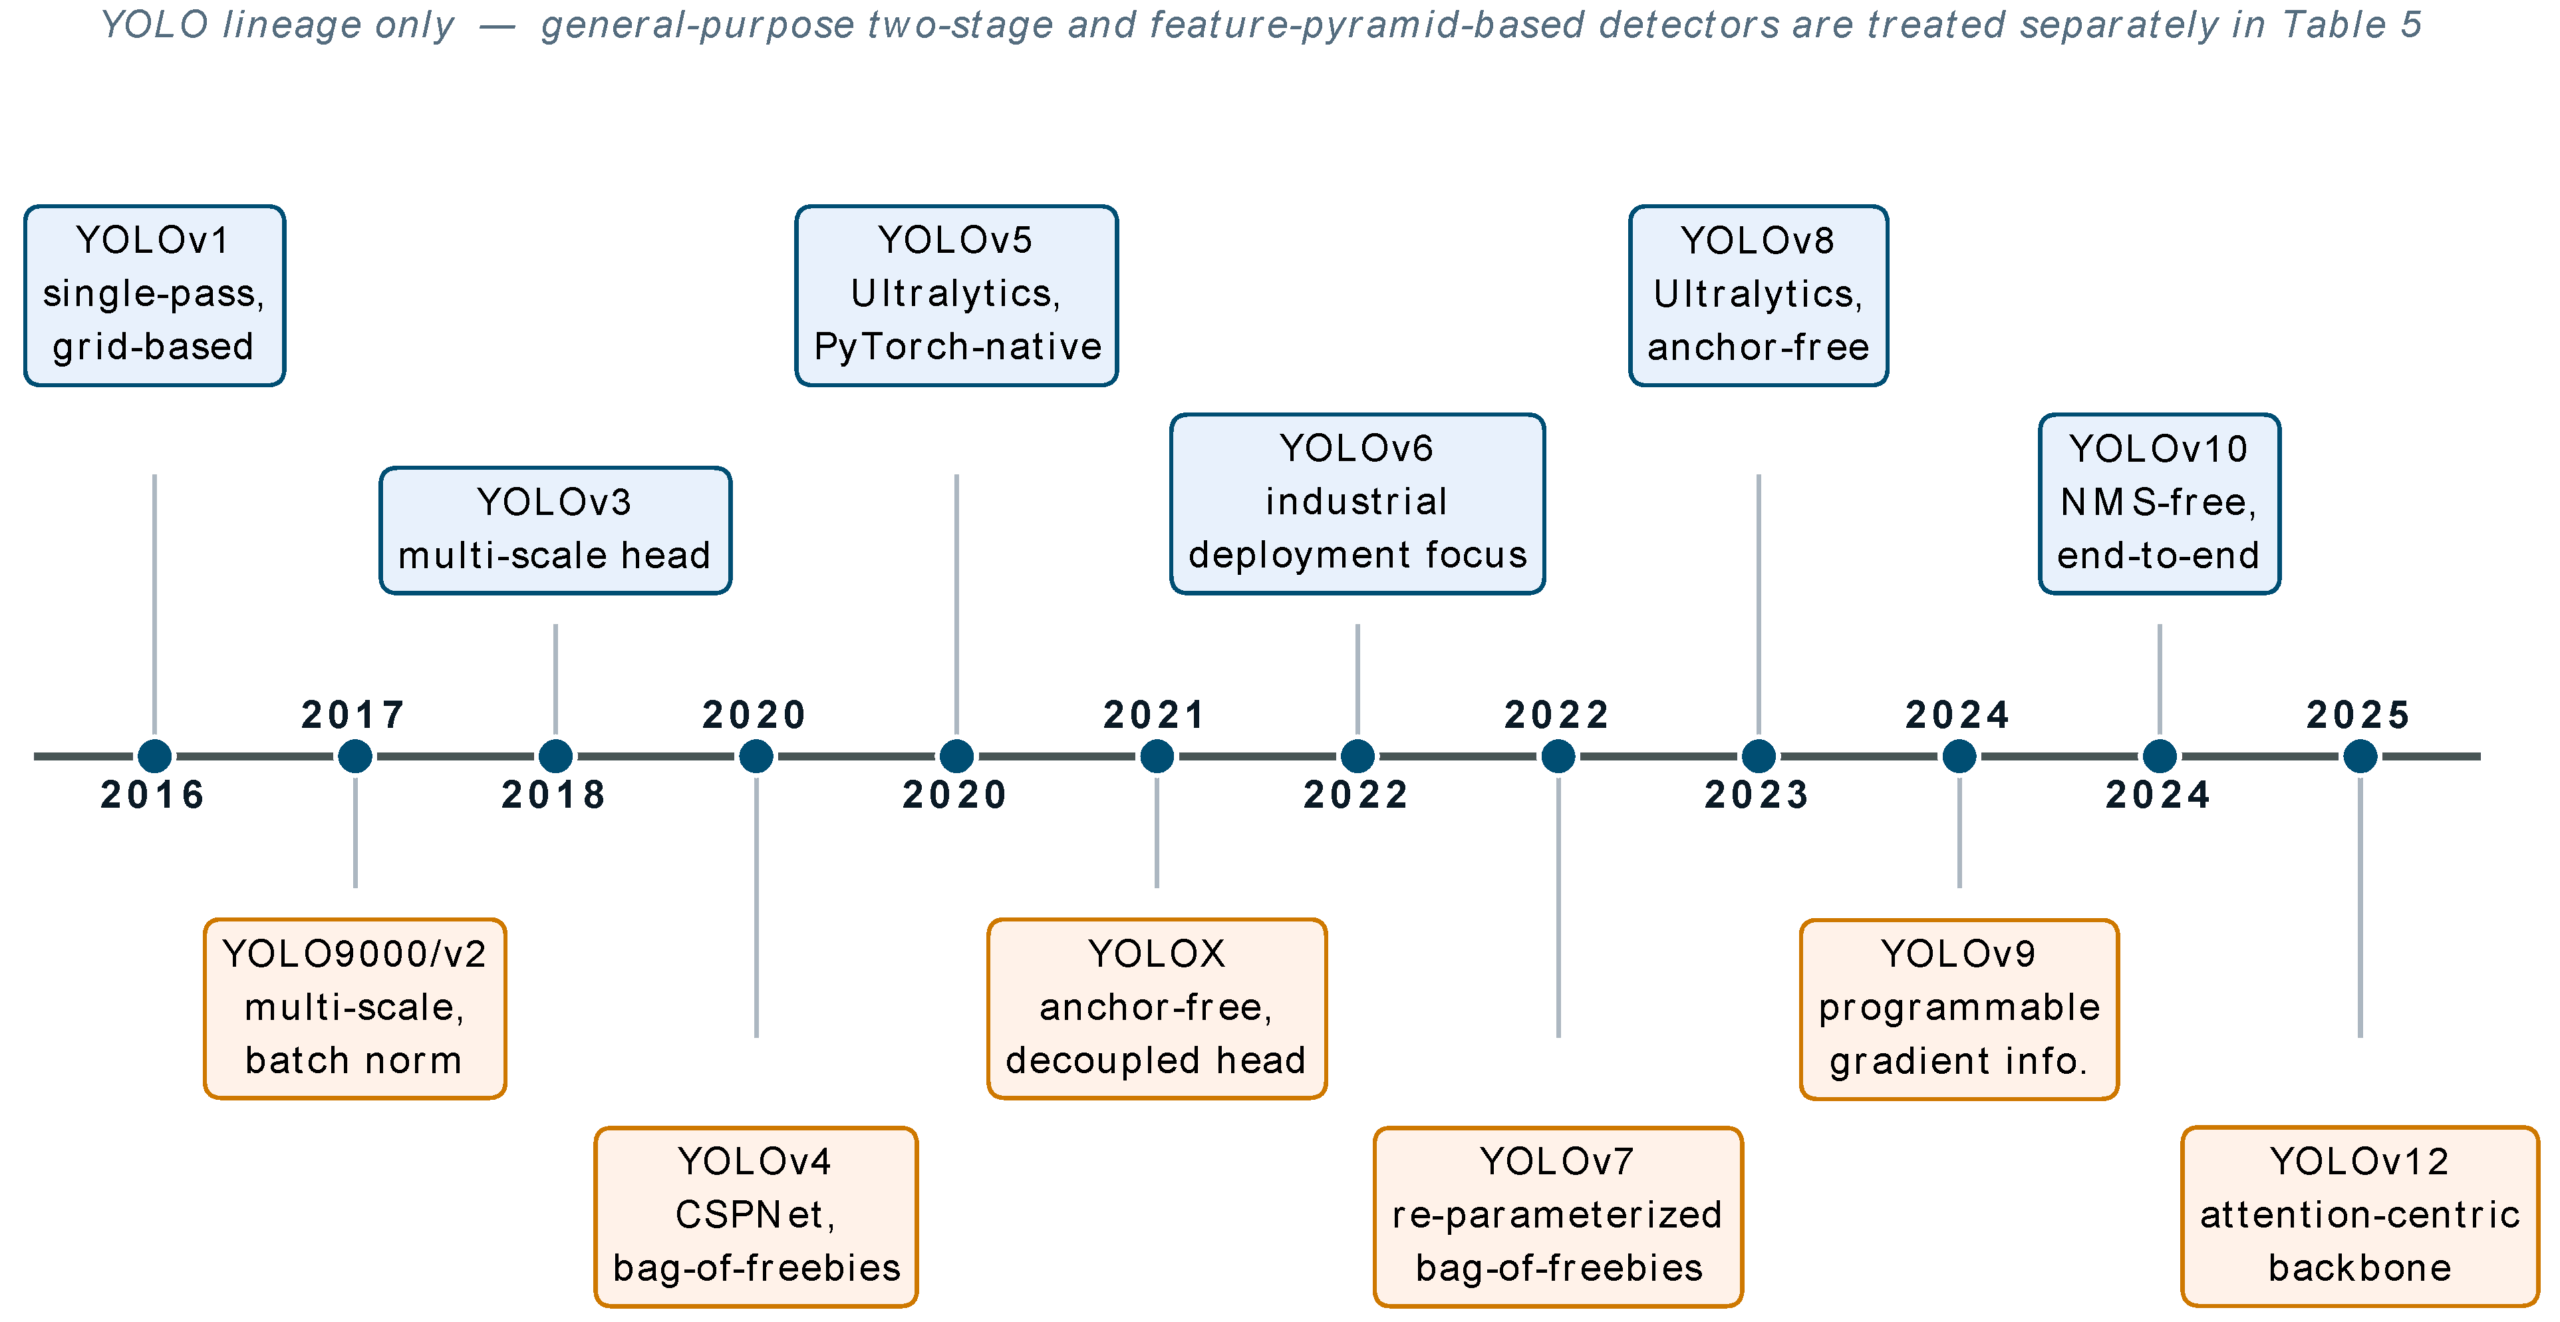
Рисунок 3. Хронология развития детектора YOLO (2016–2025 гг.), включая основные релизы (v1–v4, v7, v10, v12), ветви сообщества/промышленности (v5, v6, v8, v9) и вариант YOLOX без якорей. Двухэтапные и основанные на пирамидах признаков универсальные детекторы (Faster R-CNN, сети пирамид признаков, Mask R-CNN) находятся вне линии YOLO и вместо этого сравниваются по архитектуре в таблице 5. Источники: YOLOv1 [1]; YOLO9000/YOLOv2 [39]; YOLOv3, YOLOv4, YOLOv6 и YOLOX [2]; CSPNet [40]; YOLOv5 [41]; YOLOv7 [13]; YOLOv8 [42]; YOLOv9 [43]; YOLOv10 [14]; YOLOv12 [15].
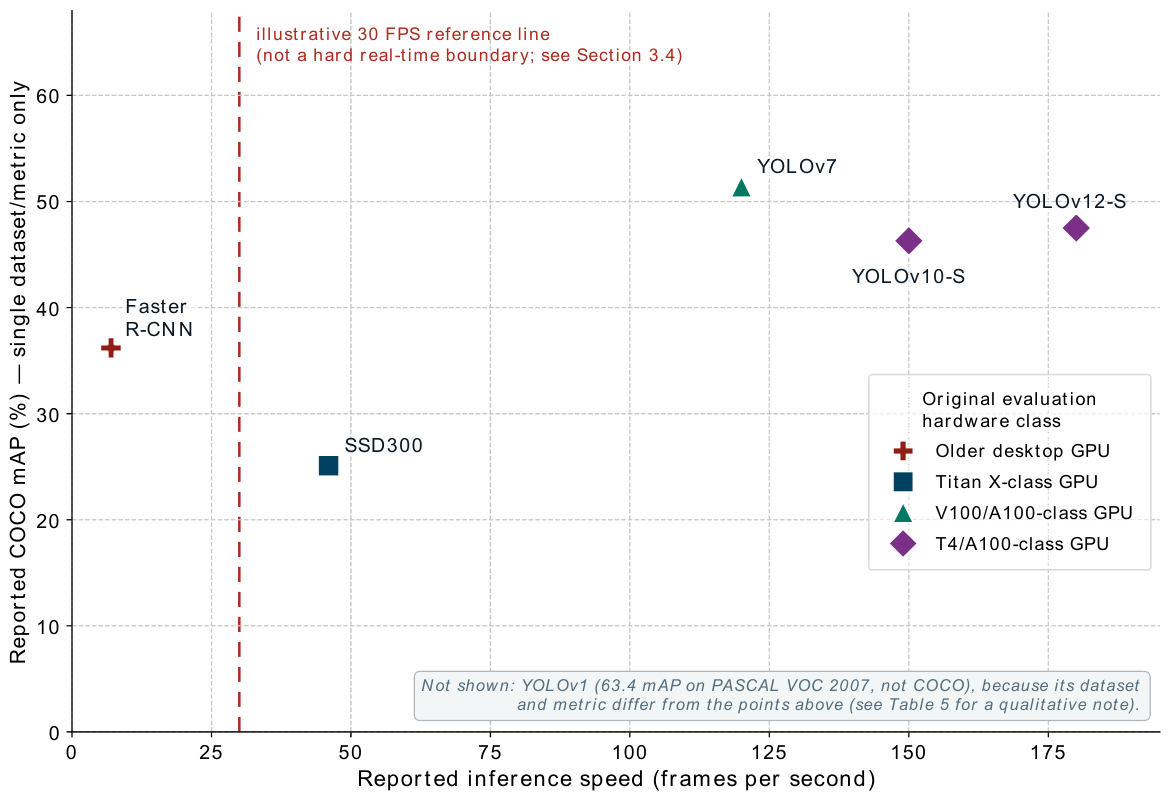
Рисунок 4. Типичные рабочие точки точности-скорости, собранные из проанализированной литературы, с кодировкой маркеров в соответствии с исходным классом оборудования для оценки, указанным в каждом источнике. Четыре показанных класса оборудования (старые настольные графические процессоры, графические процессоры класса Titan X, графические процессоры класса V100/A100, графические процессоры класса T4/A100) не являются непосредственно сопоставимыми друг с другом; точки были представлены в условиях гетерогенного оборудования, размера пакета и разрешения входных данных (раздел 3.3) и должны рассматриваться в рамках своего класса оборудования, а не между классами. Форма и цвет маркера определяют класс оборудования (см. легенду); пунктирная вертикальная линия является лишь иллюстративной эталонной точкой 30 кадров в секунду, а не жесткой границей реального времени (раздел 3.4). Точки данных: YOLOv7 [ 13 ]; YOLOv10-S [ 14 ]; YOLOv12-S [ 15 ]; Faster R-CNN [7]; SSD300 [8]. Результат YOLOv1, исключенный из графика, приведен в [1].
Таблица 5. Качественное сравнение основных семейств архитектур обнаружения объектов в реальном времени, рассмотренных в Разделах 2.1 и 4.1. Указанные диапазоны частоты кадров собраны из цитируемых обзоров и первоисточников и сильно зависят от входного разрешения и целевого оборудования (см. Раздел 3.4). Репрезентативные входные разрешения и оборудование для каждой строки, взятые из тех же источников, следующие: двухступенчатые детекторы обычно указываются при входном разрешении 600–1000 пикселей на графических процессорах серверного класса (класса Titan X/V100); одноступенчатые детекторы на основе сетки — при 300–416 пикселях на графических процессорах класса Titan X; детекторы CSP/bag-of-freebies — при 512–640 пикселях на графических процессорах класса V100/A100; и сквозные/ориентированные на внимание детекторы с разрешением 640 пикселей на графических процессорах класса T4/A100, что соответствует классам оборудования, обозначенным маркерами на рисунке 4.
| Семейство детекторов | Репрезен-тативные модели |
Ключевой архитектурный механизм | Типичный режим реального времени | Ссылки. |
|---|---|---|---|---|
| Двухэтапная (семейство R-CNN) | Fast R-CNN, Faster R-CNN | Предложения по регионам + общие сверточные признаки | <10 кадров в секунду (GPU) | [7, 9] |
| Одноэтапная, на основе сетки | SSD, YOLOv1–v3 | Прямая регрессия по сетке опорных точек. | 30–65 кадров в секунду | [1, 2, 8, 39] |
| CSP/мешок бесплатных подарков | YOLOv4, YOLOv7 | Частичные межэтапные связи; аугментация только во время обучения. | 60–120 кадров в секунду | [2, 13, 40] |
| Комплексный/ориентированный на внимание подход | YOLOv10, YOLOv12 | Голова без нейросенсорных нарушений; центр внимания в основе. | >150 кадров в секунду | [14, 15] |
| Двухэтапная сегментация экземпляров | Маска R-CNN | Параллельная ветвь предсказания маски на двухступенчатом детекторе | <10 кадров в секунду | [10] |
Рисунок 5 завершает этот набор, возвращаясь к аспекту развертывания оборудования, представленному в разделе 3.3, и описывает четырехуровневую иерархию от облака до TinyML, на которой в конечном итоге развертываются указанные выше архитектуры, и с которой следует ознакомиться в разделе 4.9 , а также в разделах 4.3, 4.4, 4.5, 4.6, 4.7 и 4.8, посвященных выбору оборудования для конкретных областей применения .
4.2. Сегментация и отслеживание в реальном времени на практике
Обнаружение локализует дискретные объекты, но для ряда приложений также требуется плотное понимание сцены на уровне пикселей или сохранение идентичности объекта во времени. В таблице 6 представлены репрезентативные архитектуры сегментации в реальном времени и то, как каждая из них ограничивает задержку: ENet [48] использует агрессивное раннее понижение разрешения и компактный кодировщик-декодер; архитектуры с двойным разрешением, такие как DDRNet [49], разделяют агрегацию контекста и сохранение пространственных деталей по параллельным ветвям; а недавние обзоры [48, 50] описывают более широкое семейство многоветвевых, основанных на знаниях конструкций, демонстрирующих конкурентоспособные значения mIoU на тестах класса Cityscapes при интерактивных скоростях. Сравнительное исследование Брони-Бедиако и др. [48] показало, что переход этих архитектур с городских изображений на изображения дистанционного зондирования существенно изменил их относительный рейтинг, что напоминает о том, что производительность сегментации в «реальном времени» не является независимой от предметной области.
Таблица 6. Типичные архитектуры семантической сегментации в реальном времени и стратегия проектирования, используемая в каждой из них для сохранения ограниченной задержки на кадр, как обсуждалось в разделе 4.2.
| Сеть | Стратегия дизайна | Сообщенная область эталонных показателей | Ссылки. |
|---|---|---|---|
| ЭНет | Агрессивное раннее понижение частоты дискретизации; компактный кодировщик-декодер | Вождение в городских условиях (класс «Городские пейзажи») | [ 48 ] |
| DDRNet | Параллельные ветви с двойным разрешением (контекст + детали) | Вождение в городских условиях (класс «Городские пейзажи») | [ 49 ] |
| семейство эффективных сегментаторов для дистанционного зондирования | Многофилиальные и основанные на обобщенных знаниях проекты | Дистанционное зондирование (OpenEarthMap) | [ 48 ] |
| Общая таксономия сегментации в реальном времени | Комплексный обзор эффективных конструкций глубоких нейронных сетей. | Междоменный | [ 50 ] |
При более внимательном изучении литературы по сегментации граница точности и задержки для сегментации в реальном времени выглядит менее стабильной в разных областях, чем для обнаружения. Точность обнаружения оценивает локализацию и классификацию дискретных экземпляров; точность сегментации чувствительна к точности границ, дисбалансу классов «вещи»/«объекты» и пространственной смежности, которые взаимодействуют со стратегией понижения/повышения разрешения сети. Это помогает объяснить, почему двухветвевые конструкции, такие как DDRNet [49], настроенные для геометрии дорожного полотна, не автоматически переносят свои преимущества на изображения дистанционного зондирования или сельскохозяйственные изображения [48], и обосновывает необходимость представления результатов сегментации вместе с распределением классов в оценочном наборе, а не одним общим числом mIoU при сравнении в разделах 4.3 , 4.4 , 4.5 , 4.6 и 4.7 .
Для отслеживания парадигма отслеживания по обнаружению, лежащая в основе SORT [11], DeepSORT [12] и ByteTrack [52], демонстрирует аналогичное постепенное улучшение поверх уже ограниченного по задержке детектора: SORT достигает высокой пропускной способности за счет чисто основанной на движении ассоциации; DeepSORT жертвует некоторой пропускной способностью ради ветви встраивания внешнего вида, которая обрезает переключения идентификаторов при окклюзии; а ByteTrack вместо этого сохраняет обнаружения с низкой степенью достоверности на этапе ассоциации. Обзоры [51] и исследования, специфичные для БПЛА [34, 37], показывают, что эти стратегии добавляют лишь небольшую часть стоимости самого детектора после того, как установлен детектор реального времени, что делает выбор трекера сравнительно низкорискованным, по крайней мере, для стационарных или медленно движущихся камер. На БПЛА эго-движение камеры добавляет видимое движение, с которым ассоциация на основе фильтра Калмана испытывает трудности, отчасти поэтому трекеры, основанные на внешнем виде или сиамские трекеры, остаются популярными в аэрофотосъемке, несмотря на небольшое увеличение задержки [34, 37, 82, 83].
Связанная задача пространственного восприятия в реальном времени, SLAM, разделяет характер отслеживания с ограниченной задержкой, но также поддерживает постоянную геометрическую карту. ORB-SLAM [84], базовая монокулярная система SLAM на основе признаков, показала, что отслеживание, картирование, релокализация и замыкание цикла в реальном времени могут выполняться на основе одного общего представления признаков, разделяя быстрый поток отслеживания на кадр от более медленных потоков картирования/замыкания цикла, — шаблон, повторяющийся в более поздних работах по SLAM и перекликающийся с асинхронными многоскоростными конструкциями, которые рассматриваются в этом обзоре для интеграции базовой модели (раздел 4.9 и раздел 5.2).
4.3. Область применения: автономное вождение и интеллектуальный транспорт
Автономное и вспомогательное вождение — это область, где ограничения реального времени наиболее непосредственно связаны с безопасностью. В исследованиях восприятия водителя [31, 33] описывается стек, объединяющий камеру, LiDAR и радар с жестким ограничением задержки, поскольку любая задержка напрямую влияет на планирование и управление. Бенчмарки (Waymo [32], Cityscapes [79], KITTI [80]) позволяют получать сопоставимые отчеты о точности для разных архитектур. Методы, описанные в Разделах 2, 4.1 и 4.2, адаптированы здесь главным образом за счет многомасштабной обработки удаленных мелких объектов и калибровки неопределенности [31, 32, 33]. Такие платформы, как Pylot, были созданы специально для изучения того, как задержка и точность модулей влияют на поведение водителя от начала до конца, а их тематические исследования подтверждают необходимость контекстно-зависимых компонентов и распределения времени для каждого компонента [85]. Исследование, в котором измерялась задержка обнаружения препятствий в реальном времени в Apollo (PointPillars) и Autoware (CenterPoint) при воспроизведении данных с реальных датчиков, показало, что враждебное возмущение облака точек увеличивает среднюю задержку до 11,5 мс, что представлено в виде распределения, а не одного среднего значения, что согласуется с проблемами задержки в хвосте распределения, описанными в разделе 3.4 [86], одним из немногих источников, сообщающих о времени, подходящем для анализа в таблице 3.
Одна особенность отличает эту область: «в реальном времени» редко ограничивается одной целевой частотой кадров. Реальным ограничением обычно является общий бюджет задержки, охватывающий датчики, восприятие, прогнозирование и управление, причем восприятие — лишь одна часть. Опросы по практике вождения [ 33 ] отмечают, что такой подход к системе в целом способствует выбору архитектурных решений (сниженное фиксированное разрешение входного сигнала, задержка в худшем случае по сравнению со средней задержкой), которые не обязательно были бы оптимальными, если бы детектор оценивался отдельно по стандартному эталону, что легко упустить из виду при сравнении показателей FPS в разных областях.
4.4. Область применения: промышленное машинное зрение и производство.
Промышленное машинное зрение применяет обнаружение/сегментацию в реальном времени главным образом для контроля качества и манипуляций, управляемых роботами. Обзоры машинного зрения в производстве [23] сообщают о точности обнаружения дефектов поверхности, часто превышающей 95% при контролируемом освещении, при этом основной проблемой является пропускная способность контроля при почти нулевом уровне ложноотрицательных результатов, поскольку пропущенный дефект обходится дороже, чем ложная тревога [23]. Эта асимметрия объясняет широкое использование усеченных или квантованных детекторов семейства YOLO, предлагающих настраиваемую точку точности-полноты при известной стоимости [23, 35]. Специализированный обзор обнаружения дефектов поверхности в реальном времени [47] определяет баланс между скоростью и точностью, а также получение больших репрезентативных наборов данных о дефектах как две повторяющиеся проблемы.
Вторая, менее обсуждаемая особенность промышленной области заключается в том, насколько узкими и контролируемыми являются условия съемки. В отличие от открытых пространств, освещение, положение камеры и представление объекта обычно проектируются, а не возникают случайно, что отчасти объясняет, почему сообщаемая точность в промышленности выше, чем на открытом воздухе при сопоставимых возможностях. Это также делает промышленные модели более уязвимыми к незапланированным изменениям (новый вариант продукта, перестановка камеры, изменение освещения), и частота переобучения, а не сама точность, часто является реальным ограничением стоимости владения [23]. В том же исследовании отмечается, что сообщаемые скорости контроля обычно оцениваются по конкретным типам поверхностей и дефектов, для которых была создана система, что ограничивает перенос на другую линейку продукции и подтверждает тезис раздела 3.3 о чувствительности к условиям оценки [47].
4.5. Область применения: беспилотные летательные аппараты и аэрофотосъемка.
Система машинного зрения, установленная на БПЛА, должна соответствовать ограничениям реального времени при жестких ограничениях по размеру, весу и энергопотреблению (SWaP), что обычно исключает использование серверного оборудования. Обнаружение мелких объектов на изображениях, полученных с большой высоты, является повторяющейся проблемой, поскольку наземные детекторы систематически пропускают мелкие, плотные воздушные объекты [37]. Ян и др. [34] описывают конвейер обработки данных с использованием усеченного YOLOv4 и сиамского трекера, координируемый через операционную систему роботов (ROS) [87], на потребительском дроне с вычислительными мощностями уровня ноутбука: mAP@0.5 составляет 0,736 (усеченный) против 0,749 (неусеченный), при этом размер модели уменьшается с 250,2 МБ до 16,8 МБ, а количество операций с плавающей запятой — с 59,6 до 18,6 миллиардов (таблица 7). Более ранние детекторы БПЛА (DroNet [ 36 ], SlimYOLOv3 [35]) и обзоры [37] подтверждают это: сокращение и упрощение, а не новые парадигмы, являются основной причиной снижения задержки, о котором сообщается в данном исследовании.
Таблица 7. Заявленные показатели точности, полноты, mAP@0.5 и вычислительной стоимости для пяти вариантов детектора, оцененных на встроенной задаче обнаружения людей на БПЛА, воспроизведенные из оригинального исследования. Уменьшение размера модели примерно в 15 раз и миллиардов операций с плавающей запятой (BFLOPs) более чем в 3 раза сократило размер модели по сравнению с необрезанной базовой моделью YOLOv4, при стоимости mAP@0.5, равной 0,013, как обсуждалось в разделе 4.5 .
| Модель | Точность | Отзывать | mAP@0.5 | Параметры (M) | Вес / Размер (МБ) | BFLOPs |
|---|---|---|---|---|---|---|
| SSD | 0,607 | 0,398 | 0,504 | 34.3 | 135.3 | 70.40 |
| YOLOv3 | 0,661 | 0,436 | 0,579 | 61.6 | 242.9 | 65.86 |
| YOLOv4 | 0,818 | 0,605 | 0,749 | 63.9 | 250.2 | 59.563 |
| Tiny-YOLOv4 | 0,652 | 0.411 | 0,551 | 5.87 | 23.6 | 7.79 |
| Pruned-YOLOv4 | 0,784 | 0,619 | 0,736 | 4.28 | 16.8 | 18.61 |
Источник: данные Янга, Ченга и Юя [34] (Electronics 2023, 12, 4928).
Закономерность, представленная в таблице 7 , повторяется, хотя и менее точно, во всей остальной литературе: размер модели уменьшился примерно в 15 раз, а количество операций с плавающей запятой (FLOPs) — более чем в 3 раза между необрезанными и обрезанными детекторами, в то время как точность и mAP@0.5 снизились всего на несколько пунктов, а полнота практически не изменилась. Эта сверхлинейная зависимость (значительная экономия вычислительных ресурсов при небольших затратах на точность) соответствует общему выводу литературы по обрезке [29, 30] о том, что полностью обученные сверточные детекторы, как правило, имеют избыточную параметризацию для узкоспециализированной задачи, такой как обнаружение людей одного класса, и является убедительным доказательством того, что аппаратно-ориентированное сжатие, а не выбор семейства детекторов, определяет, соответствует ли данный уровень точности энергопотреблению и полезной нагрузке платформы БПЛА.
4.6. Область применения: Точное земледелие
Точное земледелие применяет обнаружение/классификацию в реальном времени для идентификации культур/сорняков, обнаружения болезней и подсчета плодов, обычно с помощью наземных роботов или БПЛА. CropDeep [22] был создан для обработки данных в полевых условиях в реальном времени, с тем же противоречием между производительностью и точностью, что и в промышленности, но при переменном освещении на открытом воздухе. Легкие магистрали и мобильные ViT подходят для классификации болезней растений на устройстве, где связь ненадежна [20, 26]. Сравнение YOLOv4, EfficientDet и CenterNet для обнаружения сорняков с помощью Jetson показало, что YOLOv4 имеет показатель mAP@0.5 93,4% (80 мс/14 FPS) по сравнению с YOLOv4-tiny, имеющим показатель mAP@0.5 89,2% (24,5 мс/52 FPS) [ 88 ], аналогично компромиссу с БПЛА в таблице 7. Система сегментации культур/сорняков на полевом роботе работает с частотой около 20 Гц, запуская в режиме реального времени активацию прополки [89], в отличие от одной лишь классификации; измеренное потребление энергии в поле остается скудным (Раздел 3.3).
В сельскохозяйственных приложениях также присутствует ограничение, практически отсутствующее в других областях: прерывистая или отсутствующая связь с полем, в сочетании с работой от батарей или солнечных батарей в течение нескольких дней. Это смещает выбор модели дальше в сторону уровня TinyML, показанного на рисунке 5 , чем можно было бы предположить, исходя только из задержки, поскольку модель, работающая в реальном времени с разгрузкой из облака, бесполезна без надежного восходящего канала; по этой причине в нескольких обзорах TinyML мониторинг сельского хозяйства указан как один из ведущих вариантов использования [26]. В том же исследовании было обнаружено, что все три детектора работали значительно медленнее на встроенной платформе, чем на настольном графическом процессоре (YOLOv4: 18 мс на RTX 2080 Ti против 80 мс на Jetson Xavier AGX [88]), что примерно в четыре раза замедляет работу, подтверждая разрыв между встроенными и настольными системами, описанный в разделе 3.3.
4.7. Область применения: Медицинское и хирургическое зрение
В хирургии с визуальным контролем в реальном времени компьютерное зрение занимает здесь иное положение, поскольку требования к точности сочетаются со строгими ограничениями валидации и регулирования, с которыми в других областях сталкиваются реже. Систематический обзор интраоперационного визуального контроля [38] документирует растущее число систем сегментации хирургических инструментов и тканей в реальном времени, отмечая, что задержка и методы валидации значительно различаются, что затрудняет сравнение. Как и в промышленной инспекции, ключевой вопрос часто заключается не в том, достижима ли точность в автономном режиме, а в рамках кадрового бюджета видео в реальном времени при клинически приемлемом уровне ложноотрицательных результатов [38]. Обзор методов обнаружения полипов толстой кишки [90] подтверждает это, обнаружив, что точность варьируется в зависимости от морфологии поражения, и указывая на разрыв между установленными эталонными значениями и клинической практикой как на барьер для внедрения [90].
Медицинская область также более четко, чем другие, выявляет ограничение, прослеживающееся в этом обзоре в более слабой форме: сообщаемые данные о задержке хирургического зрения редко сопровождаются клинической валидацией, необходимой для того, чтобы показать, что данная точка точности-скорости безопасна для конкретной процедуры и популяции, а не просто хорошо выглядит на ретроспективном наборе данных [38], пробел, который рассматривается в разделе 5.1. Обзор колоноскопии [90] сужает этот момент: несколько детекторов полипов в реальном времени достигают высокой чувствительности на общедоступных эталонных наборах данных, но обобщение между наборами данных (например, между эндоскопическими центрами) остается непоследовательным, что является проблемой, связанной со сменой области исследования и общим пробелом в надежности, описанным в разделе 5.1.
4.8. Междоменный синтез
В таблице 8 собраны репрезентативные исследования из каждой области, с указанием используемой методики, уровня оборудования и основного показателя реального времени. Повторяются две закономерности: используемая архитектура заимствована из небольшого общего пула (в основном семейство YOLO и усеченные/квантованные варианты), адаптация к конкретной области происходит за счет обработки и постобработки данных, а не новых парадигм, и основным рычагом для выполнения требований к реальному времени в данной области является сжатие (раздел 3.2) в сочетании с выбором уровня развертывания (рисунок 5), а не единая «самая быстрая» архитектура. Примечание к парным показателям задержки/частоты кадров в таблице 8: несколько строк не являются простыми обратными величинами (например, 76,80 мс наряду с 25+ FPS), что отражает конвейерное/многопоточное измерение, а не ошибку транскрипции, что само по себе иллюстрирует разрыв в соглашениях об отчетности, описанных в разделе 3.3 и таблице 4.
Таблица 8. Междоменный синтез репрезентативных исследований машинного зрения в реальном времени, суммирующий метод обнаружения/сегментации, уровень аппаратного обеспечения развертывания и основные показатели реального времени, представленные для каждой из пяти областей применения, обсуждавшихся в разделе 4 .
| Область применения | Репрезента-тивное иссле-дование | Метод обнаружения/ сегментации |
Уровень оборудования | Сообщаемый показатель в режиме реального времени |
Ссылки. |
|---|---|---|---|---|---|
| Автономное вождение | ADPerf: измерена задержка восприятия Apollo/Autoware. | Обнаружение/сегментация на основе данных нескольких датчиков | Периферийный сервер (вычисли-тельная система в автомобиле) | Возмущение облака точек, создаваемое враждебными действиями, увеличивает среднюю задержку обнаружения 3D-препятствий до 11,5 мс. | [31, 32, 86] |
| Промыш-ленная инспекция | Обнаружение дефектов солнечных элементов на Raspberry Pi 5 (edge) | Детекторы семейства YOLO с обрезкой/квантованием | Пограничный сервер/на устройстве | 32,4 мс/24,74 FPS после обрезки (против 13,83 FPS в базовом режиме) | [23, 91] |
| БПЛА / аэрофо-тосъемка | Prunedv-vYOLOv4 + SiamMask на потреби-тельском дроне | Обрезной односту-пенчатый детектор + сиамский трекер | Встроенный в устройство (ноутбук) | mAP@0.5 = 0.736, модель 16.8 МБ (данные о сквозной частоте кадров/задержке не сообщаются; сам по себе пример непоследо-вательной отчетности, раздел 5.1 ) | [34] |
| Точное земледелие | YOLOv4 / YOLOv4-крошечный на Jetson Xavier AGX | Легковесная классификация CNN/ViT | On-device / TinyML | YOLOv4: 93,4% mAP@0,5, 80 мс/14 FPS; YOLOv4-tiny: 89,2% mAP@0,5, 24,5 мс/52 FPS | [20, 22, 88] |
| Медицин-ское / хирур-гическое зрение | Система-тический обзор хирургии с исполь-зованием методов визуализации с применением глубокого обучения. | Инструменты и сегментация тканей в режиме реального времени | Пограничный сервер (вычисли-тельный центр операционной) | Детектор полипов в реальном времени: более 25 кадров в секунду при задержке 76,80 +/- 5,60 мс (среднее значение +/- стандартное отклонение) | [38, 92] |
При сравнении пяти областей параллельно выявляется третья, более тонкая закономерность: каждая определяет «реальное время» через различные связующие ресурсы. Для вождения — наихудшая сквозная задержка при соблюдении требований безопасности; для промышленной инспекции — устойчивая производительность, соответствующая времени цикла; для машинного зрения БПЛА — комбинированный диапазон размеров, веса и энергопотребления; для сельского хозяйства — энергетическая автономность при прерывистом подключении; и для медицинского зрения — подтвержденная точность в пределах клинически приемлемого бюджета кадров, а не просто частота кадров. Поскольку это действительно разные цели оптимизации, а не разные значения в одной шкале, метод, который является «реальным временем» по стандартам одной области, не обязательно соответствует стандартам другой, что является еще одним аргументом (раздел 5.1) в пользу бенчмаркинга, ориентированного на конкретную область, а не на нейтральную.
Две другие области, не рассматриваемые как полноценные тематические исследования, но хорошо представленные в литературе, демонстрируют ту же закономерность с другой точки зрения. Обнаружение аномалий в системах видеонаблюдения [93] имеет ту же асимметричную структуру затрат, что и промышленная область (пропущенное событие обходится дороже, чем ложная тревога), что согласуется с пересечением, отмеченным в разделе 3.1; его непрерывный, постоянно включенный профиль пропускной способности для нескольких камер представляет собой версию того же ограничения другой формы, а не действительно новое ограничение. Обнаружение в условиях низкой освещенности и ночного времени [94] вместо этого охватывает все области, а не определяет свою собственную: точность для архитектур, работающих в режиме реального времени, существенно снижается в условиях низкой контрастности и высокого уровня шума, если не используется этап улучшения, который сам по себе увеличивает бюджет задержки.
4.9. Базовые модели, модели визуального и языкового восприятия и системы, интегрированные с LLM, в конвейерах обработки данных в реальном времени.
Базовые и визуально-языковые модели, описанные в разделе 2.5, начинают пересекаться с вышеупомянутыми областями, хотя и гораздо менее зрело, чем литература по детекторам и сегментации, описанная в разделах 4.1, 4.2, 4.3, 4.4, 4.5, 4.6, 4.7 и 4.8. Наблюдаются две модели внедрения. Во-первых, базовая модель используется в автономном режиме как механизм обработки данных или инструмент аннотирования, улучшающий последующую модель реального времени, не запускаясь при этом на этапе вывода: сегментация с подсказками SAM [57] и обнаружение открытого множества Grounding DINO [58] используются таким образом, автоматически размечая обучающие данные для гораздо меньшего детектора, развернутого с помощью методов сжатия, описанных в разделе 3, — косвенный, но уже практичный путь, с помощью которого базовые модели улучшают системы реального времени сегодня.
Во втором варианте сжатая базовая модель работает непосредственно в рамках бюджета. EdgeSAM [61] нацелен на сегментацию с возможностью быстрого выполнения, сокращая кодировщик SAM более чем на порядок, и сообщает о производительности более 30 FPS на смартфоне/встроенном графическом процессоре [61]. MiniCPM-V [62] применяет ту же стратегию к полной модели «зрение-язык», достигая производительности уровня GPT-4V от 8-параметрической модели на мобильном телефоне. Это частично закрывает разрыв, но не полностью: EdgeSAM сжимает кодировщик SAM, но не пересчет маски декодера для каждого объекта [61]; стоимость вывода MiniCPM-V масштабируется в зависимости от длины выходных данных, в отличие от предсказания фиксированного размера, что затрудняет определение наихудшей задержки [62].
В таблице 9 приведено краткое описание рассматриваемых здесь базовых и визуально-языковых моделей, их приблизительный масштаб, стратегия сжатия и заявленная готовность к работе в реальном времени, что наглядно демонстрирует разрыв между исходными, несжатыми базовыми моделями и сжатыми вариантами, которые начинают приближаться к области работы в реальном времени, определенной в разделе 4.1.
Таблица 9. Базовые и визуально-языковые модели, обсуждавшиеся в разделе 4.9, с указанием приблизительного масштаба, стратегии сжатия и заявленной готовности к работе в реальном времени, иллюстрирующие разрыв между исходными, несжатыми базовыми моделями и сжатыми вариантами, начинающими приближаться к области работы в реальном времени, показанной на рисунке 4 .
| Модель | Тип | Приблизи-тельный масштаб. | Стратегия сжатия | Сообщения о готовности в режиме реального времени |
Ссылки. |
|---|---|---|---|---|---|
| ЗАЖИМ | Контрастный кодировщик «зрение-язык» | ~400 М (Вит-Л/14) | Нет (используется как компонент кодировщика) | Не привязано к конкретной задаче; основа для автономного встраивания. | [ 56 ] |
| СЭМ | Модель основы оперативной сегментации | ~636 М (кодировщик ViT-H) | Нет (оригинал) | ~4 изображения/с на настольном графическом процессоре; не в режиме реального времени. | [ 57 ] |
| EdgeSAM | Сжатая, легкодоступная сегментация | ~9,6 М кодировщик | Метод дистилляции с подсказками в цикле обработки для мобильных сверточных нейронных сетей | >30 кадров в секунду на смартфоне/встроенном графическом процессоре | [ 61 ] |
| ЛЛаВА | Помощник по выполнению инструкций, основанных на зрении и языке. | 7 B–13 B (кодировщик LLM + CLIP) | Нет (в полном масштабе) | Асинхронное/офлайн-рассуждение, а не в реальном времени. | [ 59 ] |
| Заземление DINO | Детектор с открытым набором данных и языковой обусловленностью | Swin backbone + текстовый кодировщик BERT | Нет (оригинал) | Используется преимущественно в качестве механизма для разметки данных в автономном режиме. | [ 58 ] |
| МиниCPM-V | Модель визуального и языкового восприятия, развертываемая на периферии сети | 8 B (также доступен вариант 2 B) | Архитектура, обучение и совместная оптимизация данных | Работает на мобильном телефоне на уровне бенчмарков GPT-4V. | [ 62 ] |
Таблица 10 дополняет это, возвращаясь к картине развертывания оборудования из раздела 3.3 и рисунка 5 , суммируя репрезентативные аппаратные платформы и наборы инструментов на каждом уровне развертывания, а также типичные бюджеты энергопотребления из кроссплатформенных сравнительных исследований. В совокупности таблицы 9 и 10 показывают, что рассмотренные здесь варианты сжатой базовой модели на данный момент являются реалистичными кандидатами в основном для уровней периферийных серверов и устройств в этой иерархии, а не для уровня TinyML класса микроконтроллеров в нижней части рисунка 5.
Таблица 10. Типичные аппаратные платформы и программные наборы инструментов на каждом уровне развертывания, показанные на рисунке 5, с типичными значениями энергопотребления, взятыми из кроссплатформенных сравнительных исследований, обсуждаемых в разделе 3.3. Наборы инструментов перечислены по названию, как описано в цитируемых источниках; авторы не запускали это программное обеспечение, поэтому номера версий не применимы, за исключением тех, которые указаны в цитируемых источниках.
| Уровень развертывания | Представительское оборудование | Типичный энергетический бюджет | Граница измерения мощности | Типичный набор инструментов | Ссылки. |
|---|---|---|---|---|---|
| Графический процессор для облачных вычислений/центров обработки данных | Серверные кластеры с несколькими графическими процессорами | 300–700 Вт на видеокарту | TDP чипа | PyTorch/TensorFlow, TensorRT | [4, 17] |
| Графический процессор периферийного сервера | NVIDIA Jetson Nano/Xavier/Orin class | 5–60 Вт | На уровне модуля (питание платы) | TensorRT, JetPack SDK | [74] |
| Ускоритель FPGA | Xilinx/AMD Zynq, ZCU104, Криа КВ260 | 5–25 Вт | Только ускоритель (питание чипа) | Витис ИИ, ФИНН | [22, 72, 75] |
| Ускорительная карта Edge TPU/NPU | Google Coral Edge TPU | 0,5–2 Вт | Только ускоритель (питание чипа) | Компилятор TensorFlow Lite/Edge TPU | [75] |
| Мобильный SoC NPU | Нейронный ускоритель класса смартфона | <5 Вт | Зависит от устройства (доля мощности NPU в энергопотреблении SoC, не учитывается отдельно). | ONNX Runtime Mobile, CoreML, NNAPI | [62] |
| Микроконтроллер (TinyML) | Микроконтроллер класса Cortex-M | <1 Вт (часто <100 мВт) | Вся система (питание платы) | TensorFlow Lite Micro, CMSIS-NN | [24, 25, 26] |
Даже если существуют сжатые варианты, их подключение к конвейеру, показанному на рисунке 2, отличается от обычного детектора: модели визуально-языковой обработки выдают открытые языковые выходные данные, а не блоки с фиксированной схемой, которые трудно заменить специализированным блоком в критичной к задержке логике. В обзоре VLM для робототехнического зрения [60] развертывание в реальном времени указано в числе основных открытых проблем этой области. В разделах 4.3, 4.4, 4.5, 4.6 и 4.7 эти модели в основном представлены как автономный механизм обработки данных или слой асинхронного рассуждения над обычным детектором, а не как сам компонент, критичный к задержке (раздел 5.2). Еще один пробел — это оценка: ни один из сжатых вариантов не сообщает о хвостовой задержке или времени в наихудшем случае (раздел 3.4), поэтому невозможно утверждать, соответствуют ли они ограничению реального времени в условиях наихудшего случая.
5. Ограничения и перспективы развития
5.1. Ограничения рассмотренной литературы
В рассмотренной литературе встречаются несколько методологических ограничений. Во-первых, отчеты о производительности в реальном времени непоследовательны: данные о FPS редко содержат достаточно подробной информации об оборудовании/пакетах/разрешении для прямого сравнения [30, 48, 50], поэтому данные в разделе 4.1 представлены как ориентировочные. Во-вторых, устойчивость при смене домена сообщается неравномерно по сравнению с эталонной точностью [22, 31, 38, 48]. В-третьих, энергопотребление сообщается лишь в меньшинстве исследований, несмотря на то, что это является ограничивающим фактором при развертывании TinyML/UAV [24, 26]. В-четвертых, эффективные графические трансформеры сократили разрыв в задержке с CNN [20, 21], но их интеграция в конвейеры обнаружения/сегментации/отслеживания остается менее зрелой, а сравнительные гибридные оценки в разных доменах по-прежнему редки.
Пятое ограничение, специфичное для базовых моделей и моделей визуально-языковой обработки данных из разделов 2.5 и 4.9, заключается в том, что эта сублитература достаточно молода, поэтому прямые сравнения с обычными детекторами на тех же тестах реального времени все еще редки. Большинство сообщаемых ускорений для сжатых базовых моделей (например, EdgeSAM по сравнению с оригинальным SAM [61]) оцениваются по сравнению с их собственным несжатым базовым уровнем, а не с детекторами, специфичными для конкретной задачи, из разделов 4.1 и 4.2 , что затрудняет точное определение места сжатых базовых моделей на границе точности и задержки, показанной на рисунке 4, относительно специализированных архитектур.
Данный обзор имеет свои методологические ограничения. Как описано в разделе 3.1, он следует повествовательному, а не формально зарегистрированному систематическому протоколу, и отбор источников, хотя и структурирован, отражает суждение авторов и может не включать неиндексированные работы. Точные подсчеты записей по каждой базе данных не регистрировались; на рисунке 1 представлен качественный анализ отбора, а не проверенные подсчеты, и разработка полностью систематического протокола является задачей на будущее (раздел 5.2). Охват различных областей неравномерен: литература по вождению и БПЛА (разделы 4.3 и 4.5) опирается на более обширную и гетерогенную базу данных, чем литература по промышленности и медицине (разделы 4.4 и 4.7), что отражает относительный размер литературы. 94 источника охватывают широкий спектр изданий и лет; результаты не были независимо перепроверены и должны рассматриваться как утверждения, основанные на первичной литературе.
5.2. Перспективные направления исследований
Исходя из указанных выше ограничений, особенно перспективными выглядят четыре направления. Во-первых, стандартизированные, явно выраженные в предметной области протоколы тестирования производительности в реальном времени, сообщающие об аппаратном обеспечении, размере пакета, разрешении и конкретном ограничении привязки целевой области (раздел 4.8) вместо одного деконтекстуализированного показателя FPS. Во-вторых, оценка с учетом энергопотребления, сообщаемая наряду с задержкой, как само собой разумеющееся, особенно для уровней БПЛА, сельского хозяйства и TinyML, где энергопотребление часто является ограничивающим фактором [24, 26]. В-третьих, продолжение совместной разработки эффективных архитектур трансформеров и гибридных архитектур свертки-внимания с методами сжатия из раздела 3, что, вероятно, сократит оставшийся разрыв в задержке с помощью сверточных базовых цепей [20, 21] по мере развития поддержки внимания на NPU.
В-четвертых, исходя из раздела 4.9, объединение базовых моделей и моделей визуального языка в конвейеры с ограниченной задержкой является существенным и в значительной степени открытым направлением. Это включает в себя расширение стратегии децентрализованной дистилляции EdgeSAM [61] на другие семейства базовых моделей; создание протоколов оценки, размещающих сжатые базовые модели и специализированные детекторы на одной оси точности-задержки; и проектирование архитектур, в которых большая модель визуального языка работает асинхронно в качестве слоя рассуждений с более медленным темпом (понимание сцены, объяснение аномалий) над обычным детектором с жесткой задержкой, а не заменяет его полностью. Такие иерархические конструкции уже появляются в ранней форме среди источников в разделе 4.9 и, по нашей оценке, представляют собой наиболее практичный ближайший путь для развития возможностей базовых моделей в системах реального времени с ограниченной задержкой.
6. Выводы
В данном обзоре рассмотрены аспекты машинного зрения в реальном времени с точки зрения архитектуры, аппаратного обеспечения и приложений, а также отдельно для базовых моделей и моделей на основе языков машинного зрения. Архитектуры обнаружения, сегментации и отслеживания в реальном времени в основном улучшаются за счет более эффективного использования фиксированного вычислительного бюджета, становясь реальными в развернутых системах только в сочетании со сжатием и целенаправленным выбором между облачными, периферийными, внутриустройственными и TinyML-уровнями. Один и тот же небольшой набор архитектур повторяется во всех пяти областях, адаптируясь за счет обработки данных и сжатия, а не за счет инноваций, специфичных для каждой области, даже несмотря на то, что само понятие «в реальном времени» меняется в зависимости от ограничений каждой области. Базовые модели и модели на основе языков машинного зрения внедряются в основном в качестве автономных механизмов обработки данных и компонентов сжатия, но прямая интеграция в конвейер обработки данных остается открытой. Стандартизация измерений, отчетность об энергопотреблении наряду с задержкой и расширение сжатия на базовые модели являются наиболее перспективными направлениями развития.
Литература
- Redmon, J.; Divvala, S.; Girshick, R.; Farhadi, A. You Only Look Once: Unified, Real-Time Object Detection. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR), Las Vegas, NV, USA, 26 June–1 July 2016; pp. 779–788. [Google Scholar]
- Terven, J.; Córdova-Esparza, D.-M.; Romero-González, J.-A. A Comprehensive Review of YOLO Architectures in Computer Vision: From YOLOv1 to YOLOv8 and YOLO-NAS. Mach. Learn. Knowl. Extr. 2023, 5, 1680–1716. [Google Scholar] [CrossRef] [Scilit]
- Zou, Z.; Chen, K.; Shi, Z.; Guo, Y.; Ye, J. Object Detection in 20 Years: A Survey. Proc. IEEE 2023, 111, 257–276. [Google Scholar] [CrossRef] [Scilit]
- He, K.; Zhang, X.; Ren, S.; Sun, J. Deep Residual Learning for Image Recognition. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR), Las Vegas, NV, USA, 26 June–1 July 2016; pp. 770–778. [Google Scholar]
- Simonyan, K.; Zisserman, A. Very Deep Convolutional Networks for Large-Scale Image Recognition. In Proceedings of the International Conference on Learning Representations (ICLR), San Diego, CA, USA, 7–9 May 2015. [Google Scholar]
- Krizhevsky, A.; Sutskever, I.; Hinton, G.E. ImageNet Classification with Deep Convolutional Neural Networks. In Advances in Neural Information Processing Systems (NeurIPS) 25; Curran Associates: Lake Tahoe, NV, USA, 2012; pp. 1097–1105. [Google Scholar]
- Ren, S.; He, K.; Girshick, R.; Sun, J. Faster R-CNN: Towards Real-Time Object Detection with Region Proposal Networks. In Advances in Neural Information Processing Systems (NeurIPS) 28; Curran Associates: Montréal, QC, Canada, 2015; pp. 91–99. [Google Scholar]
- Liu, W.; Anguelov, D.; Erhan, D.; Szegedy, C.; Reed, S.; Fu, C.-Y.; Berg, A.C. SSD: Single Shot MultiBox Detector. In Proceedings of the European Conference on Computer Vision (ECCV), Amsterdam, The Netherlands, 11–14 October 2016; pp. 21–37. [Google Scholar]
- Girshick, R. Fast R-CNN. In Proceedings of the IEEE International Conference on Computer Vision (ICCV), Santiago, Chile, 7–13 December 2015; pp. 1440–1448. [Google Scholar]
- He, K.; Gkioxari, G.; Dollár, P.; Girshick, R. Mask R-CNN. In Proceedings of the IEEE International Conference on Computer Vision (ICCV), Venice, Italy, 22–29 October 2017; pp. 2961–2969. [Google Scholar]
- Bewley, A.; Ge, Z.; Ott, L.; Ramos, F.; Upcroft, B. Simple Online and Realtime Tracking. In Proceedings of the IEEE International Conference on Image Processing (ICIP), Phoenix, AZ, USA, 25–28 September 2016; pp. 3464–3468. [Google Scholar]
- Wojke, N.; Bewley, A.; Paulus, D. Simple Online and Realtime Tracking with a Deep Association Metric. In Proceedings of the IEEE International Conference on Image Processing (ICIP), Beijing, China, 17–20 September 2017; pp. 3645–3649. [Google Scholar]
- Wang, C.-Y.; Bochkovskiy, A.; Liao, H.-Y.M. YOLOv7: Trainable Bag-of-Freebies Sets New State-of-the-Art for Real-Time Object Detectors. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), Vancouver, BC, Canada, 17–24 June 2023; pp. 7464–7475. [Google Scholar]
- Wang, A.; Chen, H.; Liu, L.; Chen, K.; Lin, Z.; Han, J.; Ding, G. YOLOv10: Real-Time End-to-End Object Detection. In Advances in Neural Information Processing Systems (NeurIPS) 37; Curran Associates: Vancouver, BC, Canada, 2024; pp. 107984–108011. [Google Scholar]
- Tian, Y.; Ye, Q.; Doermann, D. YOLOv12: Attention-Centric Real-Time Object Detectors. In Advances in Neural Information Processing Systems (NeurIPS) 38; Curran Associates: San Diego, CA, USA, 2025; pp. 78433–78457. [Google Scholar]
- Sandler, M.; Howard, A.; Zhu, M.; Zhmoginov, A.; Chen, L.-C. MobileNetV2: Inverted Residuals and Linear Bottlenecks. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR), Salt Lake City, UT, USA, 18–23 June 2018; pp. 4510–4520. [Google Scholar]
- Tan, M.; Le, Q. EfficientNet: Rethinking Model Scaling for Convolutional Neural Networks. In Proceedings of the International Conference on Machine Learning (ICML), Long Beach, CA, USA, 9–15 June 2019; pp. 6105–6114. [Google Scholar]
- Dosovitskiy, A.; Beyer, L.; Kolesnikov, A.; Weissenborn, D.; Zhai, X.; Unterthiner, T.; Dehghani, M.; Minderer, M.; Heigold, G.; Gelly, S.; et al. An Image Is Worth 16×16 Words: Transformers for Image Recognition at Scale. In Proceedings of the International Conference on Learning Representations (ICLR), Virtual, 3–7 May 2021. [Google Scholar]
- Liu, Z.; Lin, Y.; Cao, Y.; Hu, H.; Wei, Y.; Zhang, Z.; Lin, S.; Guo, B. Swin Transformer: Hierarchical Vision Transformer Using Shifted Windows. In Proceedings of the IEEE/CVF International Conference on Computer Vision (ICCV), Montreal, QC, Canada, 10–17 October 2021; pp. 10012–10022. [Google Scholar]
- Mehta, S.; Rastegari, M. MobileViT: Light-Weight, General-Purpose, and Mobile-Friendly Vision Transformer. In Proceedings of the International Conference on Learning Representations (ICLR), Virtual, 25 April 2022. [Google Scholar]
- Li, Y.; Yuan, G.; Wen, Y.; Hu, J.; Evangelidis, G.; Tulyakov, S.; Wang, Y.; Ren, J. EfficientFormer: Vision Transformers at MobileNet Speed. In Advances in Neural Information Processing Systems (NeurIPS) 35; Curran Associates: New Orleans, LA, USA, 2022. [Google Scholar]
- Zheng, Y.-Y.; Kong, J.-L.; Jin, X.-B.; Wang, X.-Y.; Su, T.-L.; Zuo, M. CropDeep: The Crop Vision Dataset for Deep-Learning-Based Classification and Detection in Precision Agriculture. Sensors 2019, 19, 1058. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Patrashko, D.Y.; Gurau, V. Machine Learning-Powered Vision for Robotic Inspection in Manufacturing: A Review. Sensors 2026, 26, 788. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Gholami, A.; Kim, S.; Dong, Z.; Yao, Z.; Mahoney, M.W.; Keutzer, K. A Survey of Quantization Methods for Efficient Neural Network Inference. In Low-Power Computer Vision: Improving the Efficiency of Artificial Intelligence; Thiruvathukal, G.K., Lu, Y.-H., Kim, J., Chen, Y., Chen, B., Eds.; Chapman and Hall/CRC: Boca Raton, FL, USA, 2022; pp. 291–326. [Google Scholar]
- Hawks, B.; Duarte, J.; Fraser, N.J.; Pappalardo, A.; Tran, N.; Umuroglu, Y. Ps and Qs: Quantization-Aware Pruning for Efficient Low-Latency Neural Network Inference. Front. Artif. Intell. 2021, 4, 676564. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Trigkas, A.; Piromalis, D.; Papageorgas, P. Edge Intelligence in Urban Landscapes: Reviewing TinyML Applications for Connected and Sustainable Smart Cities. Electronics 2025, 14, 2890. [Google Scholar] [CrossRef] [Scilit]
- Liang, T.; Glossner, J.; Wang, L.; Shi, S.; Zhang, X. Pruning and Quantization for Deep Neural Network Acceleration: A Survey. Neurocomputing 2021, 461, 370–403. [Google Scholar] [CrossRef] [Scilit]
- Han, S.; Mao, H.; Dally, W.J. Deep Compression: Compressing Deep Neural Networks with Pruning, Trained Quantization and Huffman Coding. In Proceedings of the International Conference on Learning Representations (ICLR), San Juan, PR, USA, 2–4 May 2016. [Google Scholar]
- Liu, Z.; Li, J.; Shen, Z.; Huang, G.; Yan, S.; Zhang, C. Learning Efficient Convolutional Networks Through Network Slimming. In Proceedings of the IEEE International Conference on Computer Vision (ICCV), Venice, Italy, 22–29 October 2017; pp. 2736–2744. [Google Scholar]
- Blalock, D.; Gonzalez Ortiz, J.J.; Frankle, J.; Guttag, J. What Is the State of Neural Network Pruning? In Proceedings of the Machine Learning and Systems (MLSys), Austin, TX, USA, 2–4 March 2020; Volume 2, pp. 129–146. [Google Scholar]
- Chen, L.; Wu, P.; Chitta, K.; Jaeger, B.; Geiger, A.; Li, H. End-to-End Autonomous Driving: Challenges and Frontiers. IEEE Trans. Pattern Anal. Mach. Intell. 2024, 46, 10164–10183. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Sun, P.; Kretzschmar, H.; Dotiwalla, X.; Chouard, A.; Patnaik, V.; Tsui, P.; Guo, J.; Zhou, Y.; Chai, Y.; Caine, B.; et al. Scalability in Perception for Autonomous Driving: Waymo Open Dataset. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), Seattle, WA, USA, 13–19 June 2020; pp. 2446–2454. [Google Scholar]
- Yurtsever, E.; Lambert, J.; Carballo, A.; Takeda, K. A Survey of Autonomous Driving: Common Practices and Emerging Technologies. IEEE Access 2020, 8, 58443–58469. [Google Scholar] [CrossRef] [Scilit]
- Yang, S.-Y.; Cheng, H.-Y.; Yu, C.-C. Real-Time Object Detection and Tracking for Unmanned Aerial Vehicles Based on Convolutional Neural Networks. Electronics 2023, 12, 4928. [Google Scholar] [CrossRef] [Scilit]
- Zhang, P.; Zhong, Y.; Li, X. SlimYOLOv3: Narrower, Faster and Better for Real-Time UAV Applications. In Proceedings of the IEEE/CVF International Conference on Computer Vision Workshop (ICCVW), Seoul, Republic of Korea, 27–28 October 2019; pp. 37–45. [Google Scholar]
- Kyrkou, C.; Plastiras, G.; Theocharides, T.; Venieris, S.I.; Bouganis, C.-S. DroNet: Efficient Convolutional Neural Network Detector for Real-Time UAV Applications. In Proceedings of the Design, Automation & Test in Europe Conference & Exhibition (DATE), Dresden, Germany, 19–23 March 2018; pp. 967–972. [Google Scholar]
- Vijayakumar, A.; Vairavasundaram, S. A Review on Object Detection in Unmanned Aerial Vehicle Surveillance. Int. J. Cogn. Comput. Eng. 2021, 2, 215–228. [Google Scholar] [CrossRef] [Scilit]
- Kamtam, D.N.; Malla, S.D.; Shrager, J.B. Deep Learning Approaches to Surgical Video Segmentation and Object Detection: A Scoping Review. Comput. Biol. Med. 2025, 191, 110082. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Redmon, J.; Farhadi, A. YOLO9000: Better, Faster, Stronger. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR), Honolulu, HI, USA, 21–26 July 2017; pp. 6517–6525. [Google Scholar]
- Wang, C.-Y.; Liao, H.-Y.M.; Wu, Y.-H.; Chen, P.-Y.; Hsieh, J.-W.; Yeh, I.-H. CSPNet: A New Backbone That Can Enhance Learning Capability of CNN. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR) Workshops, Seattle, WA, USA, 14–19 June 2020; pp. 390–391. [Google Scholar]
- Jocher, G. YOLOv5 by Ultralytics, Version 7.0; Zenodo: Geneva, Switzerland, 2020; Available online: https://github.com/ultralytics/yolov5 (accessed on 4 October 2026). [CrossRef]
- Jocher, G.; Chaurasia, A.; Qiu, J. Ultralytics YOLOv8; Version 8.0.0. 2023. Available online: https://github.com/ultralytics/ultralytics (accessed on 4 October 2026).
- Wang, C.-Y.; Yeh, I.-H.; Liao, H.-Y.M. YOLOv9: Learning What You Want to Learn Using Programmable Gradient Information. In Proceedings of the European Conference on Computer Vision (ECCV), Milan, Italy, 29 September–4 October 2024; pp. 1–21. [Google Scholar]
- Tan, M.; Pang, R.; Le, Q.V. EfficientDet: Scalable and Efficient Object Detection. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), Seattle, WA, USA, 13–19 June 2020; pp. 10781–10790. [Google Scholar]
- Carion, N.; Massa, F.; Synnaeve, G.; Usunier, N.; Kirillov, A.; Zagoruyko, S. End-to-End Object Detection with Transformers. In Proceedings of the European Conference on Computer Vision (ECCV), Glasgow, UK, 23–28 August 2020; pp. 213–229. [Google Scholar]
- Zhao, Y.; Lv, W.; Xu, S.; Wei, J.; Wang, G.; Dang, Q.; Liu, Y.; Chen, J. DETRs Beat YOLOs on Real-Time Object Detection. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), Seattle, WA, USA, 16–22 June 2024; pp. 16965–16974. [Google Scholar]
- Liu, Y.; Zhang, C.; Dong, X. A Survey of Real-Time Surface Defect Inspection Methods Based on Deep Learning. Artif. Intell. Rev. 2023, 56, 12131–12170. [Google Scholar] [CrossRef] [Scilit]
- Broni-Bediako, C.; Xia, J.; Yokoya, N. Real-Time Semantic Segmentation: A Brief Survey and Comparative Study in Remote Sensing. IEEE Geosci. Remote Sens. Mag. 2023, 11, 94–124. [Google Scholar] [CrossRef] [Scilit]
- Pan, H.; Hong, Y.; Sun, W.; Jia, Y. Deep Dual-Resolution Networks for Real-Time and Accurate Semantic Segmentation of Traffic Scenes. IEEE Trans. Intell. Transp. Syst. 2023, 24, 3448–3460. [Google Scholar] [CrossRef] [Scilit]
- Li, B.; Tang, X.; Ruan, C.; Fu, C.; Tao, Z.; Yang, Y. A Survey on Real-Time Semantic Segmentation Based on Deep Learning. In Big Data and Security (ICBDS 2023); Communications in Computer and Information Science, Volume 2099; Springer: Singapore, 2024. [Google Scholar]
- Ciaparrone, G.; Luque Sánchez, F.; Tabik, S.; Troiano, L.; Tagliaferri, R.; Herrera, F. Deep Learning in Video Multi-Object Tracking: A Survey. Neurocomputing 2020, 381, 61–88. [Google Scholar] [CrossRef] [Scilit]
- Zhang, Y.; Sun, P.; Jiang, Y.; Yu, D.; Weng, F.; Yuan, Z.; Luo, P.; Liu, W.; Wang, X. ByteTrack: Multi-Object Tracking by Associating Every Detection Box. In Proceedings of the European Conference on Computer Vision (ECCV), Tel Aviv, Israel, 23–27 October 2022; pp. 1–21. [Google Scholar]
- Ioffe, S.; Szegedy, C. Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift. In Proceedings of the International Conference on Machine Learning (ICML), Lille, France, 6–11 July 2015; pp. 448–456. [Google Scholar]
- Howard, A.; Sandler, M.; Chu, G.; Chen, L.-C.; Chen, B.; Tan, M.; Wang, W.; Zhu, Y.; Pang, R.; Vasudevan, V.; et al. Searching for MobileNetV3. In Proceedings of the IEEE/CVF International Conference on Computer Vision (ICCV), Seoul, Republic of Korea, 29 October–1 November 2019; pp. 1314–1324. [Google Scholar]
- Vaswani, A.; Shazeer, N.; Parmar, N.; Uszkoreit, J.; Jones, L.; Gomez, A.N.; Kaiser, Ł.; Polosukhin, I. Attention Is All You Need. In Advances in Neural Information Processing Systems (NeurIPS) 30; Curran Associates: Long Beach, CA, USA, 2017; pp. 5998–6008. [Google Scholar]
- Radford, A.; Kim, J.W.; Hallacy, C.; Ramesh, A.; Goh, G.; Agarwal, S.; Sastry, G.; Askell, A.; Mishkin, P.; Clark, J.; et al. Learning Transferable Visual Models From Natural Language Supervision. In Proceedings of the International Conference on Machine Learning (ICML), Virtual, 18–24 July 2021; pp. 8748–8763. [Google Scholar]
- Kirillov, A.; Mintun, E.; Ravi, N.; Mao, H.; Rolland, C.; Gustafson, L.; Xiao, T.; Whitehead, S.; Berg, A.C.; Lo, W.-Y.; et al. Segment Anything. In Proceedings of the IEEE/CVF International Conference on Computer Vision (ICCV), Paris, France, 2–6 October 2023; pp. 4015–4026. [Google Scholar]
- Liu, S.; Zeng, Z.; Ren, T.; Li, F.; Zhang, H.; Yang, J.; Jiang, Q.; Li, C.; Yang, J.; Su, H.; et al. Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection. In Computer Vision—ECCV 2024; Lecture Notes in Computer Science, Volume 15105; Springer: Cham, Switzerland, 2024; pp. 38–55. [Google Scholar]
- Liu, H.; Li, C.; Wu, Q.; Lee, Y.J. Visual Instruction Tuning. In Advances in Neural Information Processing Systems (NeurIPS) 36; Curran Associates: New Orleans, LA, USA, 2023. [Google Scholar]
- Han, X.; Chen, S.; Fu, Z.; Feng, Z.; Fan, L.; An, D.; Wang, C.; Guo, L.; Meng, W.; Zhang, X.; et al. Multimodal Fusion and Vision-Language Models: A Survey for Robot Vision. Inf. Fusion 2025, 126, 103652. [Google Scholar] [CrossRef] [Scilit]
- Zhou, C.; Li, X.; Loy, C.C.; Dai, B. EdgeSAM: Prompt-In-the-Loop Distillation for SAM. Int. J. Comput. Vis. 2025, 133, 8452–8468. [Google Scholar] [CrossRef] [Scilit]
- Yao, Y.; Yu, T.; Zhang, A.; Wang, C.; Cui, J.; Zhu, H.; Cai, T.; Chen, C.; Li, H.; Zhao, W.; et al. Efficient GPT-4V Level Multimodal Large Language Model for Deployment on Edge Devices. Nat. Commun. 2025, 16, 5509. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Jacob, B.; Kligys, S.; Chen, B.; Zhu, M.; Tang, M.; Howard, A.; Adam, H.; Kalenichenko, D. Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR), Salt Lake City, UT, USA, 18–22 June 2018; pp. 2704–2713. [Google Scholar]
- Liu, H.; Fan, K.; Ouyang, Q.; Li, N. Real-Time Small Drones Detection Based on Pruned YOLOv4. Sensors 2021, 21, 3374. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Ghimire, D.; Kil, D.; Kim, S.-H. A Survey on Efficient Convolutional Neural Networks and Hardware Acceleration. Electronics 2022, 11, 945. [Google Scholar] [CrossRef] [Scilit]
- Wang, L.; Yoon, K.-J. Knowledge Distillation and Student-Teacher Learning for Visual Intelligence: A Review and New Outlooks. IEEE Trans. Pattern Anal. Mach. Intell. 2022, 44, 3048–3068. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Zoph, B.; Le, Q.V. Neural Architecture Search with Reinforcement Learning. In Proceedings of the International Conference on Learning Representations (ICLR), Toulon, France, 24–26 April 2017. [Google Scholar]
- Micikevicius, P.; Narang, S.; Alben, J.; Diamos, G.; Elsen, E.; Garcia, D.; Ginsburg, B.; Houston, M.; Kuchaiev, O.; Venkatesh, G.; et al. Mixed Precision Training. In Proceedings of the International Conference on Learning Representations (ICLR), Vancouver, BC, Canada, 30 April–3 May 2018. [Google Scholar]
- Chen, T.; Moreau, T.; Jiang, Z.; Zheng, L.; Yan, E.; Cowan, M.; Shen, H.; Wang, L.; Hu, Y.; Ceze, L.; et al. TVM: An Automated End-to-End Optimizing Compiler for Deep Learning. In Proceedings of the 13th USENIX Symposium on Operating Systems Design and Implementation (OSDI 18), Carlsbad, CA, USA, 8–10 October 2018; pp. 578–594. [Google Scholar]
- Choe, C.; Choe, M.; Jung, S. Run Your 3D Object Detector on NVIDIA Jetson Platforms: A Benchmark Analysis. Sensors 2023, 23, 4005. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Denton, E.L.; Zaremba, W.; Bruna, J.; LeCun, Y.; Fergus, R. Exploiting Linear Structure Within Convolutional Networks for Efficient Evaluation. In Advances in Neural Information Processing Systems (NeurIPS) 27; Curran Associates: Montreal, QC, Canada, 2014; pp. 1269–1277. [Google Scholar]
- Umuroglu, Y.; Fraser, N.J.; Gambardella, G.; Blott, M.; Leong, P.; Jahre, M.; Vissers, K. FINN: A Framework for Fast, Scalable Binarized Neural Network Inference. In Proceedings of the ACM/SIGDA International Symposium on Field-Programmable Gate Arrays (FPGA), Monterey, CA, USA, 22–24 February 2017; pp. 65–74. [Google Scholar]
- Novac, P.-E.; Boukli Hacene, G.; Pegatoquet, A.; Miramond, B.; Gripon, V. Quantization and Deployment of Deep Neural Networks on Microcontrollers. Sensors 2021, 21, 2984. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Swaminathan, T.P.; Silver, C.; Akilan, T.; Kumar, J. Benchmarking Deep Learning Models on NVIDIA Jetson Nano for Real-Time Systems: An Empirical Investigation. Procedia Comput. Sci. 2025, 260, 906–913. [Google Scholar] [CrossRef] [Scilit]
- Magalhães, S.C.; Santos, F.N.; Machado, P.; Moreira, A.P.; Dias, J. Benchmarking Edge Computing Devices for Grape Bunches and Trunks Detection Using Accelerated Object Detection Single Shot MultiBox Deep Learning Models. Eng. Appl. Artif. Intell. 2023, 117, 105604. [Google Scholar] [CrossRef] [Scilit]
- Cantero, D.; Esnaola-Gonzalez, I.; Miguel-Alonso, J.; Jauregi, E. Benchmarking Object Detection Deep Learning Models in Embedded Devices. Sensors 2022, 22, 4205. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Lin, T.-Y.; Maire, M.; Belongie, S.; Hays, J.; Perona, P.; Ramanan, D.; Dollár, P.; Zitnick, C.L. Microsoft COCO: Common Objects in Context. In Proceedings of the European Conference on Computer Vision (ECCV), Zurich, Switzerland, 6–12 September 2014; pp. 740–755. [Google Scholar]
- Everingham, M.; Van Gool, L.; Williams, C.K.I.; Winn, J.; Zisserman, A. The Pascal Visual Object Classes (VOC) Challenge. Int. J. Comput. Vis. 2010, 88, 303–338. [Google Scholar] [CrossRef] [Scilit]
- Cordts, M.; Omran, M.; Ramos, S.; Rehfeld, T.; Enzweiler, M.; Benenson, R.; Franke, U.; Roth, S.; Schiele, B. The Cityscapes Dataset for Semantic Urban Scene Understanding. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR), Las Vegas, NV, USA, 27–30 June 2016. [Google Scholar]
- Geiger, A.; Lenz, P.; Urtasun, R. Are We Ready for Autonomous Driving? The KITTI Vision Benchmark Suite. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR), Providence, RI, USA, 16–21 June 2012; pp. 3354–3361. [Google Scholar]
- Lin, T.-Y.; Dollár, P.; Girshick, R.; He, K.; Hariharan, B.; Belongie, S. Feature Pyramid Networks for Object Detection. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR), Honolulu, HI, USA, 21–26 July 2017; pp. 2117–2125. [Google Scholar]
- Zhu, Z.; Wang, Q.; Li, B.; Wu, W.; Yan, J.; Hu, W. Distractor-Aware Siamese Networks for Visual Object Tracking. In Proceedings of the European Conference on Computer Vision (ECCV), Munich, Germany, 8–14 September 2018; pp. 101–117. [Google Scholar]
- Wang, Q.; Zhang, L.; Bertinetto, L.; Hu, W.; Torr, P.H.S. Fast Online Object Tracking and Segmentation: A Unifying Approach. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (CVPR), Long Beach, CA, USA, 15–20 June 2019; pp. 1328–1338. [Google Scholar]
- Mur-Artal, R.; Montiel, J.M.M.; Tardós, J.D. ORB-SLAM: A Versatile and Accurate Monocular SLAM System. IEEE Trans. Robot. 2015, 31, 1147–1163. [Google Scholar] [CrossRef] [Scilit]
- Gog, I.; Kalra, S.; Schafhalter, P.; Wright, M.A.; Gonzalez, J.E.; Stoica, I. Pylot: A Modular Platform for Exploring Latency-Accuracy Tradeoffs in Autonomous Vehicles. In Proceedings of the 2021 IEEE International Conference on Robotics and Automation (ICRA), Xi’an, China, 30 May–5 June 2021; pp. 8806–8813. [Google Scholar]
- Pham, T.M.-T.; Costa, D.E.; Shang, W.; Yang, J. ADPerf: Investigating and Testing Performance in Autonomous Driving Systems. In Proceedings of the 40th IEEE/ACM International Conference on Automated Software Engineering (ASE), Seoul, Republic of Korea, 16–20 November 2025. [Google Scholar]
- Quigley, M.; Gerkey, B.; Conley, K.; Faust, J.; Foote, T.; Leibs, J.; Berger, E.; Wheeler, R.; Ng, A. ROS: An Open-Source Robot Operating System. In Proceedings of the IEEE International Conference on Robotics and Automation (ICRA), Workshop on Open Source Software, Kobe, Japan, 12–17 May 2009. [Google Scholar]
- Mwitta, C.; Rains, G.C.; Prostko, E. Evaluation of Inference Performance of Deep Learning Models for Real-Time Weed Detection in an Embedded Computer. Sensors 2024, 24, 514. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Milioto, A.; Lottes, P.; Stachniss, C. Real-Time Semantic Segmentation of Crop and Weed for Precision Agriculture Robots Leveraging Background Knowledge in CNNs. In Proceedings of the IEEE International Conference on Robotics and Automation (ICRA), Brisbane, Australia, 21–25 May 2018; pp. 2229–2235. [Google Scholar]
- Nie, M.Y. Artificial Intelligence Algorithms for Real-Time Detection of Colorectal Polyps During Colonoscopy: A Review. Am. J. Cancer Res. 2024, 14, 5456–5470. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Zhang, J.; Yang, F.; Li, B.; Gu, X. A High-Performance and Lightweight Framework for Real-Time Solar Cell Surface Defect Detection on Edge Devices. J. Real-Time Image Process. 2026, 23, 1267. [Google Scholar] [CrossRef] [Scilit]
- Wang, P.; Xiao, X.; Glissen Brown, J.R.; Berzin, T.M.; Tu, M.; Xiong, F.; Hu, X.; Liu, P.; Song, Y.; Zhang, D.; et al. Development and Validation of a Deep-Learning Algorithm for the Detection of Polyps During Colonoscopy. Nat. Biomed. Eng. 2018, 2, 741–748. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Jebur, S.A.; Hussein, K.A.; Hoomod, H.K.; Alzubaidi, L.; Santamaría, J. Review on Deep Learning Approaches for Anomaly Event Detection in Video Surveillance. Electronics 2023, 12, 29. [Google Scholar] [CrossRef] [Scilit]
- Xiao, Y.; Jiang, A.; Ye, J.; Wang, M. Making of Night Vision: Object Detection Under Low-Illumination. IEEE Access 2020, 8, 123075–123086. [Google Scholar] [CrossRef] [Scilit]
Авторы: Abdussalam Elhanashi, Sergio Saponara