Компьютерное зрение и обработка изображений — это быстро развивающиеся области с широким спектром применения в различных сферах, включая здравоохранение, автономное вождение, видеонаблюдение и развлечения. Эти области трансформировались из простых методов записи данных в сложные системы, включающие цифровую обработку изображений, распознавание образов, машинное обучение и компьютерную графику. Эта эволюция вызвала междисциплинарный интерес, расширила границы технологий и их практическое применение.
В данной статье представлен всесторонний обзор последних достижений в области компьютерного зрения, с акцентом на обработку изображений и ее применение в различных областях. Рассматриваются теоретические основы и технологии, которые делают компьютерное зрение ценным инструментом для интерпретации изображений и видео, извлечения релевантной информации, распознавания образов и понимания событий. Способность компьютерного зрения анализировать большие наборы данных в различных областях применения делает его незаменимым инструментом в таких задачах, как идентификация объектов, распознавание лиц, понимание сцен и даже прогнозирование действий в реальном времени.
Эта универсальность сделала компьютерное зрение ключевым фактором получения аналитических данных как в научном, так и в коммерческом секторах. В исследовании компьютерное зрение подразделяется на четыре основные области: обработка изображений, распознавание объектов, машинное обучение и компьютерная графика. Каждая из этих категорий имеет важное значение для функционирования современных систем компьютерного зрения. Обработка изображений включает в себя методы повышения качества изображений и извлечения важных признаков.
Распознавание объектов и машинное обучение позволяют идентифицировать конкретные элементы на изображениях и дают системам возможность обучаться на больших наборах данных, повышая точность с течением времени. Компьютерная графика, с другой стороны, помогает визуализировать и интерпретировать обработанные данные. Предлагая информацию о новейших методах и оценивая их производительность, этот обзор освещает текущее состояние компьютерного зрения и проливает свет на будущие тенденции. Расширяющееся применение компьютерного зрения в различных областях подчеркивает его критически важную роль в стимулировании междисциплинарных инноваций и решении сложных задач.
Введение
В связи с развитием искусственного интеллекта на основе нейронных сетей [1], таких как распознавание лиц и действий [2, 3], сети мультимедийных систем [4 – 6], LLM и генеративные модели [7 – 11], автоматическая навигация[12, 13], а также в медицине [14], спектроскопии [15, 16], здравоохранении[14, 17-20], охране окружающей среды [21], научных исследованиях [18, 22] и оптимизации проектирования [23] и т. д., компьютерное зрение стало многогранной областью, эволюционировавшей от простой записи необработанных данных до сложных методов извлечения закономерностей и интерпретации информации из изображений и видео. В инженерных приложениях прогресс был достигнут благодаря компьютерному зрению в хирургии трансплантации печени [24 – 28].
Недавние достижения в области социального обучения [29 – 36] дают еще большее представление о применении в реальном мире. Как одна из наиболее выдающихся областей применения, наибольший прогресс был достигнут в компьютерном зрении [37 – 43] благодаря мощной программной [44 – 46] и аппаратной поддержке [47 – 51], такой как миллиметровые волновые технологии и робототехника [52].
Сегодня компьютерное зрение используется в широком спектре приложений, связанных с получением и анализом визуальной информации из цифровых входных данных. В основе компьютерного зрения лежит стремление воспроизвести аспекты человеческого зрения, позволяя машинам воспринимать, интерпретировать и принимать решения на основе визуальных данных. Этот процесс требует методов извлечения признаков и обнаружения событий, которые различаются в зависимости от области применения.
Компьютерное зрение объединяет две ключевые области: обработку изображений и распознавание образов [38 – 41, 43]. В то время как обработка изображений в основном фокусируется на манипулировании и улучшении изображений для повышения качества или извлечения полезных признаков, распознавание образов включает в себя идентификацию и классификацию объектов или паттернов на изображениях.
Вместе эти области позволяют создавать алгоритмы, способные интерпретировать пространственные данные, что в конечном итоге приводит к тому, что известно как «понимание изображения». Разработка методов компьютерного зрения во многом вдохновлена человеческими зрительными способностями, хотя достижение полностью человекоподобной системы зрения остается за пределами возможностей современных технологий из-за ограничений в машинной интерпретации и обработке.
Цели компьютерного зрения и обработки изображений, хотя и связаны, различны. Основная цель компьютерного зрения — создание моделей, которые извлекают релевантные данные и интерпретируют их, что позволяет понимать изображение. В отличие от этого, обработка изображений включает в себя вычислительные преобразования, такие как повышение резкости, регулировка контраста и другие улучшения, которые оптимизируют визуальную четкость.
Хотя эти две области тесно связаны, иногда они пересекаются с взаимодействием человека и компьютера (HCI) [53], которое фокусируется на проектировании и взаимодействии между людьми и компьютерами. Взаимодействие человека с компьютером (HCI) развилось как междисциплинарная область, изучающая взаимодействие человека с технологиями с учетом проектирования, ориентированного на пользователя, эргономики интерфейса и общей эффективности взаимодействия человека с компьютером.
Однако, в отличие от взаимодействия человека с компьютером, компьютерное зрение фокусируется именно на интерпретации визуальных данных.
Функционально как компьютерное зрение, так и человеческое зрение направлены на интерпретацию пространственных данных, что позволяет понимать объекты, сцены и действия. Однако производительность систем компьютерного зрения остается ограниченной по сравнению с человеческой зрительной системой. Несмотря на достижения, компьютерное зрение не может в полной мере воспроизвести нюансы человеческого зрения, поскольку системам не хватает той же адаптивности и контекстного понимания.
Разработка алгоритмов, соответствующих точности, гибкости и сложности человеческого восприятия, сопряжена с многочисленными трудностями. Ключевые проблемы включают чувствительность к настройке параметров, устойчивость алгоритмов в различных условиях и обеспечение точных результатов в различных сценариях. Оценка производительности систем компьютерного зрения сложна и требует тщательного тестирования для измерения таких характеристик, как точность, устойчивость и расширяемость.
Это включает в себя изучение основных моделей поведения алгоритмов в различных условиях, а также их способности адаптироваться и поддерживать производительность. Учитывая эти проблемы, ученые прилагают значительные усилия для улучшения алгоритмов компьютерного зрения и их классификации по специализированным областям применения. Эти области применения варьируются от автоматизации производственных и сборочных линий до дистанционного зондирования, робототехники, человеко-компьютерного взаимодействия и вспомогательных средств для людей с нарушениями зрения.
В конечном счете, развитие компьютерного зрения зависит от совершенствования компьютерных технологий, от вычислительной мощности до сложности алгоритмов. По мере развития технологий эта область продолжает расширяться, предлагая новые способы интерпретации и анализа визуальной информации. Данный обзор подчеркивает важную роль компьютерного зрения в преодолении разрыва между возможностями человеческого зрения и машинным анализом, способствуя инновациям, влияющим на различные отрасли, и расширяя границы того, что машины могут воспринимать и понимать.
Последние достижения в исследованиях
Компьютерное зрение использует сложные алгоритмы и оптические датчики для имитации аспектов человеческого зрения [47], что позволяет автоматически извлекать ценную информацию из объектов. В отличие от традиционных методов, которые часто требуют много времени и сложного лабораторного анализа, компьютерное зрение интегрирует искусственный интеллект для достижения более быстрой и эффективной интерпретации визуальных данных.
Эта технология часто сочетается со сложными системами освещения для оптимизации получения изображений и повышения точности анализа изображений. Захватывая цифровые изображения и улучшая их качество посредством предварительной обработки, системы компьютерного зрения могут выделять релевантные объекты из фона, измерять значимые характеристики, а затем точно интерпретировать данные.
Недавние достижения в обработке изображений позволили создать высокоточные системы цифрового распознавания, трансформируя подход к анализу визуальных данных в различных областях [54]. Эти разработки позволяют оптимизировать сбор данных и более сложную интерпретацию изображений, открывая новые возможности для таких приложений, как автоматизированный контроль качества, медицинская визуализация и автономная навигация [55].
Таким образом, компьютерное зрение превратилось в мощный инструмент, способный быстро анализировать изображения и извлекать значимую информацию, улучшая традиционные визуальные методы за счет предоставления структурированного и эффективного подхода к
Обработка изображений в цифровых звуковых системах: Аудиозаписи, полученные с помощью фонографов, с применением высокоточной метрологии и цифровой обработки изображений для измерения формы канавок без прямого контакта.
Обработка изображений в анализе пищевых продуктов: включает в себя выбор, извлечение и классификацию признаков для анализа изображений продуктов питания и напитков, с акцентом на отображение роли и влияние отрасли.
Сверточные нейронные сети (CNN) для обнаружения объектов [56]: Используют искусственные нейронные сети (ANN) для обнаружения границ в задачах обработки изображений.
Цифровая обработка изображений стала важной областью в компьютерном зрении, чему способствуют достижения в нескольких теоретических областях, таких как математика, линейная алгебра, статистика, научные вычисления и вычислительная нейронаука. Эти области обеспечивают основы и методологии, которые поддерживают разработку и совершенствование методов обработки изображений.
Ключевые области внимания включают методы оценки карты глубины, где байесовские методы [57] используются для восстановления трехмерных структур сцены, демонстрируя высокую эффективность оценки глубины на обучающих данных, но проблемы с естественными изображениями. Аналогично, оценка качества изображения для методов ретаргетинга улучшается с помощью нисходящих подходов, предлагая согласованные результаты на основе конкретных метрик качества.
Исследования также распространяются на психофизические эксперименты, изучающие человеческое зрительное восприятие в различных условиях освещения, достигаемое с помощью динамического отображения и технологии HDR, позволяющей различать пиксели в широком диапазоне яркости. Кроме того, в прикладных областях, таких как системы помощи водителю, методы оценки контрастной чувствительности помогают разрабатывать алгоритмы, которые отслеживают видимость водителя и предлагают рекомендации в реальном времени по корректировке скорости в условиях плохой видимости.
Еще одной ключевой областью развития является улучшение освещения на основе изображений, где методы коррекции и разложения цветовых пикселей обеспечивают более совершенный подход, чем традиционные методы выравнивания гистограммы, предлагая улучшенную четкость изображения в условиях низкой освещенности или высокой контрастности. Эти достижения в совокупности подчеркивают развивающуюся область цифровой обработки изображений, акцентируя внимание на улучшенных методологиях и адаптации к конкретным приложениям.
Распознавание образов, фундаментальная область компьютерного зрения, посвящена идентификации объектов с помощью различных методов преобразования изображений, которые улучшают качество и обеспечивают точную интерпретацию. Этот процесс облегчает извлечение информации и принятие решений на основе изображений, полученных с помощью датчиков, с главной целью дать машинам возможность «видеть» так же, как и человек. Компьютерное зрение достигает этого, следуя структурированному рабочему процессу, который обычно включает такие этапы, как получение изображения, предварительная обработка, извлечение признаков, сегментация.
Наиболее популярным методом обнаружения объектов на основе сверточных нейронных сетей является широкое применение во многих приложениях и исследованиях [58, 59]. При этом акцент делается на двухэтапных детекторах, таких как региональные сверточные нейронные сети, например, семейство R-CNN [60]. Эти этапы помогают создать организованный конвейер для обработки визуальной информации и идентификации объектов.
Обычно в системах компьютерного зрения используются две основные методологии: 3D-морфологический анализ и оптимизация пикселей. В то время как 3D-морфологический анализ зарекомендовал себя как стандартный подход к обработке изображений и распознаванию образов, оптимизация пикселей включает в себя углубленный анализ пиксельных структур, включая их морфологию и внутренние характеристики, для
Для улучшения понимания векторных функций. Чтобы получить целостное представление, эти подходы обычно применяются к большим наборам данных, охватывающим несколько слоев геометрической композиции, что делает необходимыми эффективные и точные алгоритмы для извлечения соответствующей количественной информации и понимания сложных цветовых кластеров.
Интеграция 3D-морфологического анализа с методами искусственного интеллекта [38] — такими как нечеткая логика, искусственные нейронные сети и генетические алгоритмы — еще больше повышает точность и эффективность алгоритмов компьютерного зрения, особенно в сценариях, требующих обработки больших объемов данных. Эти методы позволяют выполнять сложные задачи, которые выигрывают от автоматизированного визуального анализа, который в противном случае потребовал бы значительного участия человека.
В практических приложениях компьютерное зрение использует два основных подхода к работе с данными изображений: сегментацию и поиск. Сегментация включает в себя разделение изображения на отдельные области, каждая из которых состоит из пикселей со схожими характеристиками, такими как цвет, текстура или уровень серого.
Процесс сегментации имеет решающее значение для точного обнаружения и интерпретации объектов, поскольку он создает области, которые могут быть проанализированы независимо, что делает его краеугольным камнем в приложениях, где требуется распознавание и классификация объектов. Поиск, напротив, включает в себя использование этих сегментированных областей для поиска похожих изображений, поддерживая такие системы, как поиск изображений на основе содержимого, и расширяя функциональность поисковых систем на основе изображений.
Совместная сегментация и поиск позволяют системам компьютерного зрения эффективно обрабатывать, классифицировать и использовать визуальные данные, поддерживая широкий спектр приложений — от автоматизированного контроля качества до расширенных функций поиска.
В сегментации изображений популярные методы включают в себя методы, основанные на интенсивности, цвете и форме, а также обнаружении краев или границ, которые способствуют улучшению распознавания объектов. В литературе точность сегментации часто оценивается как продемонстрировано на небольшой выборке изображений, в то время как крупномасштабные базы данных изображений требуют специфических настроек параметров для точной классификации.
Передовые подходы к сегментации могут использовать такие методы, как анализ градиентной текстуры, исследование пространства признаков и кластеризация без учителя, для точной локализации объектов и более точного определения границ. Конечная цель сегментации — создание карты сходства, полученной из моделей обнаружения объектов или иерархических процессов сегментации. Этот подход поддерживает модель отображения значимости, которая направлена на выделение наиболее значимых областей изображения. На рисунке 1 показаны различные этапы сегментации изображения.
Модель для этой цели потребует вычисления значений значимости пикселей, сопоставленных с определенными местоположениями в иерархической карте значимости. Некоторые исследователи предлагают модель агрегации, использующую стандартные методы определения значимости для присвоения оценок значимости всем пикселям и сегментам, объединяя их в наиболее значимые кластеры.
Однако у таких моделей агрегации остаются проблемы, поскольку им может не хватать тонкого подхода к взаимодействиям между соседними пикселями, что может повлиять на точность сегментации в плотно упакованных или сложных визуальных данных. Например, хотя агрегация по пикселям помогает установить параметры модели, она может игнорировать локальные зависимости, которые играют решающую роль в определении краев объектов и переходов в детализированных структурах изображений.
Для решения этих проблем современные исследования в области сегментации в компьютерном зрении изучают более сложные модели, которые учитывают динамику взаимосвязей между пикселями, тем самым повышая надежность и глубину визуального анализа в различных приложениях. По мере развития компьютерного зрения эти инновации в сегментации и распознавании образов закладывают основу для более адаптивных и контекстно-ориентированных визуальных систем, способных с возрастающей точностью ориентироваться и интерпретировать реальную среду.
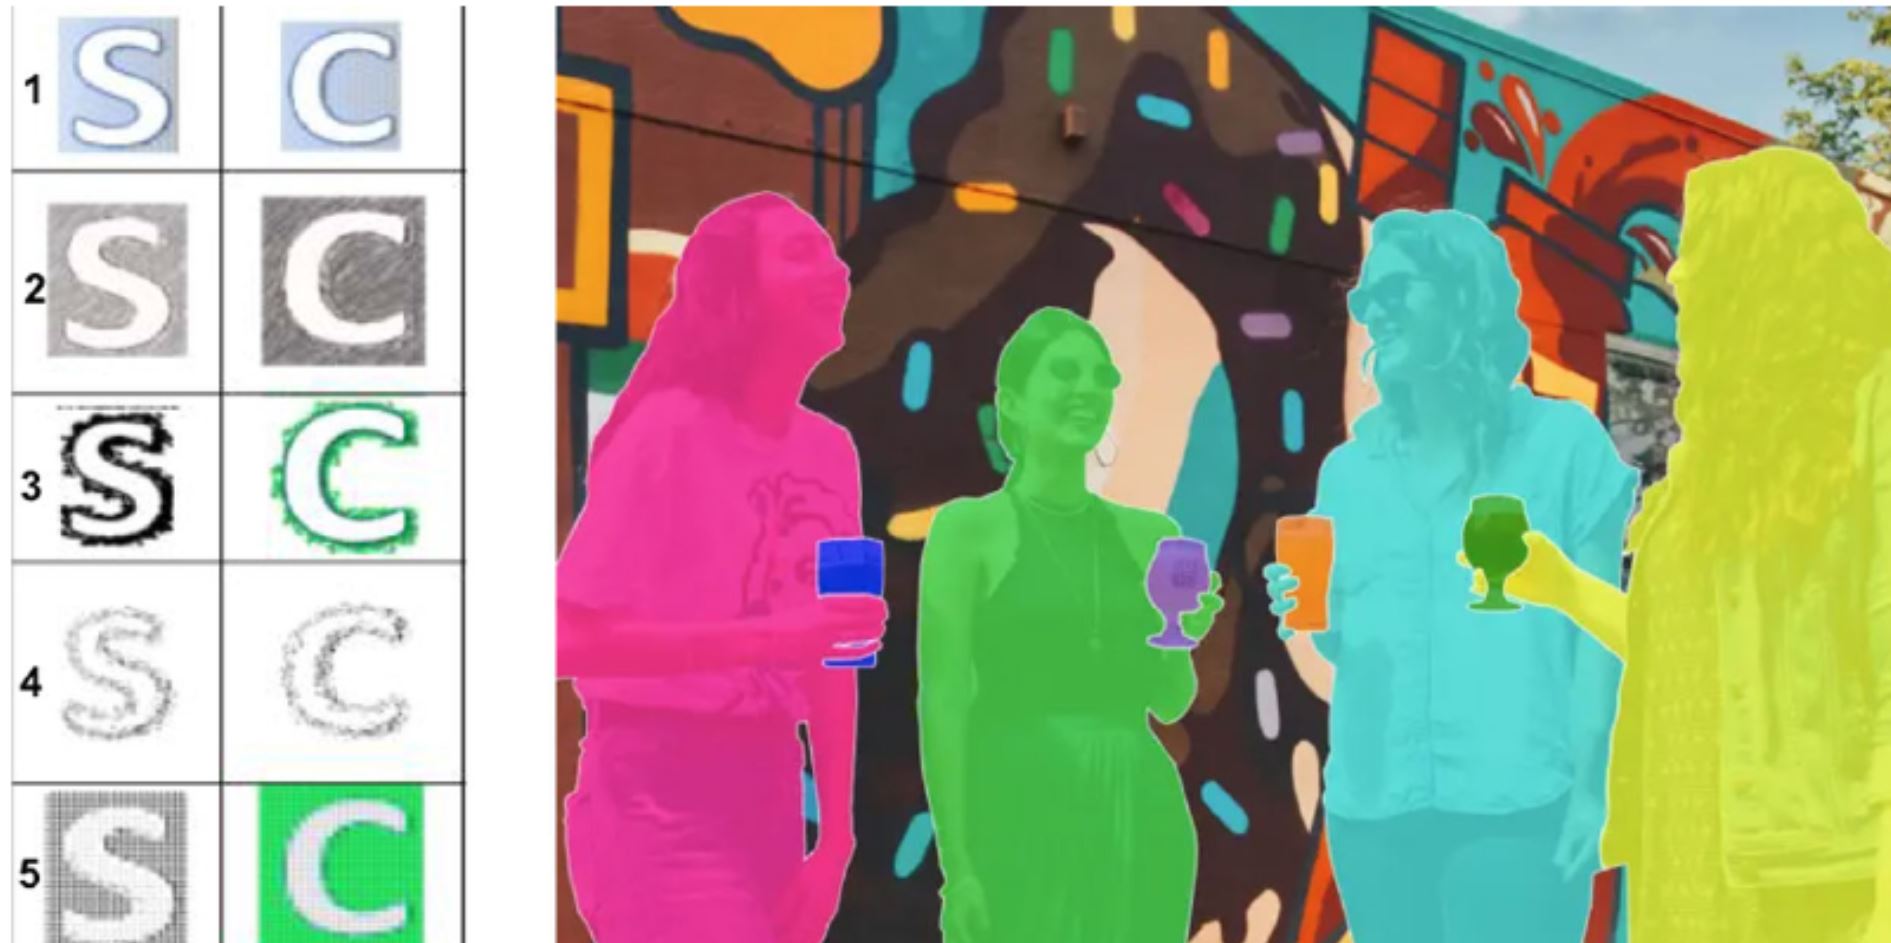
Рисунок 1. Сегментация в обработке изображений: 1. Входное изображение, 2. Сегментированная карта до интеграции, 3. Карта границ до интеграции, 4. Сегментированная карта и карта границ после объединения, 5. Кластеризация пикселей.
Для решения этих проблем Хан предложил использовать условные случайные поля (CRF) для объединения калибровочных карт, полученных несколькими методами, и включения значений из соседних пикселей. Модель агрегации CRF улучшает оптимизацию параметров во время обучения, поскольку надежность каждого пикселя приобретает большее значение при обучении в рамках этой модели. Извлечение данных включает в себя захват объектов, сфотографированных камерами, датчиками или спутниковыми устройствами.
Это может быть как отдельное изображение, так и последовательность изображений. Основная цель этого процесса — отделить элементы фона от объектов переднего плана. В результате могут быть получены три типа изображений: (а) объекты сохраняют свой исходный цвет, (б) объекты преобразуются в черно-белое изображение или (в) объекты становятся прозрачными.
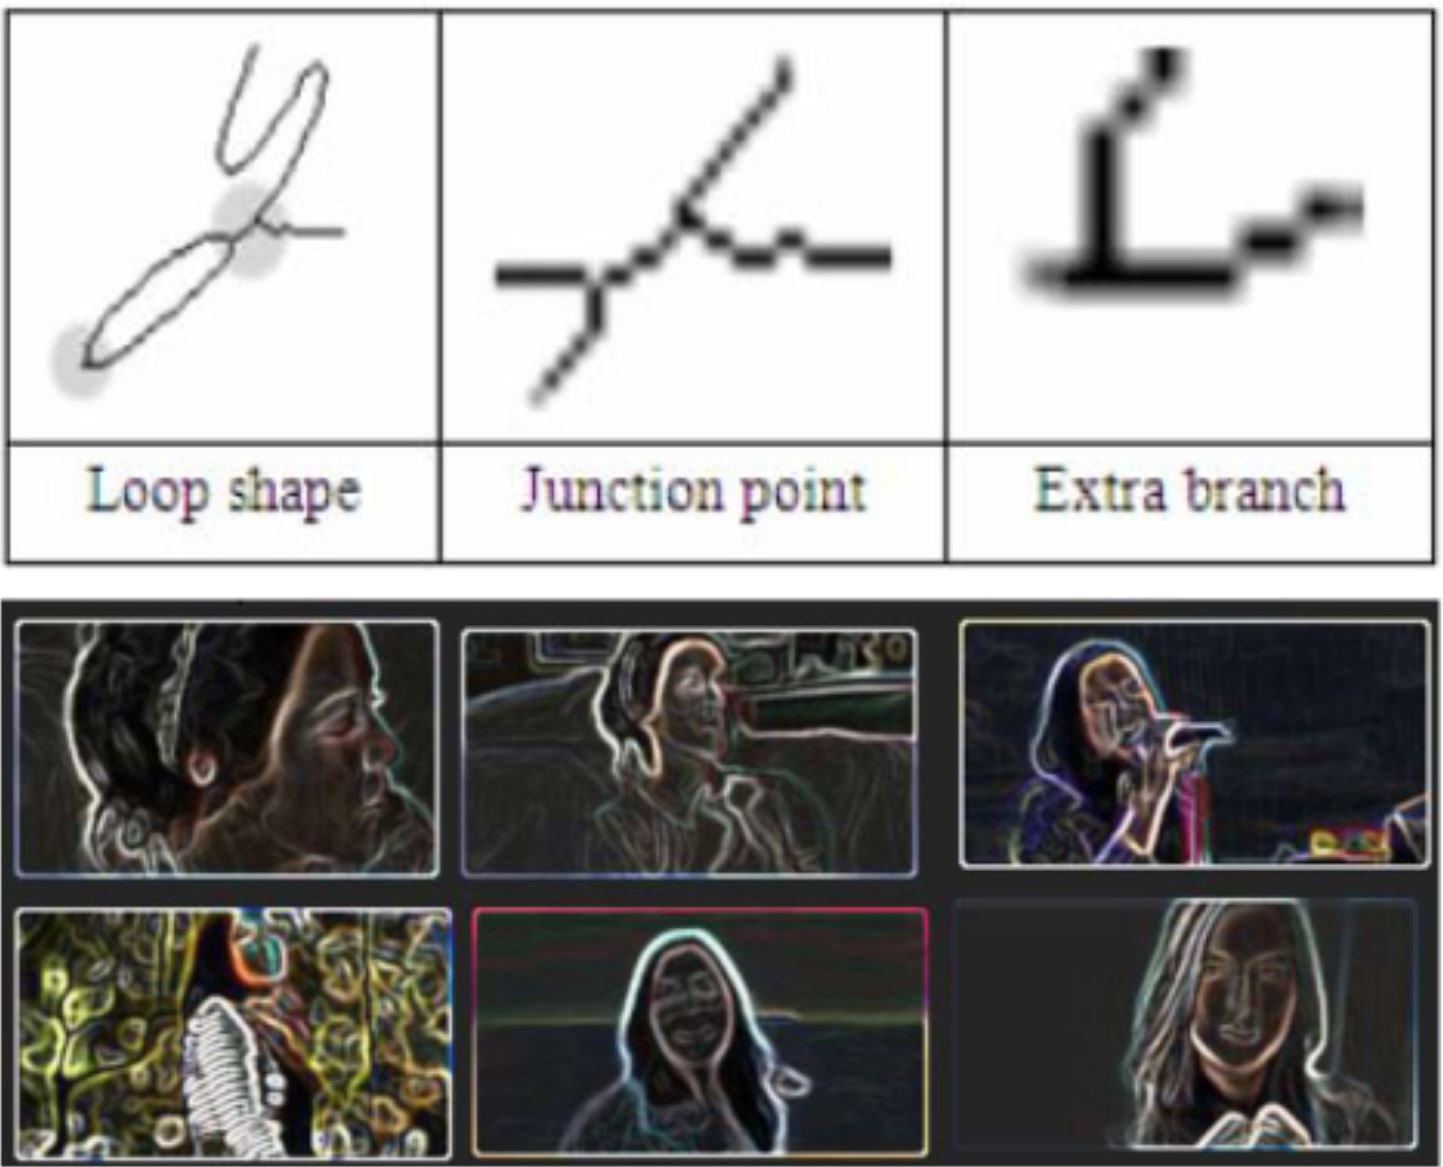
Рисунок 2. Извлечение признаков формы от простого эскиза до сложного изображения человека.
Как показано на рисунке 2, процесс извлечения объектов в компьютерном зрении включает несколько этапов: (а) преобразование экземпляров объектов в черно-белое изображение, (б) корректировка размеров объектов на основе масштабного коэффициента, (в) применение прозрачности или цветовых комбинаций к определенным элементам и (г) масштабирование и изменение положения объектов, что часто приводит к изменению их внешнего вида по сравнению с исходной формой. Пиксели играют решающую роль в определении резкости объекта на изображении, поэтому оптимизация пикселей необходима для таких задач, как обнаружение, сегментация и распознавание объектов.
В методах, основанных на определении границ, детектор краев используется для идентификации границ объектов путем обнаружения быстрых изменений интенсивности вдоль краев областей. Для сегментации по цвету это обнаружение выполняется для каждого цветового канала RGB, создавая края, которые можно объединить для формирования окончательного изображения краев. Методы, основанные на локальном анализе, с другой стороны, группируют пиксели в соответствии с критериями однородности, например, в методах роста областей и разделения и слияния. В методе роста областей пиксели расширяются от центральных точек в большие области, если они имеют схожие характеристики, такие как цвет или значения серого. Методы разделения и слияния начинаются с разделения изображения на более мелкие области, которые затем объединяются на основе определенных критериев. Несмотря на свою полезность, эти методы, основанные на определении областей, имеют два основных ограничения: (1) они сильно зависят от исходных глобальных критериев, что влияет на рост областей, и (2) процесс зависит от исходных сегментов и исходных значений пикселей, что влияет на эффективность обнаружения объектов. Само обнаружение объектов используется для поиска и идентификации объектов как в записанных, так и в реальных наборах данных, но часто имеет погрешность, когда объекты
Отклонение от шаблона, заданного алгоритмом. Для повышения точности часто используются дополнительные алгоритмы для обнаружения более мелких деталей. Например, при распознавании лиц алгоритмы используются для идентификации элементов лица с более низким разрешением, таких как глаза, брови и рот, что повышает точность машинного распознавания. Однако периферийные элементы, такие как уши и шея, изучаются менее подробно, что подчеркивает избирательный подход к обработке распознавания лиц.
Растровое изображение (или растровое изображение) — это формат изображения, представляющий изображение в виде набора пикселей на экране компьютера, при этом каждому пикселю присваивается определенный цвет. Растровые изображения широко используются в фотографиях и цифровых изображениях, но их качество ухудшается при увеличении. Если растровое изображение масштабируется, например, в четыре раза, сами пиксели увеличиваются, что приводит к размытому или пикселизированному изображению. Ключевые термины при работе с растровыми изображениями включают разрешение, которое обозначает количество пикселей в изображении, и глубину цвета, которая указывает диапазон цветов, которые может отображать каждый пиксель. Растровые изображения часто создаются с помощью сканеров, цифровых камер или устройств видеозахвата и подвержены различным видам шума. Для решения этой проблемы в качестве эталонов часто используются растровые шаблоны, которые стандартизированы и легко обрабатываются компьютерами. В отличие от них, необработанные растровые изображения могут содержать ошибки захвата, что приводит к неструктурированным значениям пикселей, которые неточно отражают реальную сцену.
Шум может проникать в растровое изображение несколькими способами, в зависимости от способа получения изображения. Например, при сканировании фотографии с пленки зернистость пленки может способствовать появлению шумовых пикселей, как и потенциальное повреждение пленки или помехи от самого сканера. При получении изображений непосредственно в цифровом формате шум может вноситься механизмами сбора данных, такими как ПЗС-детекторы, или посредством электронной передачи данных, что может ухудшить качество изображения. На рисунке 3 показаны некоторые примеры поиска изображений в больших открытых базах данных. Исследования в области обработки изображений направлены на разработку методов машинного обучения и вычислительных методов, способных распознавать закономерности во все более разнообразных объектах. Машинное обучение, которое пересекается с вычислительной статистикой, имеет важное значение в таких приложениях, как фильтрация спама, оптическое распознавание символов, поисковые системы и компьютерное зрение. Для уменьшения шума было разработано множество алгоритмов, таких как линейная фильтрация на основе гауссова распределения. Эти алгоритмы эффективно уменьшают зернистый шум путем усреднения значений пикселей в локальной области, что помогает уменьшить локальные вариации, вызванные шумом, в конечном итоге создавая более четкие и точные изображения.

Рисунок 3. Пример поиска изображений с использованием изображения-запроса из больших наборов данных PASCAL MTH, MSD и др.
Заключение и перспективы
В заключение отметим, что компьютерное зрение, основанное на обработке изображений и машинном обучении, значительно продвинуло многие технологические области, обеспечив сложный анализ и интерпретацию визуальных данных. Зародившись в обработке изображений, компьютерное зрение стало незаменимым в таких дисциплинах, как географическое дистанционное зондирование, робототехника, здравоохранение и спутниковая связь, где оно позволяет эффективно извлекать признаки и проводить прогнозный анализ.
Анализируя изображения и видео, исследователи могут изучать закономерности, выявлять модели поведения и делать прогнозы на основе данных, расширяя влияние компьютерного зрения как на индивидуальные, так и на экологические приложения.
В перспективе, дальнейшая интеграция машинного обучения и улучшенных алгоритмов обработки изображений будет способствовать дальнейшим инновациям в компьютерном зрении, повышая как точность, так и адаптивность. В здравоохранении оно предлагает многообещающие достижения в диагностике и мониторинге пациентов, а в автономных системах, таких как беспилотные автомобили, поддерживает навигацию и безопасность.
Экологические приложения, такие как мониторинг климата и реагирование на стихийные бедствия, также выиграют от улучшенных возможностей компьютерного зрения. По мере развития этой области будущие исследования, вероятно, будут направлены на решение таких задач, как повышение точности в различных условиях, обработка в реальном времени и снижение вычислительных требований ресурсоемких алгоритмов.
В сочетании с такими новыми технологиями, как дополненная реальность, Интернет вещей и периферийные вычисления, компьютерное зрение призвано стать основополагающим инструментом во многих отраслях, открывая новые возможности для понимания визуальной информации и принятия мер на её основе.
Литература
- Y. Wang, Y. Guo, R. Kumar, M. Swaminathan, Order Reduction Using Laguerre-FDTD with Embedded Neural Network, 2024 IEEE/MTT-S International Microwave Symposium-IMS 2024, IEEE, 2024, pp. 473-476.
- R. Li, S. Sun, M. Elhoseiny, P. Torr, OxfordTVG-HIC: Can Machine Make Humorous Captions from Images?, Proceedings of the IEEE/CVF International Conference on Computer Vision, 2023, pp. 20293-20303.
- X. Chen, K. He, W. Liu, X. Liu, Z.-J. Zha, T. Mei, CLaM: An Open-Source Library for Performance Evaluation of Text- driven Human Motion Generation, Proceedings of the 32nd ACM International Conference on Multimedia, 2024, pp. 11194-11197.
- X. Chen, W. Liu, X. Liu, Y. Zhang, T. Mei, A cross-modality and progressive person search system, Proceedings of the 28th ACM International Conference on Multimedia, 2020, pp. 4550-4552.
- X. Chen, X. Liu, K. Liu, W. Liu, T. Mei, A baseline framework for part-level action parsing and action recognition, arXiv preprint arXiv:2110.03368 (2021).
- X. Chen, X. Liu, W. Liu, K. Liu, D. Wu, Y. Zhang, T. Mei, Part-level Action Parsing via a Pose-guided Coarse-to-Fine Framework, 2022 IEEE International Symposium on Circuits and Systems (ISCAS), IEEE, 2022, pp. 419-423.
- M. Qu, X. Chen, W. Liu, A. Li, Y. Zhao, ChatVTG: Video Temporal Grounding via Chat with Video Dialogue Large Language Models, Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2024, pp. 1847- 1856.
- L. Yang, Z. Zhang, J. Han, B. Zeng, R. Li, P. Torr, W. Zhang, Semantic Score Distillation Sampling for Compositional Text- to-3D Generation, arXiv preprint arXiv:2410.09009 (2024).
- Z. Gui, S. Sun, R. Li, J. Yuan, Z. An, K. Roth, A. Prabhu, P. Torr, kNN-CLIP: Retrieval Enables Training-Free Segmentation on Continually Expanding Large Vocabularies, arXiv preprint arXiv:2404.09447 (2024).
- B. Wang, H. Duan, Y. Feng, X. Chen, Y. Fu, Z. Mo, X. Di, Can LLMs Understand Social Norms in Autonomous Driving Games?, arXiv preprint arXiv:2408.12680 (2024).
- H. Liu, X. Chen, X. Liu, X. Gu, W. Liu, AnimateAnywhere: Context-Controllable Human Video Generation with ID- Consistent One-shot Learning, Proceedings of the 5th International Workshop on Human-centric Multimedia Analysis, 2024, pp. 41-43.
- M. Yin, T. Li, H. Lei, Y. Hu, S. Rangan, Q. Zhu, Zero-Shot Wireless Indoor Navigation through Physics-Informed Reinforcement Learning, 2024 IEEE International Conference on Robotics and Automation (ICRA), IEEE, 2024, pp. 5111- 5118.
- K. Huang, X. Chen, X. Di, Q. Du, Dynamic driving and routing games for autonomous vehicles on networks: A mean field game approach, Transportation Research Part C: Emerging Technologies 128 (2021) 103189.
- J. Huo, H. Li, J. Roveda, S.F. Quan, A. Li, A Multi-task Deep Learning Algorithm for Sleep Stage Scoring and Sleep Arousal Detection, Authorea Preprints (2023).
- H. Guo, A.B. Tikhomirov, A. Mitchell, I.P.J. Alwayn, H. Zeng, K.C. Hewitt, Real-time assessment of liver fat content using a filter-based Raman system operating under ambient light through lock-in amplification, Biomedical Optics Express 13(10) (2022) 5231-5245.
- H. Guo, B.L. Gala-Lopez, I.P. Alwayn, K.C. Hewitt, Liver discard rate due to conservative estimations of steatosis: an inference-based approach, medRxiv (2023) 2023.12. 04.23299406.
- J. Huo, Machine Learning Application in Sleep Disorder Analysis, The University of Arizona, 2023.
- C. Ding, T. Yao, C. Wu, J. Ni, Deep Learning for Personalized Electrocardiogram Diagnosis: A Review, arXiv preprint arXiv:2409.07975 (2024).
- J. Huo, S.F. Quan, J. Roveda, A. Li, BASH-GN: a new machine learning–derived questionnaire for screening obstructive sleep apnea, Sleep and Breathing 27(2) (2023) 449-457.
- J. Yang, Research on the propagation model of COVID-19 based on virus dynamics, Second International Conference on Biological Engineering and Medical Science (ICBioMed 2022), SPIE, 2023, pp. 962-967.
- J. Yang, Predicting water quality through daily concentration of dissolved oxygen using improved artificial intelligence, Scientific Reports 13(1) (2023) 20370.
- J. Huo, Y. Wang, N. Wang, W. Gao, J. Zhou, Y. Cao, Data- driven design and optimization of ultra-tunable acoustic metamaterials, Smart Materials and Structures 32(5) (2023) 05LT01.
- Y. Guo, O.W. Bhatti, M. Swaminathan, Training Set Optimization with Uncertainty Quantification for Machine Learning Models of Electromagnetic Structures, 2022 IEEE Electrical Design of Advanced Packaging and Systems (EDAPS), IEEE, 2022, pp. 1-3.
- H. Guo, A.E. Stueck, J.B. Doppenberg, Y.S. Chae, A.B. Tikhomirov, H. Zeng, M.A. Engelse, B.L. Gala-Lopez, A. Mahadevan-Jansen, I.P. Alwayn, Evaluation of minimum-to-severe global and macrovesicular steatosis in human liver specimens: a portable ambient light-compatible spectroscopic probe, medRxiv (2023) 2023.12. 04.23299259.
- H. Guo, V.S. Zions, B.A. Law, K.C. Hewitt, Potential of Raman‐Reflectance Combination in Quantifying Liver Steatosis and Fat Droplet Size: Evidence From Monte Carlo Simulations and Phantom Studies, Journal of Biophotonics (2024) e202400156.
- H. Guo, A.E. Stueck, J.B. Doppenberg, Y.S. Chae, A.B. Tikhomirov, H. Zeng, B.L. Gala-Lopez, A. Mahadevan-Jansen, M.A. Engelse, I.P. Alwayn, Assessment of liver steatosis using an ambient light-compatible Raman system: enhancing specificity with supplementary reflectance information, Biomedical Vibrational Spectroscopy 2024: Advances in Research and Industry, SPIE, 2024, p. PC128390B.
- H. Guo, A.E. Stueck, A.B. Tikhomirov, H. Zeng, I.P. Alwayn, B.L. Gala-Lopez, A. Mahadevan-Jansen, A.K. Locke, K.C. Hewitt, Evaluation of Steatosis in Human Liver Specimens Using an Ambient Light-compatible Raman Spectroscopy Approach, Bio-Optics: Design and Application, Optica Publishing Group, 2023, p. JTu4B. 26.
- H. Guo, A.E. Stueck, J.B. Doppenberg, Y.S. Chae, A.B. Tikhomirov, H. Zeng, M.A. Engelse, B.L. Gala‐Lopez, A. Mahadevan‐Jansen, I.P. Alwayn, Evaluation of Minimum‐To‐ Severe Global and Macrovesicular Steatosis in Human Liver Specimens: A Portable Ambient Light‐Compatible Spectroscopic Probe, Journal of Biophotonics (2023) e202400292.
- Z. Shou, X. Chen, Y. Fu, X. Di, Multi-agent reinforcement learning for Markov routing games: A new modeling paradigm for dynamic traffic assignment, Transportation Research Part C: Emerging Technologies 137 (2022) 103560.
- S. Liu, Y. Wang, X. Chen, Y. Fu, X. Di, SMART-eFlo: An integrated SUMO-gym framework for multi-agent reinforcement learning in electric fleet management problem, 2022 IEEE 25th International Conference on Intelligent Transportation Systems (ITSC), IEEE, 2022, pp. 3026-3031.
- X. Chen, S. Liu, X. Di, A hybrid framework of reinforcement learning and physics-informed deep learning for spatiotemporal mean field games, In Proceedings of the 20th International Conference on Autonomous Agents and Multiagent Systems, ACM DIgital Library, 2023.
- F. Zhou, C. Zhang, X. Chen, X. Di, Graphon Mean Field Games with A Representative Player: Analysis and Learning Algorithm, arXiv preprint arXiv:2405.08005 (2024).
- X. Chen, S. Liu, X. Di, Learning Dual Mean Field Games on Graphs, ECAI, 2023, pp. 421-428.
- S. Liu, X. Chen, X. Di, Scalable Learning for Spatiotemporal Mean Field Games Using Physics-Informed Neural Operator, Mathematics 12(6) (2024) 803.
- X. Chen, Z. Li, X. Di, Social learning in Markov games: Empowering autonomous driving, 2022 IEEE Intelligent Vehicles Symposium (IV), IEEE, 2022, pp. 478-483.
- X. Chen, X. Di, Z. Li, Social Learning for Sequential Driving Dilemmas, Games 14(3) (2023) 41.
- Z. Hu, Y. Sun, Y. Yang, Switch to generalize: Domain-switch learning for cross-domain few-shot classification, International Conference on Learning Representations, 2022.
- Z. Hu, Y. Sun, Y. Yang, Suppressing the heterogeneity: A strong feature extractor for few-shot segmentation, The Eleventh International Conference on Learning Representations, 2023.
- X. Chen, X. Liu, W. Liu, X.-P. Zhang, Y. Zhang, T. Mei, Explainable person re-identification with attribute-guided metric distillation, Proceedings of the IEEE/CVF international conference on computer vision, 2021, pp. 11813-11822.
- Z. Hu, Y. Sun, Y. Yang, J. Zhou, Divide-and-regroup clustering for domain adaptive person re-identification, Proceedings of the AAAI Conference on Artificial Intelligence, 2022, pp. 980-988.
- X. Chen, W. Liu, X. Liu, Y. Zhang, J. Han, T. Mei, MAPLE: Masked pseudo-labeling autoencoder for semi-supervised point cloud action recognition, Proceedings of the 30th ACM International Conference on Multimedia, 2022, pp. 708-718.
- Z. Hu, Y. Sun, J. Wang, Y. Yang, DAC-DETR: Divide the attention layers and conquer, Advances in Neural Information Processing Systems 36 (2024).
- X. Chen, W. Liu, Q. Bao, X. Liu, Q. Yang, R. Dai, T. Mei, Motion Capture from Inertial and Vision Sensors, arXiv preprint arXiv:2407.16341 (2024).
- Z. Hu, J. Ye, Y. Zhang, X. Wang, Seeing is Not Always Believing: An Empirical Analysis of Fake Evidence Generators, 2024 IEEE 9th European Symposium on Security and Privacy (EuroS&P), IEEE, 2024, pp. 560-579.
- Y. Zhang, Z. Hu, X. Wang, Y. Hong, Y. Nan, X. Wang, J. Cheng, L. Xing, Navigating the Privacy Compliance Maze: Understanding Risks with {Privacy-Configurable} Mobile {SDKs}, 33rd USENIX Security Symposium (USENIX Security 24), 2024, pp. 6543-6560.
- M. Yin, Data security and privacy preservation in big data age, 2nd International Conference on Mechatronics Engineering and Information Technology (ICMEIT 2017), Atlantis Press, 2017, pp. 387-391.
- M. Yin, A.K. Veldanda, A. Trivedi, J. Zhang, K. Pfeiffer, Y. Hu, S. Garg, E. Erkip, L. Righetti, S. Rangan, Millimeter wave wireless assisted robot navigation with link state classification, IEEE Open Journal of the Communications Society 3 (2022) 493-507.
- V. Semkin, M. Yin, Y. Hu, M. Mezzavilla, S. Rangan, Drone detection and classification based on radar cross section signatures, 2020 International Symposium on Antennas and Propagation (ISAP), IEEE, 2021, pp. 223-224.
- M. Yin, Millimeter Wave Wireless Assisted Indoor Robot Navigation, New York University Tandon School of Engineering, 2024.
- K. Pfeiffer, Y. Jia, M. Yin, A.K. Veldanda, Y. Hu, A. Trivedi, J. Zhang, S. Garg, E. Erkip, S. Rangan, Path planning under uncertainty to localize mmWave sources, 2023 IEEE International Conference on Robotics and Automation (ICRA), IEEE, 2023, pp. 3461-3467.
- Y. Hu, M. Yin, W. Xia, S. Rangan, M. Mezzavilla, Multi- frequency channel modeling for millimeter wave and thz wireless communication via generative adversarial networks, 2022 56th Asilomar Conference on Signals, Systems, and Computers, IEEE, 2022, pp. 670-676.
- S. Cao, J. Xiao, Human-Robot Complementary Collaboration for Flexible and Precision Assembly, 2024 IEEE International Conference on Robotics and Automation (ICRA), IEEE, 2024, pp. 12971-12977.
- T. Kosch, J. Karolus, J. Zagermann, H. Reiterer, A. Schmidt, P.W. Woźniak, A survey on measuring cognitive workload in human-computer interaction, ACM Computing Surveys 55(13s) (2023) 1-39.
- L. Liu, W. Ouyang, X. Wang, P. Fieguth, J. Chen, X. Liu, M. Pietikäinen, Deep learning for generic object detection: A survey, International journal of computer vision 128 (2020) 261-318.
- E. Imani, G. Zhang, R. Li, J. Luo, P. Poupart, P.H. Torr, Y. Pan, Label Alignment Regularization for Distribution Shift, Journal of Machine Learning Research 25(247) (2024) 1-32.
- Y. Guo, X. Li, M. Swaminathan, 2D spectral transposed convolutional neural network for S-parameter predictions, 2022 IEEE 31st Conference on Electrical Performance of Electronic Packaging and Systems (EPEPS), IEEE, 2022, pp. 1-3.
- M. Swaminathan, O.W. Bhatti, Y. Guo, E. Huang, O. Akinwande, Bayesian learning for uncertainty quantification, optimization, and inverse design, IEEE Transactions on Microwave Theory and Techniques 70(11) (2022) 4620-4634.
- Y. Fu, A. Jain, X. Di, X. Chen, Z. Mo, DriveGenVLM: Real- world Video Generation for Vision Language Model based Autonomous Driving, arXiv preprint arXiv:2408.16647 (2024).
- X. Chen, F. Yongjie, S. Liu, X. Di, Physics-informed neural operator for coupled forward-backward partial differential equations, 1st Workshop on the Synergy of Scientific and Machine Learning Modeling@ ICML2023, 2023.
- S. Sun, R. Li, P. Torr, X. Gu, S. Li, Clip as rnn: Segment countless visual concepts without training endeavor, Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2024, pp. 13171-13182.
Авторы: Wen Gendy, Dularia Patel