Автоматизированный визуальный осмотр фармацевтических таблеток приобретает все большее значение для выявления производственных дефектов и поддержания стабильного качества продукции. Однако прогресс в классификации дефектов на основе искусственного интеллекта ограничен дефицитом общедоступных наборов данных изображений, охватывающих дефектные таблетки в различных визуальных условиях. В этом исследовании представлен набор данных PharmaVision (PV), общедоступный визуальный набор данных и эталон для классификации нормальных и дефектных прессованных таблеток.
Методы: Набор данных PV содержит 640 изображений, полученных с помощью смартфонов, охватывающих различные виды таблеток, фоны и освещение, с фиксированным разделением на уровне таблеток (190/190 обучающих, 30/30 валидационных и 100/100 тестовых изображений для нормальных и дефектных классов соответственно). Двенадцать репрезентативных архитектур, охватывающих классические сверточные сети, мобильные сети и Vision Transformers, были протестированы по идентичному протоколу с использованием показателей точности, прецизии, полноты и гармонического среднего точности и полноты (F1-мера) с 95% доверительными интервалами и парными статистическими тестами. Обобщение результатов на разных наборах данных оценивалось на независимом наборе данных pillQC без тонкой настройки, а эффективность анализировалась с использованием параметров, операций с плавающей запятой в гигабитах (GFLOPs), задержки и пропускной способности.
Результаты: EfficientNetV2-S достиг наивысшего показателя F1-меры на тестовом наборе PV (88,56%), хотя парные статистические тесты не позволили отличить его от Xception (87,08%) или Swin-B (85,71%). На pillQC GoogLeNet и EfficientNetV2-S показали наилучшие результаты на разных наборах данных, в то время как производительность обоих графических трансформеров снизилась по сравнению с результатами в своей области. AlexNet обеспечил самую высокую теоретическую пропускную способность (602,41 кадров в секунду (FPS), медианная задержка 1,66 мс), в то время как ShuffleNetV2 и MobileNetV3-small предложили наименьшее количество параметров.
Выводы: Точность в рамках предметной области, устойчивость к различным наборам данных и измеренная задержка различаются, при этом ни одна архитектура не является лучшей по всем трем параметрам. Набор данных PV, код и протокол оценки общедоступны на GitHub для поддержки воспроизводимого контроля качества планшетов на основе ИИ.
1. Введение
Фармацевтическая промышленность постоянно внедряет передовые технологии производства и стратегии контроля качества для обеспечения выпуска безопасных, эффективных и стабильных лекарственных средств. Визуальный осмотр твердых пероральных лекарственных форм является устоявшимся элементом надлежащей производственной практики, а внешний вид таблетки – это определенный качественный признак, а не косметическая проблема: видимое отклонение является внешним признаком отклонения от основного процесса и может сопровождаться изменением целостности дозы. Таблетки могут приобретать широкий спектр визуальных и структурных дефектов во время производства, обработки и упаковки, включая сколы, трещины, отслоение, ламинирование, пятнистость, изменение цвета, черные или посторонние пятна, неполную или неправильную печать, отсутствие или нечеткость оттисков, неравномерное покрытие, отслоение покрытия, шероховатость поверхности, деформацию, сломанные края и неправильный размер или форму [1, 2]. Они возникают из-за вариаций свойств сырья и гранул, текучести порошка, условий прессования, характеристик оснастки, параметров процесса нанесения покрытия, условий окружающей среды и механических напряжений, возникающих во время производства и последующей обработки [3]. Поэтому надежное выявление таких отклонений до того, как лекарственные средства попадут к пациентам, является важным компонентом обеспечения качества фармацевтической продукции.
На фармацевтических производственных предприятиях контроль качества таблеток по-прежнему зависит от ручного визуального осмотра, который является трудоемким, требует больших затрат труда, субъективен и подвержен усталости человека, особенно когда необходимо проверить тысячи таблеток за ограниченный период времени. Инспекторы могут по-разному интерпретировать приемлемые и дефектные таблетки, а мелкие или едва заметные дефекты могут быть упущены из виду. Масштабы современного непрерывного производства стимулировали интерес к 100% визуальному контролю таблеток, производимых методом прямого прессования и нанесения покрытия [4], объему, при котором ручной осмотр уже нецелесообразен. Для уменьшения этой вариативности были внедрены системы машинного зрения, основанные на правилах: ранние работы касались сегментации таблеток в реальном времени [5] и автоматической оценки качества оттисков [6]. Эти системы хорошо работают при контролируемом освещении и фиксированной геометрии, для которых они настроены, но их зависимость от вручную настроенных характеристик и пороговых значений ограничивает их способность к обобщению на различные формы таблеток, цвета, оттиски, ориентации, фон изображения и внешний вид дефектов.
Глубокое обучение стало многообещающей альтернативой, поскольку оно изучает дискриминантные признаки изображения непосредственно из данных, а не из правил, созданных вручную [7]. Его эффективность хорошо подтверждена в промышленной инспекции дефектов поверхности, где общедоступные эталонные показатели сделали конкурирующие методы напрямую сопоставимыми, а также в смежных областях визуальной инспекции, таких как анализ медицинских изображений [8]. Несколько исследований применили глубокое обучение специально к визуальной инспекции фармацевтической продукции [9, 10, 11, 12, 13]. Куан и др. использовали изображения с многокамерной системы фармацевтической инспекции для обучения классификатора глубокого обучения, который различал качественные и дефектные таблетки с помощью трансферного обучения, демонстрируя осуществимость на изображениях, полученных в промышленности, которые не были опубликованы в качестве открытого эталонного показателя [14]. Рачки и др. предложили компактную архитектуру на основе сверточной нейронной сети (CNN) для сегментации и оценки дефектов поверхности твердых пероральных лекарственных форм, оцененную на сложных реальных данных инспекции и показавшую поддержку работы в реальном времени [15]. Фицере и др. объединение машинного зрения с глубоким обучением для одновременного измерения толщины покрытия и распознавания дефектов на таблетках с пленочным покрытием [16]. Во всех этих исследованиях глубокая архитектура неизменно превосходит более ранние подходы, созданные вручную, но каждый из них был разработан и проверен на отдельном, не выпущенном наборе данных со своей собственной системой визуализации и таксономией дефектов, поэтому ни одна из заявленных точности не может быть независимо проверена или сравнена на общей основе.
Несмотря на эти достижения, общедоступные и воспроизводимые наборы данных для классификации нормальных и дефектных прессованных фармацевтических таблеток по-прежнему встречаются редко. Один из таких общедоступных ресурсов, pillQC, предоставляет изображения нормальных таблеток и таблеток со сколами и загрязнениями. Однако набор данных был получен для одного конкретного таблеточного продукта при фиксированной и контролируемой конфигурации съемки. Поэтому его нельзя использовать для оценки того, обобщается ли полученное представление на различные формы таблеток, цвета, оттиски, фон, условия освещения или устройства захвата, — именно та изменчивость, с которой система контроля сталкивается на практике. В настоящее время ни один общедоступный ресурс не поддерживает обучение и сравнение классификаторов дефектов прессованных таблеток в таких разнообразных условиях съемки в рамках фиксированного, опубликованного протокола.
Данное исследование восполняет этот пробел, разрабатывая и тестируя основу системы контроля качества прессованных фармацевтических таблеток на основе искусственного интеллекта: систему, которая анализирует фотографию отдельной таблетки, обрезанную по области таблетки, и определяет, является ли она визуально нормальной или имеет видимый физический дефект. Такая система призвана поддерживать, а не заменять, суждения квалифицированного персонала по обеспечению и контролю качества. С этой целью мы представляем набор данных PharmaVision (PV), общедоступный визуальный набор данных для бинарной классификации нормальных и дефектных прессованных таблеток. Набор данных PV объединяет таблетки, сфотографированные во время реального фармацевтического производства, с дополнительными дефектными таблетками, приготовленными в контролируемых условиях фармацевтами, чтобы расширить охват менее частых типов дефектов; метки отражают только визуальное состояние и не подтверждают химические, растворяющие или микробиологические характеристики. Мы проводим тестирование набора данных с использованием двенадцати архитектур глубокого обучения, чтобы установить базовый уровень для автоматической классификации нормальных и дефектных таблеток. Помимо оценки в рамках предметной области на тестовом наборе данных PV, модели, обученные исключительно на этом наборе данных, оцениваются без какой-либо адаптации или тонкой настройки на независимом наборе данных pillQC для оценки обобщающей способности между наборами данных. Каждая модель дополнительно профилируется с точки зрения обучаемых параметров, операций с плавающей запятой в гигабитах (GFLOPs), задержки вывода и пропускной способности. Основные результаты этой работы заключаются в следующем:
-
Мы предлагаем новый общедоступный набор данных, набор данных PV, включающий 640 изображений спрессованных фармацевтических таблеток, с фиксированными разбиениями на обучающую (190/190), валидационную (30/30) и тестовую (100/100) выборки для нормального и дефектного классов соответственно. Изображения были разделены на уровне исходной таблетки, что было проверено путем сопоставления изображений, так что ни одна физическая таблетка не встречается более чем в одном разбиении, а три разбиения были получены в отдельных сессиях с интервалом примерно в две недели. Состав набора данных документирован с точки зрения типов продукции, покрытия, формы, цвета и типов дефектов.
-
Набор данных протестирован на двенадцати архитектурах, охватывающих классические сверточные нейронные сети, сети, ориентированные на мобильные устройства, и графические трансформеры, обученные и оцененные по идентичному протоколу без настройки для каждой архитектуры, что обеспечивает будущим методам контроля качества планшетов общую точку отсчета для сравнения.
-
Для оценки обобщающей способности при работе с разными наборами данных каждая модель, обученная на наборе данных PV, оценивается без адаптации на независимом наборе данных pillQC, количественно определяя, насколько хорошо ее усвоенное представление переносится на таблетки, условия визуализации и типы дефектов за пределами исходного распределения.
-
Количество параметров, GFLOPs, задержка и пропускная способность сообщаются вместе с точностью, прецизией, полнотой и гармоническим средним точности и полноты (F1-мера) для каждой архитектуры, что позволяет оценить эффективность прогнозирования в соответствии с требованиями контроля в реальном времени. Кроме того, набор данных, расширенный обучающий набор и полный код обучения и оценки публикуются в открытом доступе [17], что позволяет проводить независимое переобучение и проверку представленных результатов в рамках того же протокола.
Дальнейшая структура статьи следующая: в разделе 2 описывается создание набора данных PV и экспериментальный протокол. В разделе 3 представлены результаты классификации на тестовом наборе данных PV, обобщение результатов на набор данных pillQC, статистический анализ этих результатов и вычислительная эффективность. В разделе 4 обсуждаются последствия и ограничения полученных результатов, а в разделе 5 подводятся итоги статьи.
2. Материалы и методы
2.1. PharmaVision: Набор данных для оценки качества таблеток
В данном исследовании представлен набор данных PharmaVision (PV), визуальный набор данных, разработанный для контроля качества фармацевтических таблеток на основе искусственного интеллекта. Набор данных предназначен для поддержки автоматизированной визуальной проверки отдельных прессованных таблеток с использованием методов глубокого обучения и для предоставления фиксированного, воспроизводимого эталона для классификации нормальных и дефектных таблеток. В данной работе дефектный класс рассматривался как положительный класс для расчета точности, полноты и F1-меры. Набор данных содержит 640 изображений, поровну разделенных между нормальными и дефектными классами, организованных в предопределенные обучающие, валидационные и тестовые подмножества. Репрезентативные примеры нормальных и дефектных таблеток представлены на рисунке 1, а полный рабочий процесс разработки набора данных проиллюстрирован на рисунке 2.
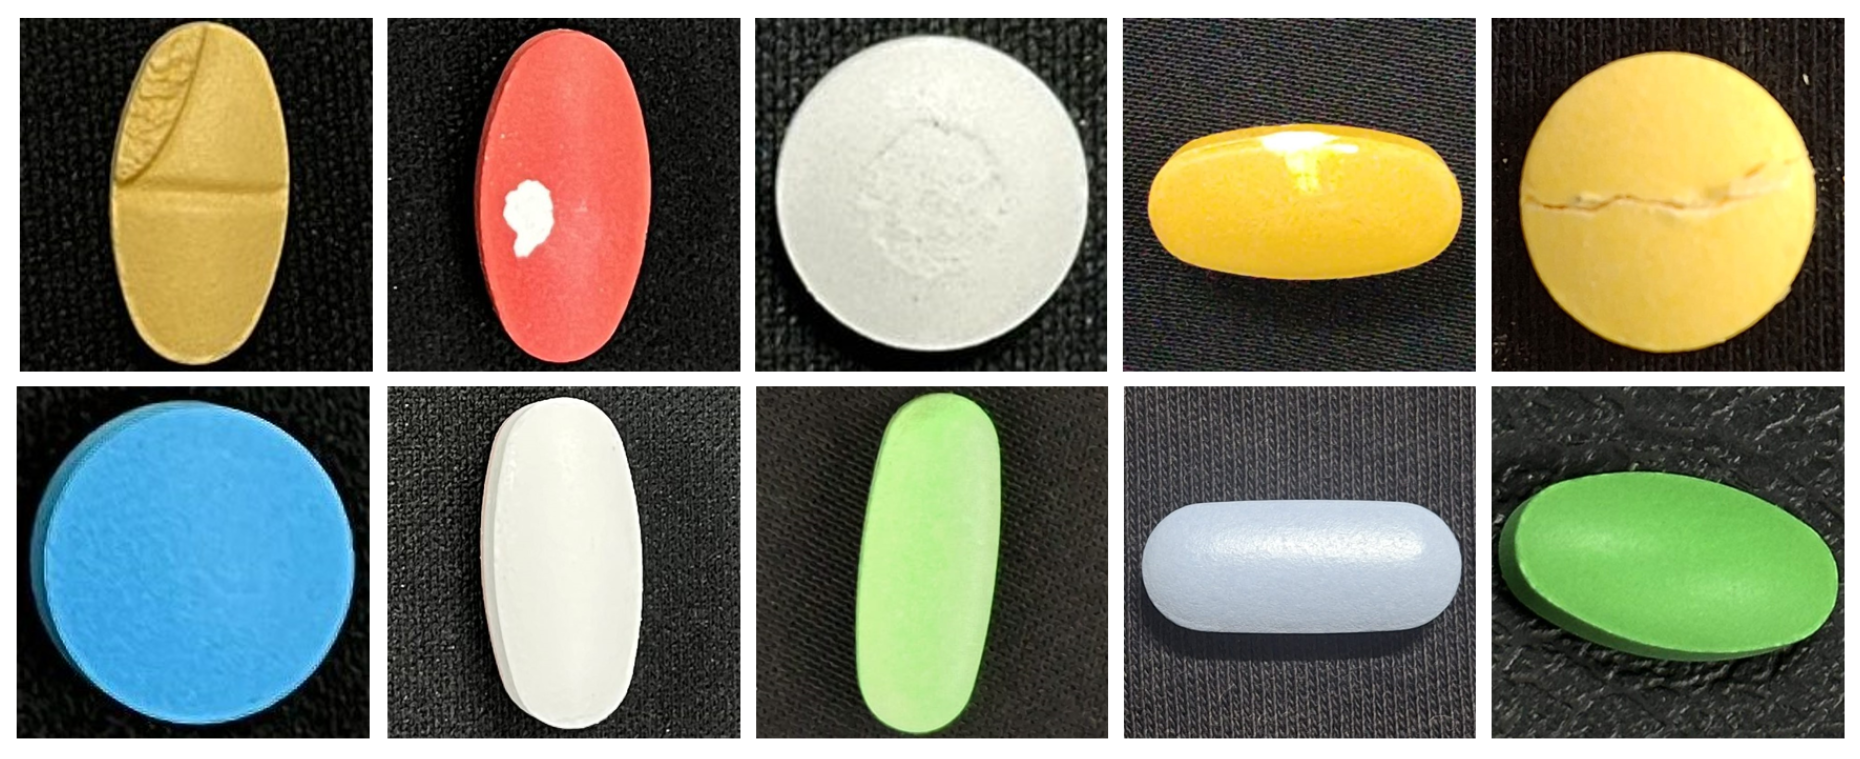
Рисунок 1. Репрезентативные образцы из предлагаемого набора данных, с изображениями дефектных таблеток в верхнем ряду и изображениями нормальных таблеток в нижнем ряду.
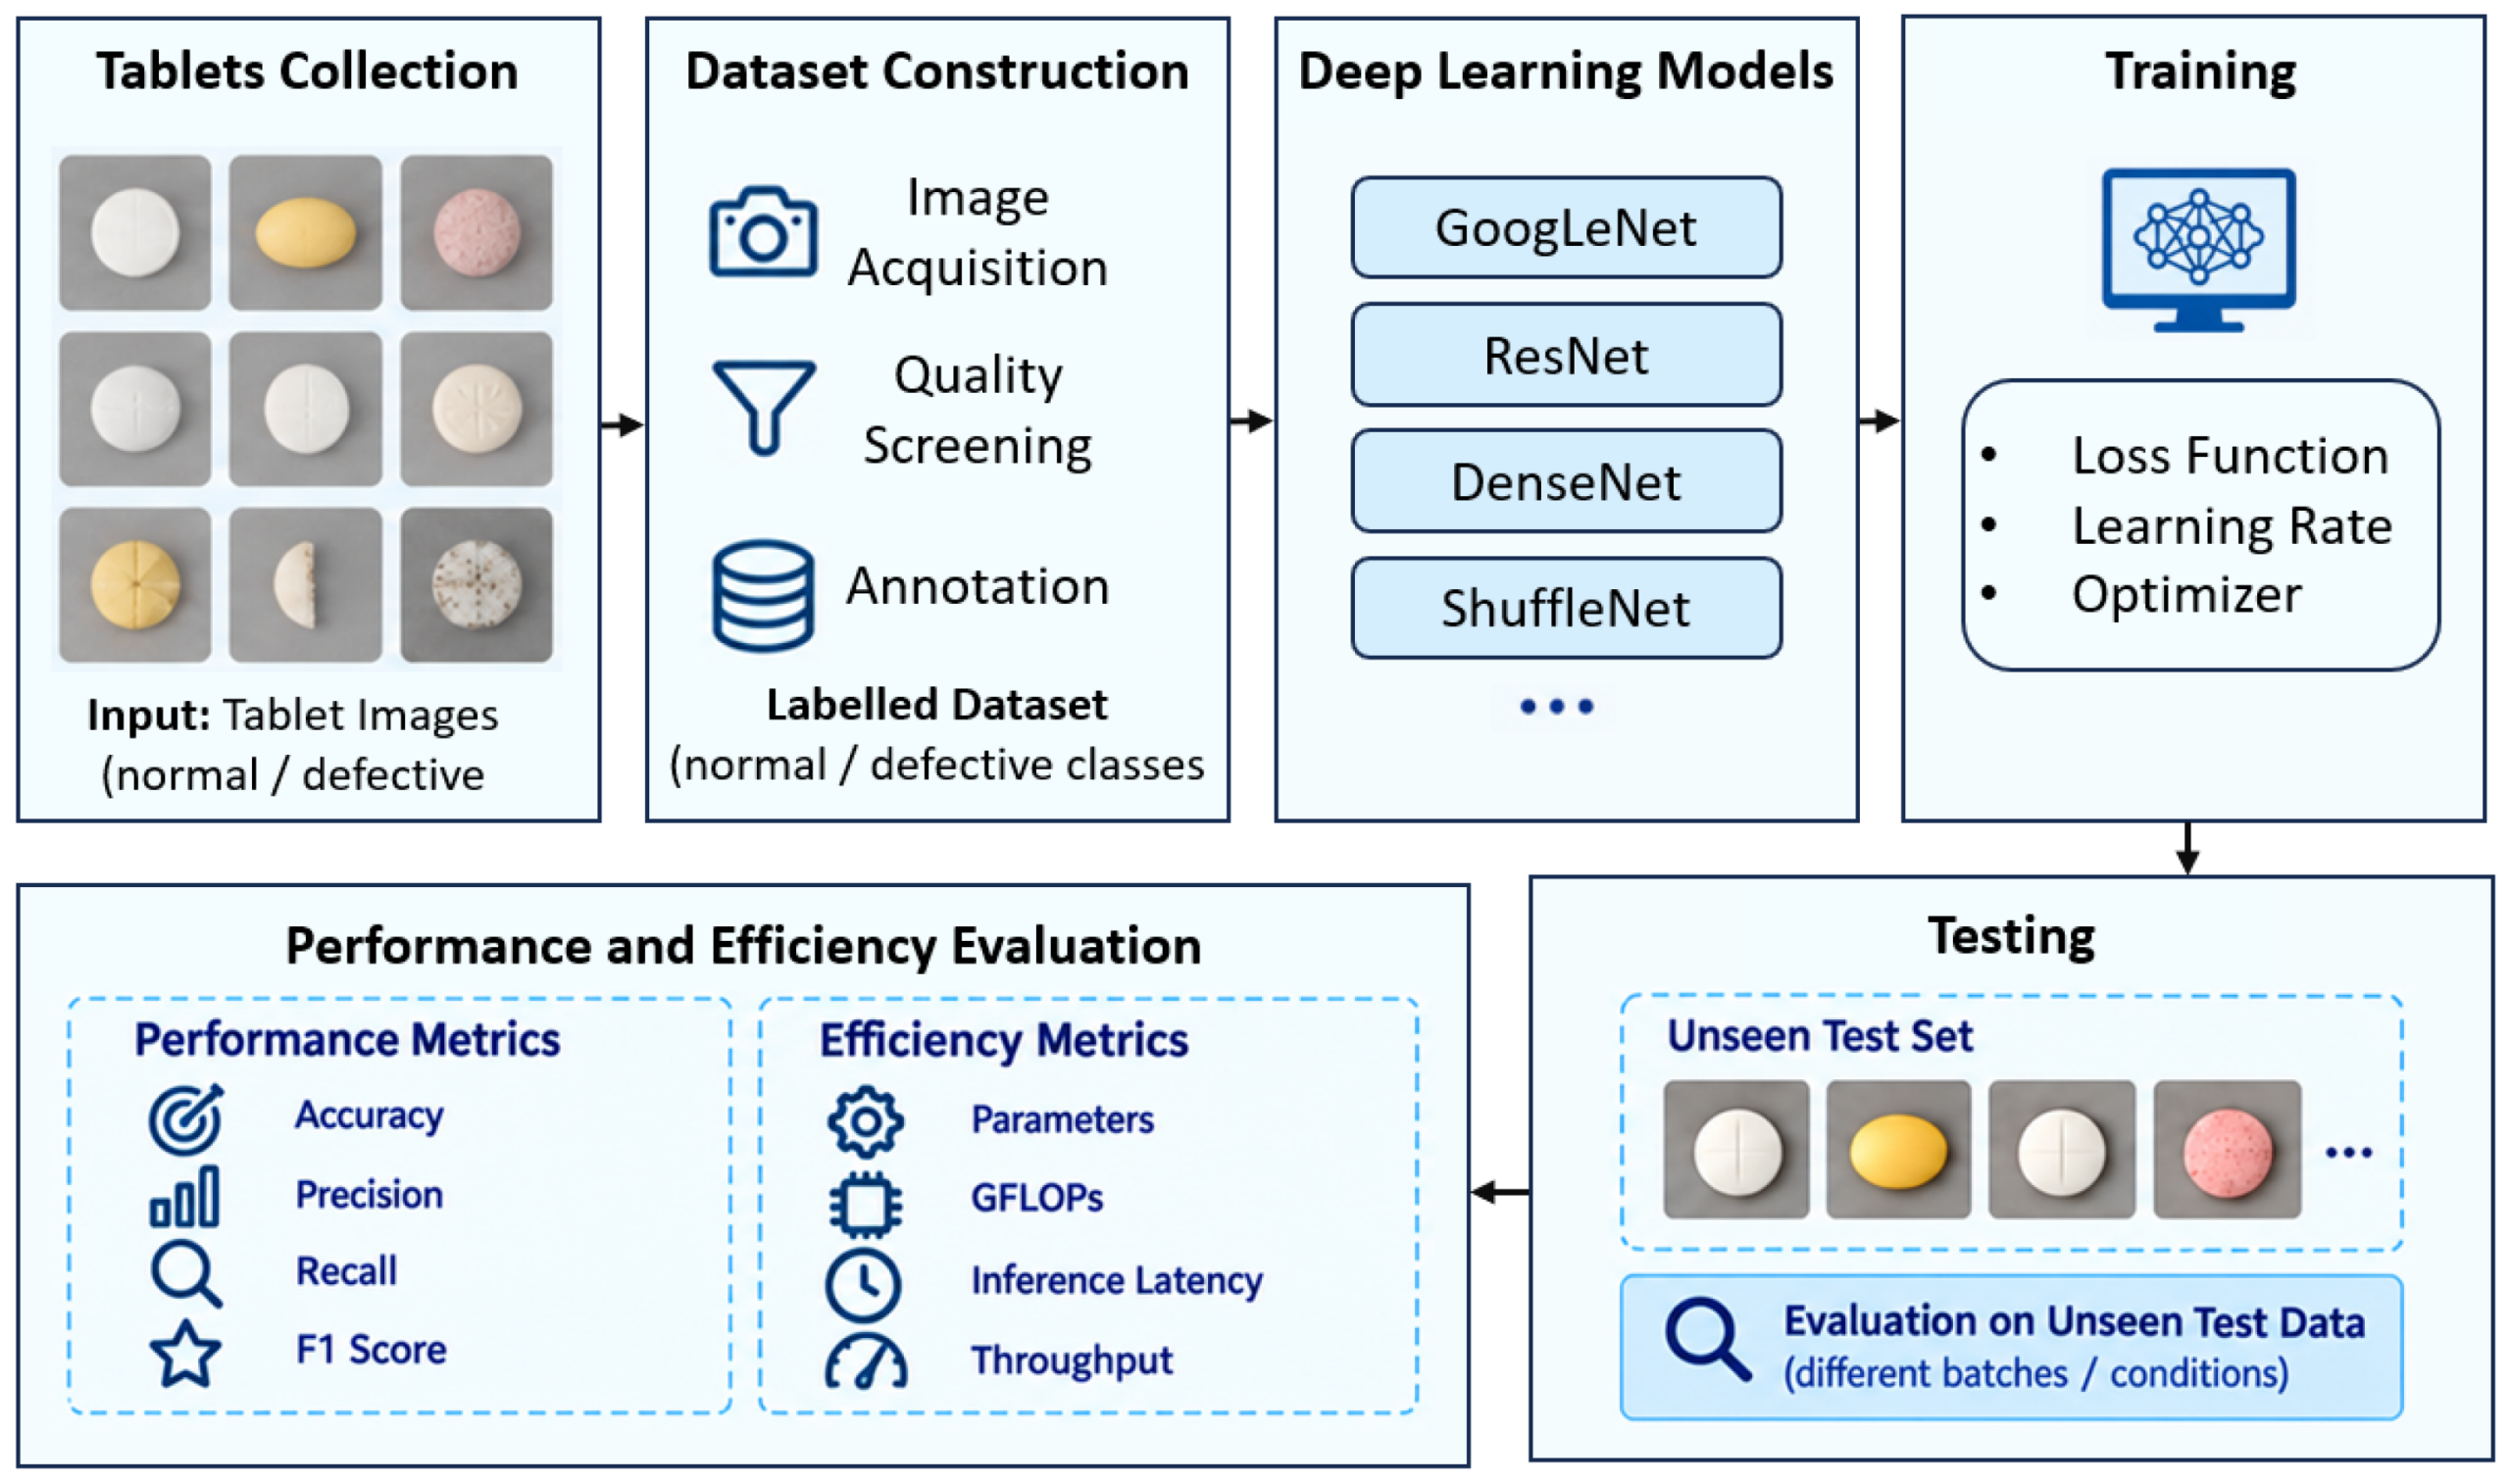
Рисунок 2. Обзор предлагаемой системы разработки набора данных и сравнительного анализа для автоматизированной классификации фармацевтических таблеток на нормальные и дефектные.
2.1.1. Разработка набора данных и получение изображений
Набор данных PV объединяет два взаимодополняющих источника изображений таблеток. Часть данных была собрана непосредственно в ходе реального производства фармацевтических таблеток, запечатлев естественные производственные дефекты вместе с нормальными таблетками из тех же партий. Для расширения охвата типов дефектов и увеличения количества дефектных образцов, доступных для обучения и оценки, были подготовлены дополнительные дефектные таблетки в контролируемых условиях, в которых фармацевты вручную наносили физические дефекты на нормальные таблетки. Такой комбинированный подход был призван сохранить визуальную реалистичность подлинных производственных дефектов, обеспечивая при этом достаточное представление менее часто встречающихся типов дефектов.
Все изображения были получены с помощью камер потребительских мобильных телефонов, а именно Samsung Galaxy A35 [18] и Samsung Galaxy A05 [19], а не специализированного промышленного оборудования для получения изображений. Этот выбор отражает условия съемки, которые легко достижимы на практике, и демонстрирует, что осмысленная проверка планшетов возможна без специального оборудования машинного зрения. Изображения были получены на приблизительном расстоянии от камеры до планшета около 30 см, без фиксированного приспособления или крепления, поэтому в наборе данных присутствуют незначительные вариации в кадрировании и расстоянии. Оба устройства использовались во всех трех разделах, поэтому ни одно разделение не связано с одной моделью камеры. Каждый планшет был сфотографирован индивидуально на разных фонах и при разных условиях освещения, что намеренно отражает диапазон визуальных условий, встречающихся в реальных производственных и контрольных средах, а не одну фиксированную установку для получения изображений.
После получения изображения каждое изображение вручную обрезалось до области, центрированной на планшете, таким образом, чтобы планшет занимал большую часть кадра, а посторонний фон был уменьшен. Все обрезки выполнялись одним и тем же оператором с использованием единой процедуры, применяемой идентично ко всем разделам и обоим классам. Обрезка не была скрыта от класса, поскольку класс каждого планшета был известен на момент получения изображения, но обрезка основывалась исключительно на положении планшета в кадре и не зависела от наличия дефектов. Около 80% обрезанных изображений имели квадратную форму; остальные, вытянутые планшеты, были прямоугольными (Таблица 1). Все изображения были уменьшены до размера 224 × 224 пикселей для обучения и оценки (Раздел 2.3).
2.1.2. Типы таблеток и категории дефектов
Каждому изображению в наборе данных PV была присвоена одна из двух меток. Нормальная таблетка обозначается как таблетка без визуально видимых дефектов. Дефектная таблетка обозначается как таблетка, имеющая одну или несколько визуально наблюдаемых физических, структурных, поверхностных, покрывающих или внешних аномалий. Такая бинарная структура была выбрана потому, что основная цель набора данных — поддержка автоматизированной сортировки таблеток на приемлемые и неприемлемые категории, что является начальным этапом принятия решения в практическом процессе контроля качества, после которого таблетки, помеченные как дефектные, направляются на дальнейшую проверку.
Набор данных содержит не более 550 уникальных физических таблеток из 91 визуально различающейся группы продуктов (таблица 1); некоторые таблетки были сфотографированы более одного раза, поэтому количество уникальных таблеток меньше, чем количество изображений. Группы продуктов определялись по внешнему виду таблеток (оттиск, цвет, форма и размер); группы без разборчивого оттиска могут объединять визуально неразличимые продукты. Продукты представляют собой лекарственные препараты под торговой маркой, поэтому информация о производителях не разглашается. Номера партий, составы, дозировки и производственные процессы не регистрировались. Представлены круглые (242 изображения), овальные (89) и капсуловидные (304) таблетки, а также четыре твердые капсулы и одна таблетка в форме сердца, в цветах от белого и кремового (247 изображений) до желтого, оранжевого, красного, коричневого, серого, синего и зеленого. Примерно две трети изображений показывают таблетки, покрытые пленочной оболочкой, и одна треть — таблетки без оболочки, многие из которых имеют разделительные линии, рельефные логотипы или буквенно-цифровые оттиски. Это различие, присутствующее как в полученных естественным путем, так и в подготовленных вручную частях набора данных, было преднамеренным, чтобы модели, обученные на наборе данных PV, научились различать дефектность, обусловленную естественными различиями во внешнем виде таблеток, а не одним фиксированным типом таблеток.
Таблица 1. Состав набора данных PV по разделам и классам (N: нормальные; D: дефектные). Значения представляют собой количество изображений, за исключением уникальных физических таблеток и групп продуктов. Уникальные физические таблетки являются верхними границами: изображения одной и той же таблетки были идентифицированы путем сопоставления изображений с визуальным подтверждением и подсчитаны один раз. Группы продуктов определялись по внешнему виду таблеток (оттиск, цвет, форма и размер); поскольку продукт может встречаться в нескольких столбцах, количество групп продуктов не суммируется по столбцам, а столбец «Итого» показывает количество различных групп. Покрытие оценивалось визуально.
| Характерный | Поезд N | Поезд D | Вал Н | Вал Д | Тест N | Тест D | Общий |
|---|---|---|---|---|---|---|---|
| Изображения | 190 | 190 | 30 | 30 | 100 | 100 | 640 |
| Уникальные физические планшеты | ≤158 | ≤140 | ≤28 | ≤29 | ≤96 | ≤99 | ≤550 |
| Группы товаров | 35 | 30 | 7 | 5 | 44 | 32 | 91 |
| Покрытие: пленочное покрытие | 111 | 144 | 24 | 25 | 48 | 65 | 417 |
| Покрытие: без покрытия | 76 | 46 | 4 | 5 | 51 | 35 | 217 |
| Покрытие: покрыто сахаром | 0 | 0 | 2 | 0 | 0 | 0 | 2 |
| Покрытие: твердая капсула | 3 | 0 | 0 | 0 | 1 | 0 | 4 |
| Форма: круглая | 103 | 48 | 6 | 5 | 47 | 33 | 242 |
| Форма: овальная | 12 | 17 | 12 | 18 | 14 | 16 | 89 |
| Форма: капсуловидная/капсулообразная | 72 | 125 | 12 | 7 | 38 | 50 | 304 |
| Форма: другая (твердая капсула, в форме сердца) | 3 | 0 | 0 | 0 | 1 | 1 | 5 |
| Цвет: белый/кремовый | 78 | 75 | 4 | 5 | 43 | 42 | 247 |
| Цвет: жёлтый | 22 | 17 | 0 | 0 | 16 | 23 | 78 |
| Цвет: оранжевый/персиковый | 23 | 34 | 0 | 0 | 17 | 21 | 95 |
| Цвет: красный/розовый/бордовый | 9 | 4 | 1 | 0 | 11 | 5 | 30 |
| Цвет: коричневый/оливковый | 22 | 3 | 0 | 0 | 4 | 9 | 38 |
| Цвет: серый/бежевый | 8 | 16 | 0 | 0 | 0 | 0 | 24 |
| Цвет: синий | 23 | 41 | 11 | 18 | 6 | 0 | 99 |
| Цвет: зеленый/бирюзовый | 3 | 0 | 14 | 7 | 3 | 0 | 27 |
| Цвет: двухцветный (капсула) | 2 | 0 | 0 | 0 | 0 | 0 | 2 |
| Оттиск: не виден | 115 | 98 | 24 | 16 | 39 | 50 | 342 |
| Оттиск: только линия для подсчета очков. | 8 | 7 | 1 | 2 | 13 | 19 | 50 |
| Оттиск: текст или логотип | 67 | 85 | 5 | 12 | 48 | 31 | 248 |
| Неквадратная культура | 43 | 53 | 4 | 6 | 9 | 16 | 131 |
К дефектам относятся сколы (111 изображений), трещины (59), сломанные таблетки с отсутствующими фрагментами (25), истирание поверхности или эрозия покрытия или оттиска (75), изменение цвета, пятнистость, крапинки или загрязнения (27), расслоение (3) и их комбинации (20) ( Таблица 2 ). Степень тяжести оценивалась как легкая (небольшой скол по краю, тонкая трещина или небольшое пятно, при этом контур таблетки остается неповрежденным, а поражено менее 5% видимой поверхности), умеренная (четко видимый скол, трещина, истирание или изменение цвета, изменяющие контур или затрагивающие около 5–20% поверхности) или тяжелая (сквозной перелом таблетки, отсутствующий фрагмент или поражение более 20% поверхности). Из 320 изображений дефектов 92 (28,8%) демонстрируют естественные производственные дефекты, а 228 (71,3%) дефектов были внесены вручную фармацевтами.
Эти дефекты встречаются как на обычных таблетках без покрытия, так и на таблетках с покрытием и нанесенным рисунком, поэтому модель должна научиться распознавать наличие дефекта независимо от цвета, формы или рисунка нанесения рисунка на таблетку. Не каждая дефектная таблетка имеет одинаковый тип или степень тяжести дефекта: на некоторых изображениях присутствует одна очевидная аномалия, например, сломанный край, в то время как на других одновременно наблюдается несколько видимых дефектов. Таким образом, категория дефектных таблеток представляет собой широкий класс визуальных нарушений качества, а не один механизм дефекта.
В данной версии все подобные отклонения объединены в единую метку дефекта для бинарной классификации. Следует понимать, что эта метка отражает только визуальную оценку качества: таблетка, помеченная как нормальная, визуально нормальна на полученном изображении, и эта метка не является подтверждением химического состава, однородности дозировки, растворимости, микробиологического качества или любого другого невизуального фармацевтического признака.
Таким образом, набор данных предназначен скорее как ресурс для визуальной классификации дефектов, чем как полный набор данных для сертификации фармацевтического качества. Различия по типам дефектов, зафиксированные во время получения изображения, публикуются вместе с бинарными метками и могут служить основой для будущих расширений в направлении многоклассового распознавания дефектов, локализации дефектов или сегментации.
Таблица 2. Характеристики дефектов класса по категориям: основной тип дефекта, степень тяжести и происхождение (естественное возникновение в процессе производства или ручное внесение фармацевтами). Критерии степени тяжести определены в разделе 2.1.2.
| Характеристика дефекта | Обучение ( n = 190) |
Вал ( n = 30) |
Тест ( n = 100) |
Всего ( n = 320) |
|---|---|---|---|---|
| Скол (отсутствие материала на краю или поверхности) | 67 | 18 | 26 | 111 |
| Трещина (линия излома, фрагмент не потерян) | 35 | 4 | 20 | 59 |
| Повреждено (отсутствует фрагмент или таблетка расколота) | 12 | 3 | 10 | 25 |
| Абразия (поверхностная эрозия или отпечаток) | 48 | 4 | 23 | 75 |
| Изменение цвета, пятнистость, крапинки или загрязнения | 16 | 0 | 11 | 27 |
| Разделение слоев/ламинирование | 2 | 0 | 1 | 3 |
| Множественные типы дефектов | 10 | 1 | 9 | 20 |
| Степень тяжести 1 — легкая | 43 | 13 | 19 | 75 |
| Степень тяжести 2 — умеренная | 115 | 13 | 64 | 192 |
| Тяжесть 3 — тяжелая | 32 | 4 | 17 | 53 |
| Происхождение: природного происхождения | 44 | 3 | 45 | 92 (28,8%) |
| Источник: введено вручную. | 146 | 27 | 55 | 228 (71,3%) |
2.1.3. Разнообразие изображений и условия получения снимков
Чтобы приблизительно воспроизвести диапазон условий, с которыми система контроля может столкнуться на практике, изображения были получены на разных фонах и при разных условиях освещения, а не в одной контролируемой конфигурации. Это разнообразие было введено намеренно как для изображений, полученных естественным путем в процессе производства, так и для изображений дефектов, подготовленных вручную, чтобы обеспечить обобщение за пределы конкретной среды съемки и снизить риск того, что модели будут обучаться специфическим для фона или освещения «ярлыкам», а не признакам, имеющим отношение к дефектам. В качестве фона использовались однотонный темный фон, поверхность с текстурой дерева и несколько однотонных фонов (включая фиолетовый, бирюзовый и зеленый), сфотографированные при соответствующем окружающем освещении каждой обстановки, а не в одной студийной конфигурации. Фоны и устройства были распределены по обоим классам, а не связаны с одной меткой. Обучение, проверка и тестирование проводились в отдельных сессиях с интервалом примерно в две недели. Последствия такой конструкции для контроля утечек описаны в разделе 2.1.5 .
2.1.4. Аннотирование набора данных и контроль качества
Процесс маркировки проходил в четыре этапа: первоначальная маркировка при получении данных, независимая слепая проверка, отбор и проверка качества, а также заключительная подтверждающая проверка. На первом этапе фармацевт, фотографировавший каждую таблетку, присваивал ей метку «нормальная» или «дефектная» на основе видимого состояния таблетки на момент съемки. Для дефектных таблеток, изготовленных вручную, эта метка фиксировала дефект, преднамеренно внесенный в процессе приготовления, и, следовательно, не являлась независимой визуальной оценкой; для таблеток, полученных в процессе производства, она отражала визуальную оценку имеющейся таблетки.
На втором этапе второй фармацевт, не присутствовавший при получении данных и не информированный о первой метке, а также о том, получена ли таблетка в процессе производства или из контролируемого производства, независимо присваивал метку «нормальная» или «дефектная» только на основании изображения. Разногласия разрешались путем взаимного обсуждения между двумя фармацевтами до достижения консенсуса; индивидуальные метки, присвоенные до достижения консенсуса, не сохранялись в виде отдельных записей.
На третьем этапе два исследователя в области искусственного интеллекта (ИИ) обрабатывали и систематизировали собранный набор данных и проверяли качество изображений перед публикацией. Изображения с неопределенными, неоднозначными или иными неясными визуальными характеристиками, включая снимки вне фокуса, недостаточную видимость таблеток и пограничные случаи, которые нельзя было с уверенностью отнести ни к одному из классов, были исключены из сравнительного анализа или возвращены для дополнительной проверки.
После проверки все изображения сравнивались попарно внутри групп продуктов с использованием сопоставления ключевых точек SIFT [20] с геометрической проверкой, за которой следовало визуальное подтверждение, для обнаружения одной и той же физической таблетки более чем в одном разделе; ни одна физическая таблетка не появляется более чем в одном разделе выпущенного набора данных.
На четвертом этапе скомпилированный набор данных был возвращен фармацевтам, которые подтвердили присвоенные метки на основе видимых характеристик качества таблеток на каждом изображении. Поскольку пограничные таблетки были удалены во время проверки качества, сообщаемые показатели следует понимать как относящиеся к однозначным случаям; показатели для визуально пограничных таблеток, которые представляют собой признанную трудность при ручной проверке, не характеризуются этим сравнительным анализом.
2.1.5. Разделение на обучающую, валидационную и тестовую выборки
Набор данных PV выпускается с фиксированными разделами для обучения, валидации и тестирования, что обеспечивает согласованную и воспроизводимую оценку в разных исследованиях. Набор данных содержит в общей сложности 640 изображений, его состав представлен в таблице 1, а распределение классов по разделам — в таблице 3.
Таблица 3. Распределение изображений нормальных и дефектных таблеток в наборе данных PharmaVision.
| Разделение набора данных | Обычные изображения | Дефектные изображения | Всего изображений |
|---|---|---|---|
| Тренировочный набор | 190 | 190 | 380 |
| Набор проверок | 30 | 30 | 60 |
| Тестовый набор | 100 | 100 | 200 |
| Общий | 320 | 320 | 640 |
Обучающий набор использовался для оптимизации параметров модели в процессе обучения; проверочный набор использовался в процессе разработки модели для ранней остановки и выбора контрольных точек; а тестовый набор был сохранен исключительно для окончательной оценки производительности. Все три подмножества сбалансированы по классам, что снижает риск того, что производительность классификации будет определяться преобладающим классом, и позволяет в равной степени уделять внимание правильному распознаванию нормальных и дефектных таблеток. Сбалансированное тестирование особенно полезно для оценки чувствительности к дефектным таблеткам, поскольку полнота распознавания дефектного класса напрямую отражает долю правильно идентифицированных дефектных изображений.
Разделение данных проводилось на уровне исходного планшета, а не путем случайного распределения отдельных изображений: все изображения, полученные с данного физического планшета или захваченные в рамках одной последовательности съемки, были отнесены ровно к одному разделу, так что ни один физический планшет не предоставляет изображения более чем для одного из обучающего, валидационного и тестового наборов. Поскольку три раздела были дополнительно получены в отдельных сессиях с интервалом примерно в две недели (раздел 2.1.3), такая схема предотвращает две связанные формы утечки: появление одного и того же планшета или экземпляра дефекта как в обучающем, так и в оценочном наборах, а также совместное использование условий съемки, специфичных для каждой сессии, при разделении данных. Одним из следствий разделения сессий является то, что тестовый набор отличается от обучающего набора не только по идентификатору планшета, но и по сессии съемки, поэтому производительность внутридоменного тестирования уже включает в себя определенную степень сдвига распределения на уровне сессии и должна интерпретироваться соответствующим образом. Порог принятия решения и критерий выбора контрольной точки, применяемые к этим разделам, описаны в разделе 2.3 .
2.1.6. Расширение данных
Для увеличения эффективного размера и визуального разнообразия обучающего набора данных к нему применялась исключительно автономная аугментация. Аугментация выполнялась в автономном режиме, генерируя и сохраняя новые файлы изображений до начала обучения, а не в режиме онлайн во время каждой итерации обучения, и никогда не применялась к наборам данных для валидации или тестирования, чтобы исключить загрязнение результатов оценки синтетически сгенерированными изображениями. Для каждого из 190 нормальных и 190 дефектных обучающих изображений, помимо неизмененного оригинала, были сгенерированы два дополненных варианта с использованием мягких геометрических и световых преобразований: случайное горизонтальное и вертикальное отражение, вращение на небольшой угол (±12°, при этом цвет заливки для открытых углов был взят из исходного изображения) и небольшое изменение яркости и контраста (±7%). Аугментация данных расширила обучающий набор с 380 до 1140 изображений, сохранив при этом исходный баланс классов 1:1, как показано в таблице 4. На рисунке 3 показаны репрезентативные примеры исходных обучающих изображений вместе с их дополненными вариантами.

Рисунок 3. Типичные примеры обучающих изображений до и после автономной аугментации данных, иллюстрирующие примененные преобразования отражения, вращения и яркости/контраста. (a) Исходные изображения; (b) и (c) аугментированные изображения, сгенерированные с использованием примененных преобразований.
Таблица 4. Состав обучающего набора данных до и после офлайн-аугментации данных.
| Набор данных | Обычные изображения | Дефектные изображения | Всего изображений |
|---|---|---|---|
| Оригинальный тренировочный набор | 190 | 190 | 380 |
| Расширение данных | 380 | 380 | 760 |
| Полный тренировочный набор | 570 | 570 | 1140 |
Методы аугментации, способные скрывать или фальсифицировать признаки дефектов, включая случайную обрезку, гауссовское размытие, гауссовский шум, вырезание или случайное стирание, а также изменение оттенка или насыщенности, были намеренно исключены из этого конвейера обработки данных. Дефекты таблеток в этом наборе данных часто имеют небольшие пространственные размеры (например, сколы по краям или тонкие трещины) или зависят от цвета (например, пятна или изменение цвета), и такие преобразования рискуют удалить или исказить сами визуальные признаки, которые классификатор обучен обнаруживать.
Горизонтальное и вертикальное отражение были сохранены, несмотря на создание зеркально отраженных отпечатков, которые не встречаются на физически изготовленных таблетках, поскольку ориентация таблетки на поверхности контроля произвольна, а интересующие дефекты сами по себе не зависят от ориентации; таким образом, преобразование точно сохраняет признаки дефектов, не позволяя полагаться на содержимое отпечатка как на признак класса. Поскольку отражение применялось одинаково к нормальным и дефектным изображениям, зеркально отраженные отпечатки встречаются в обоих классах и не могут служить специфическим для класса ярлыком; Тем не менее, будущие протоколы расширения для наборов данных с большим количеством отпечатков могут ограничивать переворачивание планшетов только планшетами без отпечатков или использовать расширение с учетом отпечатков. Расширенный обучающий набор данных публикуется вместе с исходным набором данных PV.
2.1.7. Межнаборная оценка на наборе данных PillQC
Чтобы оценить, насколько визуальные представления, полученные из набора данных PV, обобщаются за пределы его исходного распределения, каждая модель, обученная исключительно на обучающем наборе PV, была оценена без какой-либо тонкой настройки или адаптации на независимом наборе данных pillQC [21]. Веса модели, классификационная головка и порог принятия решения оставались фиксированными, а изображения pillQC пропускались через каждую обученную модель для получения прогнозов.
Поскольку pillQC не определяет официального разделения для оценки, использовался полный набор изображений в оцениваемых классах. Оценка была ограничена классами «чипсы» и «нормальные», включающими 43 чипа и 149 нормальных изображений. Класс «загрязнения» был исключен, поскольку он представляет собой отложенные посторонние частицы на поверхности таблетки, внешнее загрязнение, а не структурный или производственный дефект самой таблетки.
Класс «дефектные» в наборе данных PV состоит исключительно из внутренних структурных, поверхностных, покрывающих и внешних аномалий. Включение класса «загрязнения» в качестве положительного класса, следовательно, потребовало бы от моделей обобщения на качественное изменение того, что означает «дефектный», смешивая сдвиг в области внешнего вида со сдвигом в определении целевой метки. По этой причине оценка была ограничена классами «чип» и «нормальный», где концепция дефекта соответствует цели обучения PV. Поскольку класс «загрязнение» был исключен по концептуальным соображениям, анализ чувствительности, включающий загрязнение, объединил бы два разных определения положительного класса в рамках одной и той же оценки, поэтому он не проводился.
Этот протокол нулевой адаптации имитирует сценарий, в котором модель, обученная на одном наборе образцов таблеток и условиях визуализации, напрямую применяется к образцу таблетки, настройке камеры и внешнему виду дефекта, с которыми она не сталкивалась во время обучения. Это обеспечивает более строгую проверку обобщающей способности, чем оценка в рамках предметной области только на тестовом наборе PV. При интерпретации результатов следует отметить два свойства этого протокола.
Во-первых, баланс классов отличается от тестового набора PV (22,4% положительных результатов против 50%), и поскольку точность и F1-мера зависят от распространенности, часть любых изменений этих показателей между двумя наборами данных отражает разницу в базовой частоте, а не изменение дискриминационной способности. Во-вторых, пороговое значение решения было сохранено на уровне, полученном из набора PV, а не перекалибровано для pillQC, поэтому результаты характеризуют перенос с нулевой адаптацией и не представляют собой верхнюю границу достижимой производительности между наборами данных.
На рисунке 4 представлены репрезентативные изображения из набора данных pillQC, а в таблице 5 приведено структурированное сравнение наборов данных PV и pillQC.
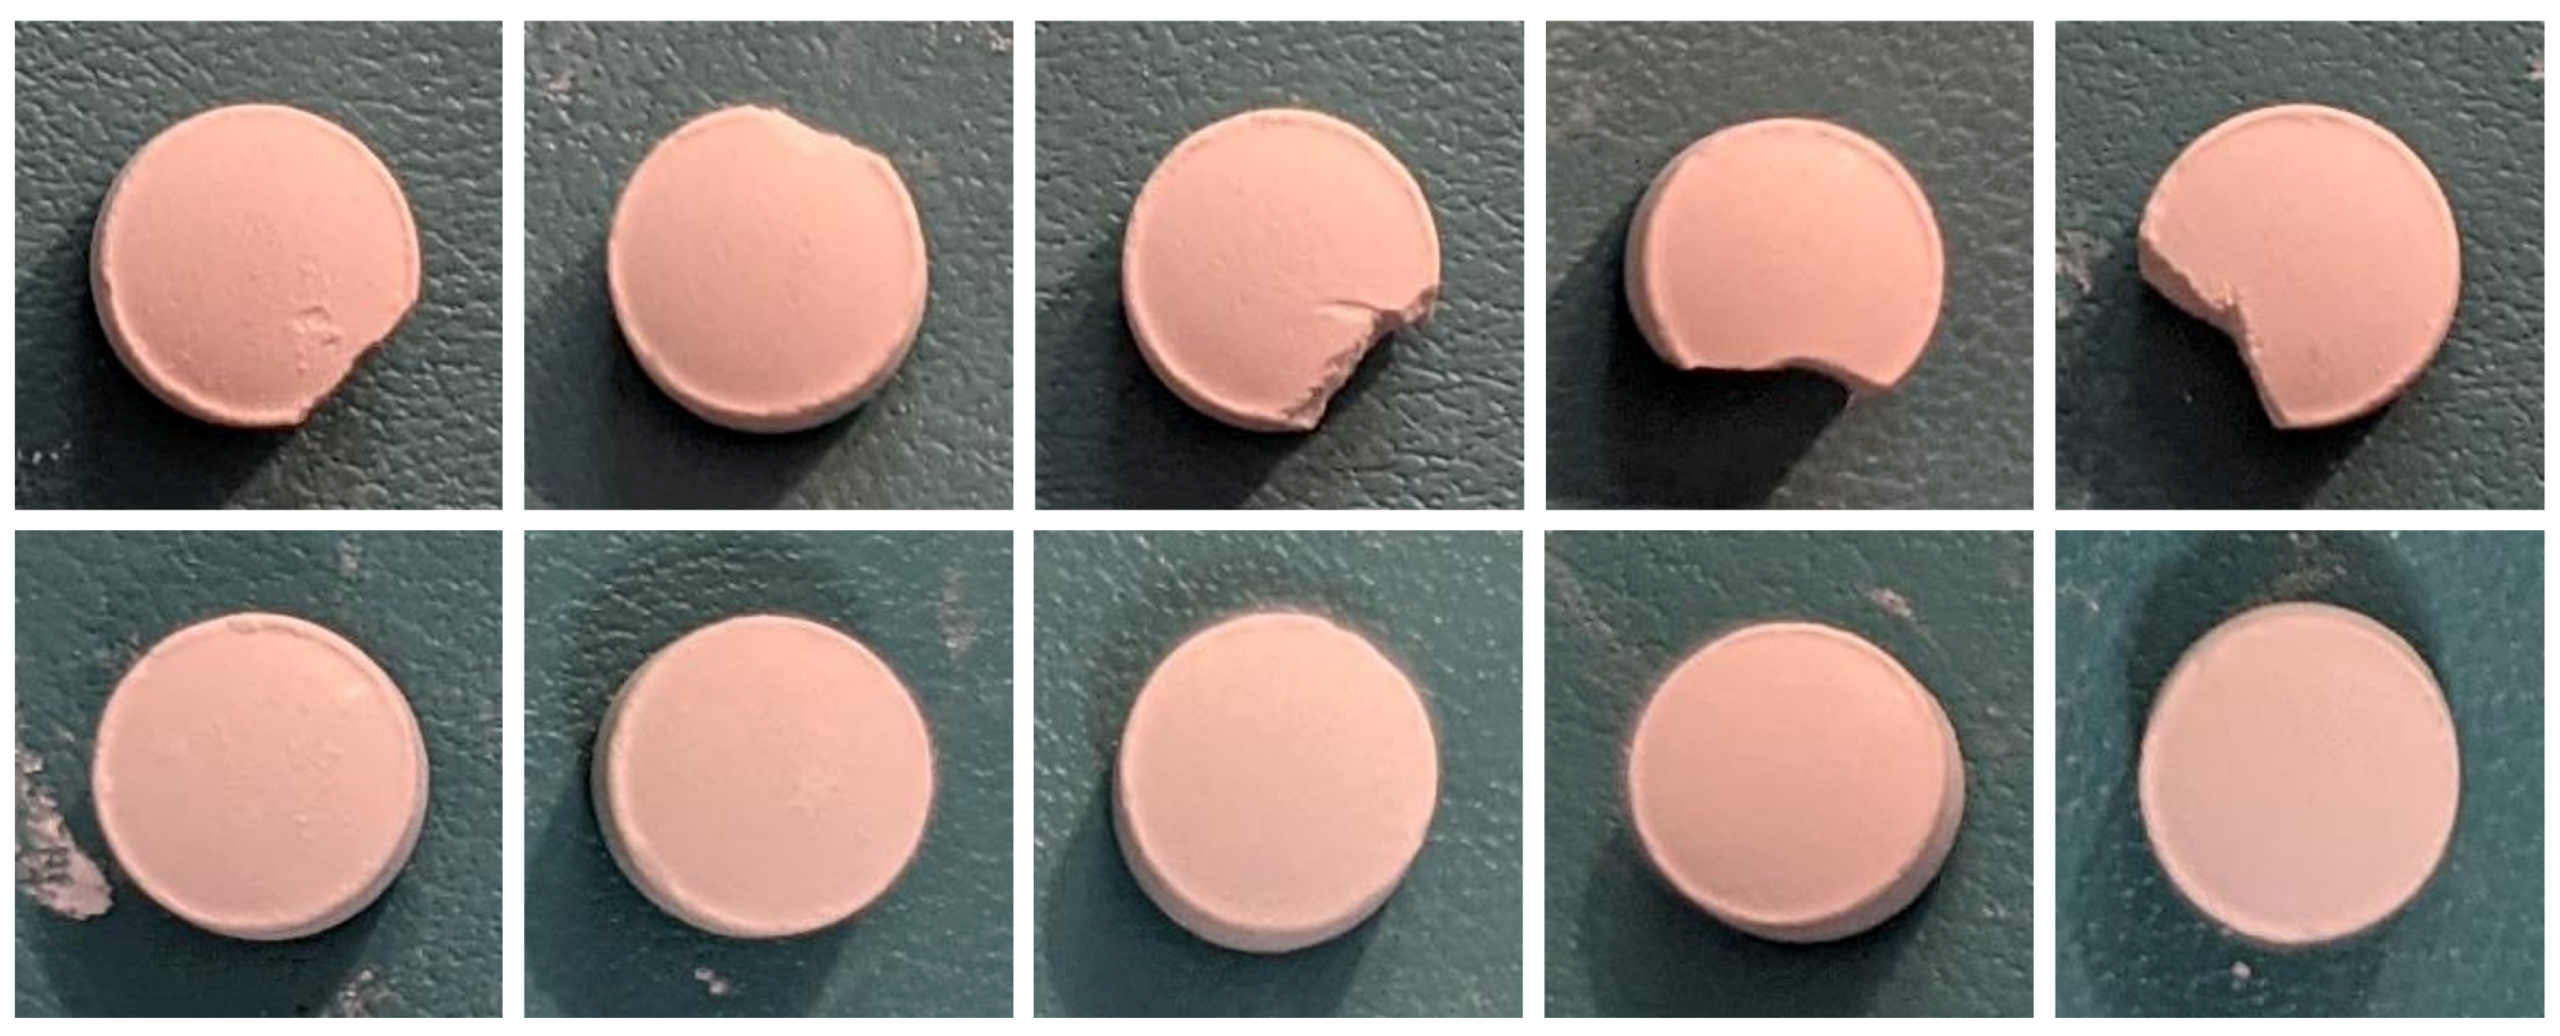
Рисунок 4. Репрезентативные образцы из pillQC, использованные для оценки между наборами данных: таблетки с дефектами чипа показаны в верхнем ряду, а нормальные таблетки — в нижнем ряду.
Таблица 5. Сравнение наборов данных PV и pillQC.
| Характерный | Набор данных PV | набор данных pillQC |
|---|---|---|
| Оцененные изображения | 200 (тестовый комплект; 50% брака) | 192 (43 чипа, 149 исправных; 22,4% бракованных) |
| Форма планшета | Круглая, овальная, в форме капсулы, твердая капсула, в форме сердца. | Только круглые |
| Цвет планшета | Белый/кремовый, желтый, оранжевый/персиковый, красный/розовый/бордовый, коричневый/оливковый, серый/бежевый, синий, зеленый/бирюзовый | Розовый/лосось |
| Покрытие | Твердая капсула, покрытая пленочной оболочкой, без оболочки, с сахарной оболочкой. | Без покрытия |
| Особенности поверхности | Разметка поля, рельефные логотипы, буквенно-цифровые оттиски (многие таблички) | Ничего не видно |
| Разнообразие продукции | 91 визуально различающаяся группа товаров | Один продукт |
| Оценены типы дефектов | Сколы, трещины, поломки, истирание, изменение цвета/пятна/пятна/загрязнения, ламинирование | Только чип |
| Разрешение изображения | Переменная (≈80% квадратных посевов) | 225 × 225 пикселей (фиксированное разрешение) |
| Фон | Разнообразные (различные цвета и текстуры) | Однородная темно-бирюзово-серая текстура |
| Освещение | Неконтролируемый, переменчивый | Фиксированный, контролируемый, даже |
| Устройство визуализации | Два потребительских смартфона (Samsung Galaxy A35, A05) | Не указано (контролируемая настройка) |
| Условия получения данных | Реальное производство + контролируемая лаборатория | Стационарная контролируемая лабораторная установка |
2.2. Эталонные модели
Современные архитектуры глубокого обучения, охватывающие классические сверточные сети, вычислительно эффективные и ориентированные на мобильные устройства сети, а также графические трансформеры, были протестированы на наборе данных PV с использованием идентичного протокола обучения и оценки. Использование одинаковых разбиений данных, предварительной обработки и настроек обучения для каждой модели гарантирует, что различия в производительности можно отнести к самим архитектурам, а не к вариациям в процедуре обучения.
Эти архитектуры имеют от 1,3 до 140 миллионов параметров и представляют три широких семейства конструкций: сверточные сети, основанные на многослойных или остаточных свертках, сети, оптимизированные для малого количества параметров и вычислительных затрат, и сети на основе трансформеров, которые заменяют свертку самовниманием. Этот выбор актуален для контроля качества таблеток, поскольку такие дефекты, как микротрещины и сколы по краям, представляют собой небольшие локализованные особенности, которые сверточные сети улавливают с помощью локальных рецептивных полей, тогда как трансформеры моделируют взаимосвязи по всей поверхности таблетки.
В анализ были включены сети, ориентированные на мобильные устройства, поскольку практическая система контроля может потребовать работы на смартфонах или встроенных устройствах в точке контроля, что соответствует сбору данных с помощью смартфонов, использованному для создания набора данных PV. Этот диапазон позволяет напрямую оценить влияние архитектурного семейства, глубины и бюджета параметров на классификацию дефектов таблеток, а также компромиссы между точностью и эффективностью, описанные в разделе 3. В совокупности эти результаты обеспечивают базовый уровень, с которым можно сравнивать будущие методы, разработанные на основе набора данных PV. В таблице 6 приведено краткое описание ключевого принципа проектирования каждой архитектуры и обоснование ее включения в бенчмарк.
Таблица 6. Сводная информация об используемых в сравнительном анализе моделях глубокого обучения.
| Категория | Модель | Основной принцип проектирования | Обоснование инклюзивности |
|---|---|---|---|
| Классическая сверточная нейронная сеть | AlexNet [22] | Неглубокий стек из пяти сверточных слоев с активациями ReLU и Dropout. | Классическая базовая линия |
| VGG-19 [23] | Глубокий, однородный набор небольших сверточных фильтров размером 3 × 3. | Глубокая, насыщенная параметрами классическая базовая модель | |
| GoogLeNet [24] | Модули Inception применяют фильтры разных размеров параллельно. | Оптимизированная по параметрам многоветвевая архитектура сверточной нейронной сети | |
| ResNet-50 [25] | Остаточные (пропускающие) соединения позволяют создавать очень глубокие сети. | Широко распространенная современная архитектура сверточных нейронных сетей (CNN). | |
| DenseNet-169 [26] | Плотная взаимосвязь с повторным использованием функций на всех предыдущих уровнях. | Оценивает эффект от плотного повторного использования элементов. | |
| Xception [27] | Поглубоко разделяемые свертки | Высокопроизводительная и вычислительно эффективная сверточная нейронная сеть. | |
| ДЛА-34 [28] | Иерархическая и итеративная многоэтапная агрегация признаков | Оценивает структурированную многоступенчатую агрегацию | |
| Мобильная сеть | ShuffleNetV2 [29] | Групповые свертки с перемешиванием каналов | Архитектура с низким числом параметров и малым числом операций с плавающей запятой для развертывания на периферии сети. |
| MobileNetV3-small [30] | Поглубоко разделяемые свертки, сжатие и возбуждение | Современная, ориентированная на развертывание, легковесная базовая конфигурация. | |
| Мобильная/эффективная сверточная нейронная сеть | EfficientNetV2-S [31] | Комплексное масштабирование глубины, ширины и разрешения с использованием объединенных сверточных блоков. | Современная эффективная сверточная нейронная сеть |
| Трансформатор зрения | ViT-B/32 [32] | Токенизация на основе фрагментов кода с использованием чистого механизма самовнимания, без сверток. | Тестирует несверточную архитектуру, использующую только механизм внимания. |
| Свин-Б [33] | Иерархическая структура с самовниманием сдвинутого окна | Современный иерархический преобразователь зрения |
2.3. Экспериментальная установка
Все архитектуры были инициализированы предварительно обученными весами ImageNet [34], загруженными черезtorchvision.modelsДля каждой архитектуры использовались веса по умолчанию, за исключением Xception и DLA-34, которые недоступны в torchvision и были загружены из библиотеки timm. Все слои каждой сети были дообучены, при этом ни один слой не был заморожен во время обучения. Все архитектуры использовали единый конвейер предварительной обработки: входные изображения были изменены до размера 224 × 224 пикселей и нормализованы с использованием средних значений каналов ImageNet (0,485, 0,456, 0,406) и стандартных отклонений (0,229, 0,224, 0,225). Для каждой архитектуры использовалось единое разрешение входных данных, чтобы точность и вычислительные затраты сравнивались на общей основе; это отличается от исходных разрешений оценки некоторых архитектур, например, 299 × 299 для Xception и 384 × 384 для EfficientNetV2-S, и поэтому может занижать их достижимую точность.
Модели обучались с использованием оптимизатора Adam [35, 36, 37] со скоростью обучения 1 ×10− 4и снижение веса в 1 ×10− 4Размер пакета составлял 16, максимум 100 эпох. Скорость обучения следовала линейному разогреву в течение первой эпохи, затем косинусному уменьшению до 1% от базового значения в течение оставшегося периода обучения. Функция потерь представляла собой стандартную кросс-энтропию (PyTorch).nn.CrossEntropyLoss(с параметрами по умолчанию: без взвешивания классов, без сглаживания меток, без модификации логита), применяемыми одинаково ко всем архитектурам. На этапе вывода к двум выходным логитам применялась функция softmax для получения вероятностей классов.
Контрольные точки модели выбирались на основе наилучшего показателя F2-меры валидации [38], а не точности или F1-меры, вычисленной при пороговом значении решения 0,40, выбранном эмпирически путем оценки F2-меры по всем пороговым значениям {0,30, 0,35, 0,40, 0,45, 0,50} на валидационном наборе и выбора значения, которое максимизировало средний показатель F2-меры валидации по всем двенадцати архитектурам; этот порог был зафиксирован до любой оценки на тестовом наборе и применялся одинаково ко всем архитектурам. Этот же порог 0,40 последовательно применялся во время тестирования как для внутридоменного тестового набора PV, так и для межнаборной оценки на pillQC. Обучение прекращалось досрочно, если показатель F2-меры валидации не улучшался в течение 15 последовательных эпох.
Выбор показателя F2 и порогового значения ниже 0,50 отражает асимметричную структуру затрат в контроле качества фармацевтических таблеток. Ложноотрицательный результат, то есть дефектная таблетка, классифицированная как нормальная, позволяет потенциально несоответствующему продукту пройти этап проверки незамеченным, что напрямую влияет на безопасность пациентов и соблюдение нормативных требований. Ложноположительный результат, то есть нормальная таблетка, помеченная как дефектная, приводит к ненужной проверке или отклонению, что влечет за собой экономические затраты, но не представляет опасности для пациентов.
Показатель F2 в два раза больше учитывает полноту, чем точность, наказывая за ложноотрицательные результаты сильнее, чем за ложноположительные, а пороговое значение ниже 0,50 сдвигает рабочую точку классификатора в сторону большей полноты за счет некоторой потери точности, что соответствует этому приоритету. Таким образом, оба варианта отражают одно и то же базовое суждение об относительных последствиях двух типов ошибок в контексте фармацевтической инспекции.
Перед началом обучения обучающий набор данных был расширен с помощью автономной аугментации данных, как описано в разделе 2.1.6 ; к изображениям для валидации и тестирования, за исключением изменения размера и нормализации, аугментация не применялась. Для каждой эталонной архитектуры использовалась идентичная конфигурация обучения (оптимизатор, функция потерь, предварительная обработка и аугментация), без каких-либо корректировок для каждой архитектуры. Каждая архитектура обучалась один раз с фиксированным случайным начальным значением 7, применяемым для инициализации весов слоя классификации, упорядочивания мини-пакетов и загрузки данных; недетерминированные ядра CUDA в PyTorch не отключались, поэтому для точной побитовой воспроизводимости требуется одинаковая аппаратная и программная среда.
Начальное значение, код обучения и разделы данных предоставляются вместе с набором данных, чтобы позволить воспроизвести эксперименты. Во всех экспериментах использовались PyTorch 2.1.0 [39], torchvision 0.16.0, Python 3.10 и CUDA 12.1, и они выполнялись на рабочей станции с процессором Intel Core i7-7700 (Intel Corporation, Санта-Клара, Калифорния, США), 24 ГБ оперативной памяти и графическим процессором NVIDIA GeForce RTX 3060 [ 40 ] с 12 ГБ памяти.
2.4. Показатели оценки
Производительность модели на тестовом наборе PV оценивалась с использованием точности, прецизионности, полноты и F1-меры, при этом дефектный класс рассматривался как положительный класс, в соответствии с разделом 2.1 . Для матрицы ошибок, в которой TP, TN, FP и FN обозначают истинно положительные, истинно отрицательные, ложноположительные и ложноотрицательные результаты относительно дефектного класса, метрики определяются уравнениями (1) – (4):
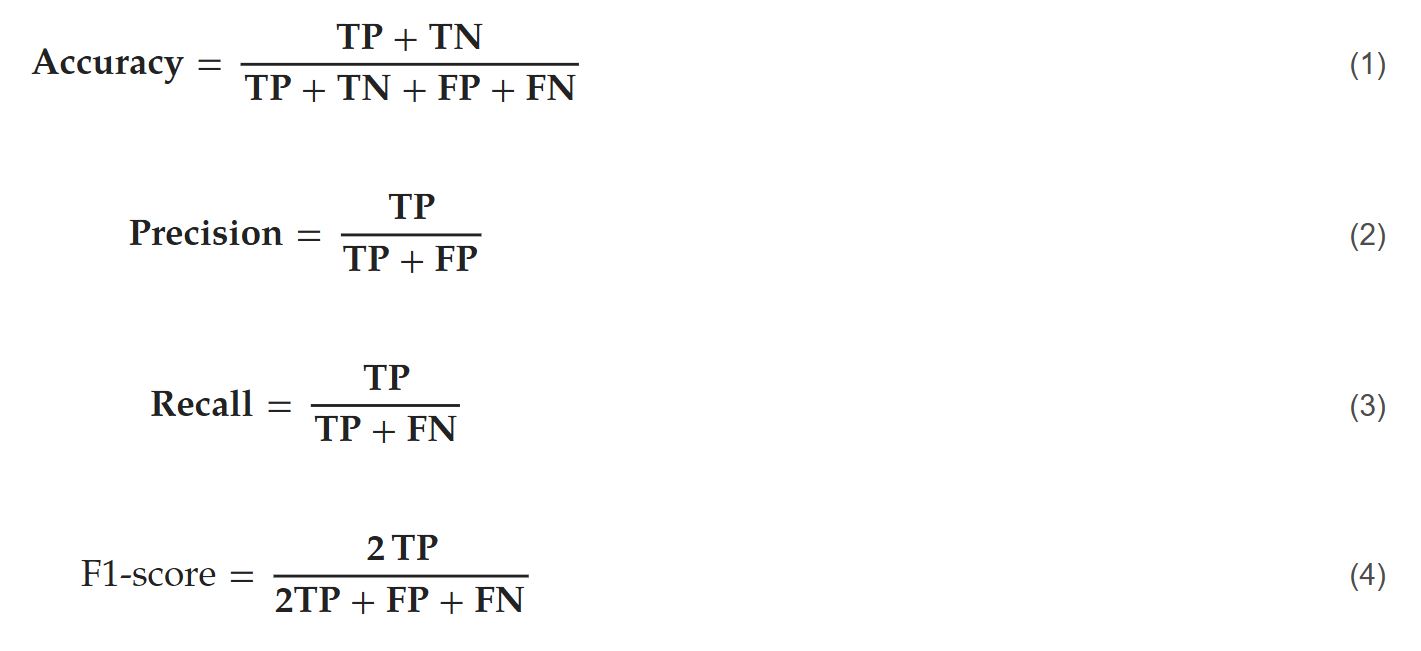
В данном контексте определение класса дефектных изделий имеет практическое значение, поскольку ложноотрицательный результат соответствует дефектной таблетке, ошибочно классифицированной как нормальная, — ошибке, которую система контроля качества призвана предотвратить. Поскольку тестовые наборы невелики, все показатели дополнительно приводятся с 95% доверительными интервалами, а различия между архитектурами оцениваются с помощью парных статистических тестов (раздел 3.3).
Помимо прогнозируемой производительности, каждая архитектура была протестирована на вычислительную эффективность с использованием четырех показателей, актуальных для развертывания в условиях линейного контроля. Параметры показывают общее количество обучаемых параметров в сети в миллионах (М), поскольку каждый слой был точно настроен (раздел 2.3), что указывает на общий размер модели и объем используемой памяти. GFLOPs показывает количество операций с плавающей запятой в гигабитах, необходимых для одного прямого прохода при входном разрешении 224 × 224, что указывает на вычислительную стоимость, не зависящую от оборудования. Задержка вывода показывает медианное время в миллисекундах (мс) для обработки одного изображения (размер пакета 1), измеренное за 500 синхронизированных прямых проходов после 50 прогревочных проходов, при этом выполнение на GPU синхронизировалось вокруг каждого прохода; изменчивость указывается как межквартильный размах (IQR). Пропускная способность в кадрах в секунду (FPS) является обратной величиной медианной задержки и представляет собой теоретическую скорость обработки одного изображения, а не сквозную пропускную способность линии контроля. Показатель пропускной способности (кадров в секунду) отражает величину, обратную задержке обработки одного изображения, указывая на максимальную скорость передачи изображений, которую может поддерживать архитектура, и напрямую показывая, может ли она работать на уровне производственной линии контроля качества.
2.5. Использование генеративного ИИ
3. Результаты
3.1. Результаты классификации в рамках предметной области на тестовом наборе данных PV
В таблице 7 представлены показатели точности, прецизионности, полноты и F1-меры для всех протестированных архитектур на отложенном тестовом наборе PV, при этом класс дефектных элементов рассматривается как положительный.
Таблица 7. Результаты классификации на тестовом наборе данных PV (обучающий набор: обучающий набор PV; тестовый набор: тестовый набор PV). Все значения указаны в процентах; лучшее значение в каждом столбце выделено жирным шрифтом. 95% доверительные интервалы и парные статистические сравнения приведены в разделе 3.3.
| Метод | Точность | Точность | Отзывать | F1-мера |
|---|---|---|---|---|
| AlexNet [ 22 ] | 65.50 | 63.48 | 73.00 | 67.91 |
| VGG-19 [ 23 ] | 83.50 | 79.65 | 90.00 | 84.51 |
| GoogLeNet [ 24 ] | 84.50 | 91.57 | 76.00 | 83.06 |
| ResNet-50 [ 25 ] | 84.00 | 84.69 | 83.00 | 83.84 |
| DenseNet-169 [ 26 ] | 80.50 | 87.65 | 71.00 | 78.45 |
| Xception [ 27 ] | 86.50 | 83.49 | 91.00 | 87.08 |
| ДЛА-34 [ 28 ] | 81.00 | 81.63 | 80.00 | 80.81 |
| ShuffleNetV2 [ 29 ] | 86.00 | 92.86 | 78.00 | 84.78 |
| MobileNetV3-small [ 30 ] | 73.00 | 76.14 | 67.00 | 71.28 |
| EfficientNetV2-S [ 31 ] | 88.50 | 88.12 | 89.00 | 88.56 |
| ViT-B/32 [ 32 ] | 82.00 | 82.65 | 81.00 | 81.82 |
| Свин-Б [ 33 ] | 86.50 | 91.01 | 81.00 | 85.71 |
EfficientNetV2-S показал наивысший показатель F1-меры (88,56%) и точности (88,50%), а также сбалансированные показатели прецизии (88,12%) и полноты (89,00%), за ним следуют Xception (87,08%) и Swin-B (85,71%). Однако эти различия находятся в пределах погрешности выборки: доверительные интервалы ведущих архитектур перекрываются, и парные тесты не показали существенной разницы между ними (раздел 3.3). Более надежным наблюдением является то, что группа архитектур, EfficientNetV2-S, Xception, Swin-B, ShuffleNetV2 и VGG-19, сгруппировалась между 84% и 89% показателя F1-меры, отделившись от наименее эффективных. В бенчмарке AlexNet показала самые низкие показатели точности, прецизионности и F1-меры (67,91% F1), а MobileNetV3-small — второй самый низкий (71,28% F1), что указывает на то, что как самые ранние, так и наиболее ограниченные по параметрам архитектуры испытывали сравнительно большие трудности с этой задачей.
Точность и полнота не всегда коррелировали. ShuffleNetV2 показал высокую точность (92,86%, аналогично GoogLeNet и Swin-B), но сравнительно скромную полноту (78,00%), что указывает на консервативный профиль принятия решений, который недостаточно выделяет дефектные таблетки в обмен на редкую неправильную классификацию нормальных таблеток. Xception показал противоположную картину: высокая полнота (91,00%) наряду с высокой точностью (83,49%). Поскольку пропущенные дефектные таблетки являются наиболее серьезной ошибкой в условиях контроля качества, профиль, ориентированный на полноту, предпочтительнее профиля, ориентированного на точность. EfficientNetV2-S показал сбалансированный профиль, хотя его полнота существенно не отличалась от полноты Xception (89 против 91 из 100 обнаруженных дефектных таблеток).
3.2. Обобщение данных на набор данных pillQC.
Для оценки обобщающей способности за пределами исходного распределения набора данных PV каждая модель, обученная исключительно на обучающем наборе данных PV, была оценена без тонкой настройки или адаптации на независимом наборе данных pillQC. Результаты представлены в таблице 8. GoogLeNet достиг наивысшего показателя F1-меры между наборами данных (76,19%), за ним следует EfficientNetV2-S (75,00%), несмотря на его среднюю производительность в предметной области (83,06%), поэтому порядок результатов в предметной области и между наборами данных не совпал. Две архитектуры различаются всего двумя правильно классифицированными изображениями и статистически неразличимы ( раздел 3.3 ); существенным результатом является статистически значимый контраст между этой ведущей парой и графическими трансформерами в нижней части таблицы.
Показатель F1-меры для всех архитектур снизился при переходе от тестового набора PV к pillQC, однако величина снижения существенно различалась. GoogLeNet показал наименьшее абсолютное падение (6,87 процентных пункта), в то время как Swin-B (45,09 пункта) и ViT (42,93 пункта) показали наибольшее, наряду с AlexNet (38,85 пункта) и ShuffleNetV2 (35,34 пункта). Поскольку каждое снижение представляет собой разницу двух оценок с широкими доверительными интервалами, следует интерпретировать только значительные снижения. Часть снижения, общая для всех архитектур, объясняется разницей в распространенности классов между двумя оценочными наборами (22,4% положительных результатов на pillQC против 50% на тестовом наборе PV), поскольку точность и F1-мера зависят от базовой частоты; различия между архитектурами, которые лежат в основе проведенных здесь сравнений, не зависят от этого, поскольку все модели оценивались на одних и тех же изображениях. Таким образом, оба графических трансформера оказались одними из наименее устойчивых к изменению распределения, представленному pillQC, несмотря на то, что Swin-B показал сопоставимые результаты с ведущей группой в данной области. Одно из возможных объяснений — более высокие требования к данным, обычно связанные с архитектурами самовнимания, хотя данное исследование не было предназначено для проверки этого (раздел 4.1).
Вторая закономерность, очевидная в таблице 8, — это систематическое снижение полноты при изменении распределения, более значительное, чем соответствующее снижение точности. Например, ResNet-50 сохранил высокую точность (96,15%) на pillQC, но полнота упала до 58,14%; MobileNetV3-small и DenseNet-169 показали еще более выраженную версию этой закономерности: полнота упала до 30,23% и 34,88% соответственно, в то время как точность осталась сравнительно высокой. На полноту не влияет разница в распространенности между двумя наборами данных, поэтому эта асимметрия отражает подлинное изменение поведения модели, а не артефакт базовой частоты. В контексте контроля качества это наименее благоприятное направление для ухудшения производительности: при изменении распределения эти модели стали более консервативными и пропустили большую долю дефектных таблеток, вместо того чтобы симметрично давать сбои по обоим классам.
Таблица 8. Результаты классификации на разных наборах данных (обучение: обучающий набор PV; тестирование: pillQC без тонкой настройки). Все значения указаны в процентах; жирным шрифтом выделены лучшие результаты в каждом столбце. 95% доверительные интервалы и парные статистические сравнения приведены в разделе 3.3.
| Метод | Точность | Точность | Отзывать | F1-мера |
|---|---|---|---|---|
| AlexNet [ 22 ] | 56.77 | 22.97 | 39.53 | 29.06 |
| VGG-19 [ 23 ] | 88.02 | 73.81 | 72.09 | 72.94 |
| GoogLeNet [ 24 ] | 89.58 | 78.05 | 74.42 | 76.19 |
| ResNet-50 [ 25 ] | 90.10 | 96.15 | 58.14 | 72.46 |
| DenseNet-169 [ 26 ] | 83.33 | 78.95 | 34.88 | 48.39 |
| Xception [ 27 ] | 88.54 | 83.87 | 60.47 | 70.27 |
| ДЛА-34 [ 28 ] | 86.46 | 79.31 | 53.49 | 63.89 |
| ShuffleNetV2 [ 29 ] | 76.56 | 47.83 | 51.16 | 49.44 |
| MobileNetV3-small [ 30 ] | 83.33 | 86.67 | 30.23 | 44.83 |
| EfficientNetV2-S [ 31 ] | 90.62 | 93.10 | 62.79 | 75.00 |
| ViT-B/32 [ 32 ] | 54.17 | 27.72 | 65.12 | 38.89 |
| Свин-Б [ 33 ] | 80.21 | 61.90 | 30.23 | 40.62 |
3.3. Статистический анализ
Тестовый набор PV содержит 200 изображений (100 из которых дефектные), поэтому разница в один процентный пункт в точности соответствует двум изображениям, а оценка pillQC содержит только 43 дефектных изображения, поэтому одно изображение изменяет показатель полноты на 2,33 процентных пункта. Таким образом, неопределенность результатов в таблицах 7 и 8 была количественно оценена двумя способами: 95% доверительными интервалами для каждой архитектуры (раздел 3.3.1) и парными сравнениями между архитектурами (раздел 3.3.2).
3.3.1. 95% доверительные интервалы
В таблице 9 представлены точность, прецизионность, полнота и F1-мера для каждой архитектуры на обоих тестовых наборах вместе с их 95% доверительными интервалами. Точность, прецизионность и полнота представлены в виде долей, а их интервалы были вычислены с помощью метода оценки Вильсона [41, 42]. F1-мера не имеет замкнутой формулы дисперсии, поэтому ее интервал был получен с помощью непараметрического бутстрапа [43], путем перевыборки тестовых изображений с замещением 10 000 раз и взятия 2,5-го и 97,5-го процентилей полученных F1-мер. На тестовом наборе PV интервалы точности охватывают приблизительно ±5 процентных пунктов, а интервалы прецизионности и полноты — приблизительно ±6–9 пунктов. Интервалы F1-меры ведущих архитектур существенно перекрываются: EfficientNetV2-S (88,56%, 95% ДИ 83,6–92,9%), Xception (87,08%, 81,9–91,6%), Swin-B (85,71%, 79,8–90,7%), ShuffleNetV2 (84,78%, 78,8–89,9%) и VGG-19 (84,51%, 78,9–89,5%). Поэтому их порядок в таблице 7 статистически не установлен. В отличие от них, AlexNet (67,91%, 60,4–74,7%) и MobileNetV3-small (71,28%, 63,4–78,3%) явно находятся ниже этой группы. На pillQC интервалы шире, при этом большинство интервалов F1-меры охватывают около 20–30 процентных пунктов. GoogLeNet (76,19%, 64,9–85,4%) и EfficientNetV2-S (75,00%, 62,5–85,1%) практически полностью перекрываются, и лишь значительные различия поддаются интерпретации: интервалы F1-меры ViT-B/32 (28,6–48,8%) и Swin-B (24,6–54,8%) не перекрываются с интервалами ни одной из ведущих архитектур.
Таблица 9. Показатели производительности с 95% доверительными интервалами на тестовом наборе PV и на pillQC. Значения указаны в процентах и представлены в виде точечной оценки (95% доверительный интервал). Интервалы для точности, прецизионности и полноты — это интервалы оценки Вильсона; интервалы для F1-меры — это бутстрап-интервалы в процентах (10 000 повторных выборок тестовых изображений).
| Метод | Точность | Точность | Отзывать | F1-мера |
|---|---|---|---|---|
| (а) Комплект для тестирования фотоэлектрических элементов ( n = 200; 100 неисправных) | ||||
| AlexNet [22] | 65,50 (58,7–71,7) | 63,48 (54,4–71,7) | 73.00 (63.6–80.7) | 67,91 (60,4–74,7) |
| VGG-19 [23] | 83,50 (77,7–88,0) | 79,65 (71,3–86,0) | 90.00 (82.6–94.5) | 84,51 (78,9–89,5) |
| GoogLeNet [24] | 84,50 (78,8–88,9) | 91,57 (83,6–95,9) | 76.00 (66.8–83.3) | 83,06 (76,8–88,5) |
| ResNet-50 [25] | 84.00 (78.3–88.4) | 84,69 (76,3–90,5) | 83.00 (74.5–89.1) | 83,84 (77,8–89,0) |
| DenseNet-169 [26] | 80,50 (74,5–85,4) | 87,65 (78,7–93,2) | 71.00 (61.5–79.0) | 78,45 (71,4–84,6) |
| Xception [27] | 86,50 (81,1–90,6) | 83,49 (75,4–89,3) | 91.00 (83.8–95.2) | 87,08 (81,9–91,6) |
| ДЛА-34 [28] | 81.00 (75.0–85.8) | 81,63 (72,8–88,1) | 80.00 (71.1–86.7) | 80,81 (74,3–86,4) |
| ShuffleNetV2 [29] | 86.00 (80.5–90.1) | 92,86 (85,3–96,7) | 78.00 (68.9–85.0) | 84,78 (78,8–89,9) |
| MobileNetV3-small [30] | 73.00 (66.5–78.7) | 76.14 (66.3–83.8) | 67.00 (57.3–75.4) | 71,28 (63,4–78,3) |
| EfficientNetV2-S [31] | 88,50 (83,3–92,2) | 88.12 (80.4–93.1) | 89.00 (81.4–93.7) | 88,56 (83,6–92,9) |
| ViT-B/32 [32] | 82.00 (76.1–86.7) | 82,65 (74,0–88,9) | 81.00 (72.2–87.5) | 81,82 (75,5–87,3) |
| Свин-Б [33] | 86,50 (81,1–90,6) | 91.01 (83.3–95.4) | 81.00 (72.2–87.5) | 85,71 (79,8–90,7) |
| (b) pillQC, перекрестный набор данных ( n = 192; 43 дефектных) | ||||
| AlexNet [22] | 56,77 (49,7–63,6) | 22,97 (14,9–33,7) | 39,53 (26,4–54,4) | 29.06 (17.9–40.0) |
| VGG-19 [23] | 88,02 (82,7–91,9) | 73,81 (58,9–84,7) | 72.09 (57.3–83.3) | 72,94 (61,3–82,7) |
| GoogLeNet [24] | 89,58 (84,5–93,2) | 78,05 (63,3–88,0) | 74,42 (59,8–85,1) | 76.19 (64.9–85.4) |
| ResNet-50 [25] | 90.10 (85.1–93.6) | 96.15 (81.1–99.3) | 58.14 (43.3–71.6) | 72,46 (59,4–83,3) |
| DenseNet-169 [26] | 83.33 (77.4–87.9) | 78,95 (56,7–91,5) | 34,88 (22,4–49,8) | 48.39 (31.9–62.9) |
| Xception [27] | 88,54 (83,3–92,3) | 83,87 (67,4–92,9) | 60,47 (45,6–73,6) | 70,27 (57,1–81,2) |
| ДЛА-34 [28] | 86,46 (80,9–90,6) | 79.31 (61.6–90.2) | 53,49 (38,9–67,5) | 63,89 (50,0–75,9) |
| ShuffleNetV2 [29] | 76,56 (70,1–82,0) | 47,83 (34,1–61,9) | 51.16 (36.8–65.4) | 49,44 (35,9–61,7) |
| MobileNetV3-small [30] | 83.33 (77.4–87.9) | 86,67 (62,1–96,3) | 30.23 (18.6–45.1) | 44,83 (27,6–59,4) |
| EfficientNetV2-S [31] | 90,62 (85,7–94,0) | 93.10 (78.0–98.1) | 62,79 (47,9–75,6) | 75.00 (62.5–85.1) |
| ViT-B/32 [32] | 54.17 (47.1–61.1) | 27.72 (19.9–37.1) | 65.12 (50.2–77.6) | 38,89 (28,6–48,8) |
| Свин-Б [33] | 80,21 (74,0–85,2) | 61,90 (40,9–79,2) | 30.23 (18.6–45.1) | 40,62 (24,6–54,8) |
3.3.2. Попарные сравнения
Перекрытие интервалов для каждой модели является консервативным и само по себе не проверяет, различаются ли две модели. Поскольку все архитектуры оценивались на одних и тех же изображениях, различия проверялись парными методами: точным тестом Макнемара [44, 45] для правильности на уровне изображения и парным бутстрапным доверительным интервалом для разницы в F1-мере, в котором одни и те же пересэмплированные изображения использовались для обеих моделей в каждой из 10 000 повторений. Сравнения проводились между архитектурой с наивысшим баллом на каждом тестовом наборе и ее ближайшими конкурентами и самыми слабыми архитектурами, а p -значения корректировались методом Холма [46] для всех сравнений в таблице 10 .
На тестовом наборе PV EfficientNetV2-S не показал существенных отличий от Xception (ΔF1 = +1,48 процентных пункта, 95% ДИ от −3,4 до 6,4), Swin-B (+2,85, от −2,4 до 8,4) или ShuffleNetV2 (+3,78, от −1,7 до 9,6) (критерий Макнемара p = 0,47–0,57; скорректированный по Холму p = 1,00 для всех трех). EfficientNetV2-S правильно классифицировал 177 из 200 изображений, по сравнению со 173 для Xception и Swin-B; разница в четыре изображения не может достичь статистической значимости при точном критерии Макнемара, независимо от распределения ошибок (минимально достижимый p = 0,125).
Его преимущество перед AlexNet было значительным (+20,65, от 13,8 до 28,1; p < 0,001 по методу Холма ). На pillQC GoogLeNet и EfficientNetV2-S отличались всего двумя правильно классифицированными изображениями (172 против 174; минимально достижимый p по Макнемару = 0,50), а GoogLeNet не отличался существенно от VGG-19 (+3,25, от −7,1 до 14,0; p = 1,00 по методу Холма). В отличие от этого, GoogLeNet значительно превзошел Swin-B (+35,57, от 20,6 до 51,5) и ViT-B/32 (+37,30, от 27,7 до 47,4) ( p < 0,001 по методу Холма для обоих). Таким образом, бенчмарк позволяет отделить ведущую группу архитектур от наименее эффективных и подтверждает более слабую межсетевую передачу данных у графических трансформеров, но не устанавливает порядок внутри ведущей группы.
Таблица 10. Парные сравнения архитектур, оцененных на идентичных изображениях. ΔF1: разница в показателе F1 (A, B, процентные пункты) с 95% парным бутстрапным доверительным интервалом (10 000 повторных выборок, идентичные изображения, полученные для обеих моделей); p: точный тест Макнемара для оценки правильности на каждом изображении; p_Holm: скорректированный по Холму p для сравнений в этой таблице.
| Тестовый набор | Модель А против модели В | Правильный ответ (A/B) | ΔF1 (95% ДИ) | п | p _Holm |
|---|---|---|---|---|---|
| PV | EfficientNetV2-S против Xception | 177/173 | +1,48 (−3,4 до 6,4) | 0,57 | 1.00 |
| PV | EfficientNetV2-S против Swin-B | 177/173 | +2,85 (−2,4 до 8,4) | 0,57 | 1.00 |
| PV | EfficientNetV2-S против ShuffleNetV2 | 177/172 | +3,78 (−1,7 до 9,6) | 0,47 | 1.00 |
| PV | EfficientNetV2-S против AlexNet | 177/131 | +20,65 (13,8 до 28,1) | <0.001 | <0.001 |
| pillQC | GoogLeNet против EfficientNetV2-S | 172/174 | +1,19 (н/д) а | ≥0,50 а | 1.00 |
| pillQC | GoogLeNet против VGG-19 | 172/169 | +3,25 (−7,1 до 14,0) | 0,61 | 1.00 |
| pillQC | GoogLeNet против Swin-B | 172/154 | +35,57 (от 20,6 до 51,5) | <0.001 | <0.001 |
| pillQC | GoogleNet против ViT-B/32 | 172/104 | +37,30 (от 27,7 до 47,4) | <0.001 | <0.001 |
3.4. Сложность модели и вычислительная эффективность
В таблице 11 представлены количество параметров, GFLOPs, задержка вывода и пропускная способность для каждой архитектуры. Задержка указана как медиана и межквартильный размах (IQR) за 500 запусков вывода на одном изображении после 50 запусков прогрева; медиана используется вместо среднего значения, поскольку у нескольких архитектур наблюдалось правостороннее смещение распределения задержки, обусловленное дрожанием планирования GPU. Приведенные значения пропускной способности представляют собой теоретическую скорость обработки одного изображения каждой модели в измеренных условиях и не должны интерпретироваться как сквозная пропускная способность промышленной системы контроля, которая дополнительно зависит от получения изображения, предварительной обработки, передачи данных и накладных расходов на планирование конвейера. AlexNet достигла самой высокой пропускной способности (602,41 FPS) и самой низкой медианной задержки (1,66 мс) среди всех архитектур, несмотря на четвертое по величине количество параметров (57,01 млн) в бенчмарке; Более прямым объяснением этого результата является не количество параметров, а небольшая глубина архитектуры — всего пять сверточных слоев. ShuffleNetV2 (1,26 млн) и MobileNetV3-small (1,52 млн) имели наименьшее количество параметров и наименьшее количество GFLOPs, что соответствует их архитектуре, ориентированной на мобильные устройства, и обе поддерживали умеренную пропускную способность (79,75 и 107,99 FPS соответственно). Swin-B показал самую высокую медианную задержку (41,19 мс) и самую низкую пропускную способность (24,28 FPS) среди всех архитектур, несмотря на меньшее количество параметров, чем у VGG-19 (86,74 млн против 139,58 млн); VGG-19, напротив, достиг более высокой пропускной способности (146,84 FPS), чем можно было бы предположить, исходя только из количества параметров.
В целом, количество параметров и GFLOPs оказались ненадежными предикторами измеренной задержки. DenseNet-169 (12,48 млн параметров, 6,87 GFLOPs) и EfficientNetV2-S (20,18 млн параметров, 5,80 GFLOPs) показали медианные значения задержки (40,23 мс и 33,68 мс соответственно), значительно превышающие значения для архитектур с сопоставимой или большей теоретической вычислительной стоимостью, таких как Xception (20,81 млн параметров, 9,19 GFLOPs, 11,86 мс) или ResNet-50 (23,51 млн параметров, 8,26 GFLOPs, 12,46 мс). Эти два случая отражают разные механизмы с общим следствием: многократное объединение признаков в DenseNet-169 на плотно связанных слоях и сильно блочная структура EfficientNetV2-S с операциями сжатия и возбуждения, оба являются недорогими в операциях с плавающей запятой, но не распараллеливаются на оборудовании GPU так же эффективно, как более простые последовательные свертки. Таким образом, GFLOPs и количество параметров описывают теоретическую вычислительную стоимость, но ни один из них не заменяет непосредственно измеренную задержку при оценке возможности развертывания на конкретном оборудовании.
Таблица 11. Сложность модели и эффективность вывода. Жирным шрифтом выделены лучшие результаты в каждом столбце (наименьшее количество параметров, GFLOPs и задержка; наибольшая пропускная способность). Задержка указана как медиана (межквартильный размах) по результатам 500 запусков вывода для одного изображения после 50 прогревочных запусков на графическом процессоре NVIDIA GeForce RTX 3060. Пропускная способность — это теоретическая скорость обработки одного изображения (1000/медианная задержка мс) и не отражает пропускную способность промышленного конвейера от начала до конца (M: миллионы; GFLOPs: гигабитные операции с плавающей запятой; ms: миллисекунды; FPS: кадров в секунду).
| Метод | Параметры (М) | ГФЛОПС | Медианная задержка (мс) |
Межквартильный размах (мс) | Пропускная способность (FPS) |
|---|---|---|---|---|---|
| AlexNet [22] | 57.01 | 1.42 | 1.66 | 0,23 | 602.41 |
| VGG-19 [23] | 139.58 | 39.26 | 6.81 | 0,35 | 146.84 |
| GoogLeNet [24] | 5.60 | 3.02 | 15.35 | 8.07 | 65.15 |
| ResNet-50 [25] | 23.51 | 8.26 | 12.46 | 2.55 | 80.26 |
| DenseNet-169 [26] | 12.48 | 6.87 | 40.23 | 5.36 | 24.86 |
| Xception [27] | 20.81 | 9.19 | 11.86 | 2.80 | 84.32 |
| ДЛА-34 [28] | 15.27 | 6.18 | 7.99 | 1.67 | 125.16 |
| ShuffleNetV2 [29] | 1.26 | 0.30 | 12.54 | 3.10 | 79.74 |
| MobileNetV3-small [30] | 1.52 | 0,12 | 9.26 | 1.90 | 107.99 |
| EfficientNetV2-S [31] | 20.18 | 5.80 | 33.68 | 4.33 | 29.69 |
| ViT-B/32 [32] | 87.46 | 5.90 | 10.40 | 1.05 | 96.15 |
| Свин-Б [33] | 86.74 | 20.44 | 41.19 | 2.97 | 24.28 |
3.5. Краткий обзор компромиссов в отношении производительности, обобщаемости и эффективности.
В совокупности таблицы 7, 8, 9, 10 и 11 показывают, что ни одна архитектура не доминирует одновременно по показателям прогностической эффективности, обобщения на разных наборах данных и вычислительной эффективности. EfficientNetV2-S входила в лидирующую группу на обоих тестовых наборах (показатель F1 в предметной области 88,56%; показатель F1 на разных наборах данных 75,00%, статистически неотличима от GoogLeNet) с умеренным количеством параметров (20,18 млн), хотя ее измеренная медианная задержка (33,68 мс) была выше, чем можно было бы предположить, исходя из ее GFLOPs. GoogLeNet, несмотря на средние показатели в рамках предметной области, показал самый высокий показатель F1-меры на разных наборах данных (76,19%), сопоставимый с EfficientNetV2-S, и наименьшее снижение между двумя тестовыми наборами (6,87 балла), а также небольшое количество параметров (5,60 млн), что делает его подходящим кандидатом для случаев, когда приоритет отдается устойчивости к неизвестным условиям визуализации, а не максимальной точности в рамках предметной области.
AlexNet продемонстрировал значительно более высокую теоретическую пропускную способность среди всех архитектур, но показал самые слабые результаты прогнозирования как на тестовом наборе PV, так и на pillQC, что иллюстрирует классический компромисс между точностью и эффективностью в его наиболее экстремальной форме в рамках этого бенчмарка. Архитектуры Vision Transformer (ViT и Swin-B), хотя и конкурентоспособны на тестовом наборе данных PV в рамках данной области, показали наибольшее снижение показателя F1-меры в разных наборах данных, значительно ниже, чем у ведущих сверточных нейронных сетей на pillQC, а в случае Swin-B — самую низкую измеренную пропускную способность среди всех оцененных архитектур, что делает их наименее привлекательным вариантом среди двенадцати для развертывания в условиях, представленных этим бенчмарком.
4. Обсуждение
4.1. Основные выводы
-
Ни одна из архитектур одновременно не демонстрировала наилучших результатов по точности прогнозирования, обобщению на разных наборах данных и вычислительной эффективности. EfficientNetV2-S неизменно входила в лидирующую группу на обоих тестовых наборах, хотя ее преимущество над Xception и Swin-B в рамках предметной области, а также разница с GoogLeNet на pillQC находились в пределах погрешности выборки (раздел 3.3). GoogLeNet показала наименьшее снижение точности внутри предметной области по сравнению с результатами на разных наборах данных, несмотря на более низкую точность внутри предметной области, а AlexNet оказалась намного быстрее обеих, несмотря на то, что показала наихудшие результаты по точности прогнозирования в бенчмарке. Таким образом, выбор архитектуры для реального развертывания зависит от того, какое из этих трех свойств является приоритетным, а не от определения единственной лучшей модели.
-
Значительно более низкая производительность ViT-B/32 и Swin-B при работе с разными наборами данных по сравнению с их результатами в рамках домена PV может частично отражать более высокие требования к данным, обычно связанные с архитектурами самовнимания, которым не хватает априорных знаний о локальности и инвариантности к сдвигу, присущих сверточным сетям, и поэтому они могут хуже обобщаться при обучении на небольшом наборе данных. Однако данное исследование не было направлено на выделение влияния размера набора данных или архитектурной индуктивной предвзятости: два графических трансформера также отличаются от сверточных архитектур по количеству параметров, поведению до обучения и структуре рецептивного поля, а переход между наборами данных одновременно изменяет внешний вид планшета, тип дефекта, распространенность класса и разрешение изображения. Таким образом, наблюдаемый разрыв в производительности согласуется с объяснением, связанным с размером данных, но не устанавливает его в качестве причинного механизма.
-
Различия в производительности между различными архитектурами pillQC на разных наборах данных отражают несколько одновременных факторов, которые невозможно разделить из одного эксперимента с нулевой адаптацией: изменение внешнего вида таблеток и разнообразия продуктов, ограничение дефектами только чипа, изменение распространенности класса с 50% до 22,4%, использование порогового значения, полученного на основе PV и не перекалиброванного для pillQC, а также разница в разрешении изображений.
-
Для большинства архитектур показатель полноты (recall) ухудшался сильнее, чем показатель точности (precision) при сдвиге распределения. В контексте фармацевтического контроля качества это наименее благоприятное направление отказа: модель, которая становится более консервативной при сдвиге распределения, пропустит большую долю действительно дефектных таблеток, а именно эту ошибку система скрининга и призвана предотвращать. Это подтверждает решение, принятое в разделе 2.3, выбирать контрольные точки модели, используя показатель F2, а не точность или показатель F1.
-
Количество параметров и GFLOPs оказались ненадежными предикторами измеренной задержки вывода. DenseNet-169 и EfficientNetV2-S показали задержки выше, чем архитектуры с сопоставимой или большей теоретической вычислительной стоимостью, что отражает ограниченный аппаратный параллелизм операций с плотными связями и блочной структурой по сравнению с более простыми последовательными свертками. Поэтому выбор архитектуры для развертывания на скорости линии связи должен основываться на непосредственно измеренных задержке и пропускной способности на репрезентативном оборудовании, а не только на количестве параметров или GFLOPs.
-
Использование идентичного протокола обучения для всех архитектур позволяет напрямую и объективно сравнивать производительность в общих условиях, что и является целью данного бенчмарка. Однако производительность при стандартизированном протоколе не следует приравнивать к максимально достижимой производительности каждой архитектуры. Некоторые архитектуры имеют собственное разрешение входных данных, отличающееся от используемых здесь 224 × 224 пикселей, например, 299 × 299 для Xception и 384 × 384 для EfficientNetV2-S, и некоторые архитектуры могут выиграть от использования специфических для каждой архитектуры графиков скорости обучения, стратегий аугментации или более длительного обучения. Поэтому результаты характеризуют производительность каждой архитектуры в идентичных условиях, а не то, насколько хорошо она могла бы работать при индивидуальной оптимизации.
-
Указанные значения задержки и пропускной способности зависят от конкретного оборудования, были измерены на графическом процессоре NVIDIA RTX 3060 в лабораторных условиях и отражают относительные различия между архитектурами, а не пригодность для развертывания на конкретной промышленной линии контроля качества, которая зависит от дополнительных системных факторов, таких как скорость захвата изображения камерой, задержка передачи изображения и пропускная способность конвейера.
4.2. Практические последствия развертывания
-
В тех случаях, когда приоритет отдается точности прогнозирования, EfficientNetV2-S и Xception являются наиболее подходящими кандидатами: их производительность в рамках предметной области была статистически сопоставима, и оба алгоритма были перенесены на pillQC гораздо лучше, чем Swin-B. Измеренная задержка Xception составила примерно одну треть от задержки EfficientNetV2-S (11,86 мс, 33,68 мс).
-
В тех случаях, когда приоритетом является устойчивость к неизвестным планшетам, камерам или условиям съемки, производительность GoogLeNet на разных наборах данных, сопоставимая с EfficientNetV2-S и демонстрирующая наименьшее снижение по сравнению с результатами в своей области, в сочетании с относительно небольшим количеством параметров (5,60 млн) делает его разумным кандидатом, несмотря на более скромную точность в своей области.
-
В тех случаях, когда основным ограничением является объем используемой памяти, как, например, на встроенном оборудовании или оборудовании для контроля периферийных устройств, ShuffleNetV2 (1,26 млн.) и MobileNetV3-small (1,52 млн.) предлагают количество параметров на порядок ниже, чем у большинства эталонных моделей, при умеренной пропускной способности. Однако их обобщающая способность была одной из самых слабых из измеренных (49,44% и 44,83% F1-критерия для разных наборов данных), поэтому не следует предполагать, что это преимущество в объеме используемой памяти сохранится на неизвестных планшетных устройствах или в условиях визуализации. Примечательно, что ни одна из этих архитектур не была самой быстрой на используемом здесь оборудовании: AlexNet, VGG-19 и DLA-34 показали более высокую пропускную способность, поэтому небольшое количество параметров не следует приравнивать к низкой задержке.
-
В соответствии с концепцией, изложенной в Разделе 1 , система, построенная на основе этих результатов, призвана поддерживать, а не заменять человеческое суждение в контроле качества фармацевтической продукции. Таблетки, помеченные как дефектные или классифицированные с низкой степенью достоверности, будут передаваться обученному персоналу для подтверждения, а окончательные решения о дальнейшей судьбе партии и ее выпуске останутся в компетенции квалифицированных специалистов по обеспечению и контролю качества.
4.3. Ограничения
-
Набор данных PV, хотя и разработан с учетом реалистичного разнообразия, остается скромным по масштабу (640 исходных изображений, 1140 после автономной аугментации) по сравнению с наборами данных, используемыми в общем тестировании в области компьютерного зрения. Полученные здесь результаты могут быть не в полной мере применимы к более крупным или более разнообразным линейкам планшетной продукции.
-
Наборы данных для тестирования невелики (200 изображений PV; 43 дефектных изображения pillQC), поэтому 95% доверительные интервалы охватывают ±5 процентных пунктов для точности и ±10 пунктов или более для полноты pillQC ( таблица 9 ). Различия в несколько процентных пунктов между архитектурами находятся в пределах погрешности выборки, и для ранжирования ведущих архитектур потребуется больший, независимо полученный набор данных для тестирования.
-
Каждая архитектура обучалась один раз с фиксированным случайным начальным значением. Доверительные интервалы и парные тесты в разделе 3.3 количественно оценивают неопределенность, возникающую из-за конечного числа тестовых наборов, но не вариации между независимыми запусками обучения, вызванные случайной инициализацией, порядком мини-пакетов и аугментацией. Поэтому небольшие различия между ведущими архитектурами могут частично отражать изменчивость от запуска к запуску и не должны интерпретироваться как окончательный рейтинг.
-
В категорию дефектных изделий входят как естественные производственные дефекты (92 изображения, 28,8%), так и дефекты, внесенные фармацевтами вручную (228 изображений, 71,3%). Дефекты, созданные вручную, могут незначительно отличаться от производственных дефектов, и сообщаемые показатели не позволяют различить эти два типа происхождения.
-
В текущей версии рассматривается только бинарная классификация «нормальное состояние — дефект». Более тонкие различия между типами дефектов (например, сколы, трещины или изменение цвета) в этом тесте не оценивались, хотя процесс аннотирования содержал достаточно информации для поддержки такого расширения в будущих исследованиях.
-
Фиксированный пороговый уровень принятия решения (0,40) был выбран на валидационном наборе данных PV и применен без корректировки к оценке pillQC. Поскольку популяция дефектных образцов и баланс классов в pillQC отличаются от таковых в наборе данных PV, этот фиксированный пороговый уровень может не представлять собой оптимальную рабочую точку именно для pillQC; поэтому результаты, полученные на разных наборах данных, следует интерпретировать как проверку переноса нулевой адаптации, а не как верхнюю границу достижимой производительности на разных наборах данных.
-
Разделение данных проводилось на уровне физической таблетки, и ни одна таблетка не встречается более чем в одном разделе; однако одна и та же группа продуктов может встречаться в нескольких разделах, и поскольку информация о партиях не была записана, нельзя исключить перекрытие на уровне партий. Поэтому модели могут частично выиграть от знакомства с продуктом на уровне отдельных компонентов, и результаты работы в данной области следует интерпретировать соответствующим образом.
-
Межнаборная оценка на pillQC охватывает только структурные дефекты чипового типа и не характеризует возможность обобщения на дефекты типа загрязнения, такие как грязь.
-
Межнаборная оценка проводилась на одном внешнем наборе данных (pillQC), представляющем один таблеточный продукт, одну конфигурацию визуализации и один тип дефекта. Обобщение результатов на различные производственные среды, производственные площадки или системы визуализации невозможно на основе одной внешней оценки, и требуется проверка на дополнительных независимых наборах данных.
-
Представленные результаты отражают производительность в рамках общего стандартизированного протокола и не должны интерпретироваться как максимально достижимая производительность каждой архитектуры. Настройка разрешения входных данных, графика скорости обучения или аугментации для каждой архитектуры может привести к более высокой абсолютной производительности для отдельных моделей.
4.4. Дальнейшая работа
-
Расширение набора данных по фотоэлектрическим системам за счет дополнительных планшетных продуктов, производственных площадок и устройств визуализации позволило бы проверить наблюдаемые здесь закономерности обобщения, в частности, более слабую эффективность архитектуры трансформатора при сравнении данных в разных наборах, в более крупном масштабе.
-
Информация о каждом типе дефекта, сохраняемая в процессе аннотирования, может способствовать расширению набора данных PV за счет многоклассовой классификации, что позволит в дополнение к бинарному скринингу определять местоположение или сегментацию дефектов.
-
Оценка того, устраняет ли небольшая тонкая настройка целевой области или перекалибровка порогового значения разрыв между наборами данных, наблюдаемый на pillQC, позволила бы прояснить, какая часть наблюдаемой потери обобщающей способности обусловлена именно переносом без адаптации, а не более фундаментальным ограничением изученных представлений.
-
Повторное обучение каждой архитектуры с использованием нескольких случайных начальных значений и представление среднего значения ± стандартного отклонения позволило бы количественно оценить изменчивость от запуска к запуску и установить, являются ли различия внутри ведущей группы устойчивыми.
-
Оценка с учетом происхождения дефектов, включающая отдельное представление результатов для естественных и внесенных вручную дефектов, определена как приоритетная задача для будущего выпуска набора данных.
-
В будущих расширениях набора данных следует регистрировать индивидуальные метки, полученные до достижения консенсуса, чтобы обеспечить возможность формального измерения согласованности между экспертами.
5. Выводы
В данном исследовании представлен набор данных PharmaVision (PV), общедоступный эталонный набор данных для бинарной классификации нормальных и дефектных прессованных фармацевтических таблеток, а также эталонная оценка двенадцати архитектур глубокого обучения, охватывающих классические сверточные сети, сети, ориентированные на мобильные устройства, и графические трансформеры. Набор данных объединяет таблетки, сфотографированные во время реального фармацевтического производства, с дефектными таблетками, приготовленными в контролируемых условиях, и был создан с особым вниманием к воспроизводимости: каждое изображение было помечено фармацевтом, проводившим сбор данных, и независимо проверено вторым фармацевтом, а разногласия разрешались путем консенсуса; изображения были разделены на уровне исходной таблетки, чтобы предотвратить утечку между разделениями; и разделения были получены в рамках сеансов, разделенных во времени, чтобы увеличить визуальное разнообразие и дополнительно снизить риск использования общих условий получения данных.
Среди протестированных архитектур EfficientNetV2-S неизменно занимала лидирующие позиции, показав наивысший F1-балл на тестовом наборе PV (88,56%) и F1-балл на наборе pillQC (75,00%), статистически неотличимый от наивысшего (GoogLeNet, 76,19%); однако ее преимущество над другими ведущими архитектурами находилось в пределах погрешности выборки тестовых наборов. Оценка на разных наборах данных выявила существенное и неравномерное ухудшение характеристик разных архитектур: модели Vision Transformer показали наибольшее снижение, несмотря на конкурентоспособные результаты в своей области, а GoogLeNet – наименьшее, несмотря на сравнительно скромную точность в своей области. Поскольку оценка на разных наборах данных проводилась на одном внешнем наборе данных, представляющем один таблеточный продукт и одну конфигурацию визуализации, эти результаты обобщения следует интерпретировать как ориентировочные, а не окончательные, и более широкая валидация в различных производственных средах остается приоритетной задачей для будущих исследований. Анализ эффективности вычислений дополнительно показал, что количество параметров и теоретическая вычислительная стоимость являются ненадежными предикторами измеренной задержки вывода, и что сообщаемые показатели пропускной способности представляют собой теоретические скорости обработки одного изображения, а не сквозную пропускную способность промышленного конвейера; это подчеркивает важность прямого тестирования аппаратного обеспечения при выборе модели для развертывания.
В совокупности эти результаты показывают, что выбор архитектуры для классификации таблеток по нормальным и дефектным образцам не должен основываться только на точности в рамках предметной области или теоретических показателях эффективности, а должен определяться совместно прогнозной производительностью, продемонстрированной обобщающей способностью за пределами обучающей выборки и измеренной эффективностью вывода на репрезентативном оборудовании. Публикуя набор данных PV, связанный с ним код для обучения и оценки, а также этот эталонный набор данных, данное исследование направлено на поддержку воспроизводимой разработки и справедливого сравнения будущих систем контроля качества фармацевтической продукции на основе ИИ, подчеркивая при этом, что такие системы предназначены для поддержки, а не для замены суждений квалифицированного персонала по обеспечению и контролю качества.
Сокращения
- PV — PharmaVision (ФармаВижн)
- AI — Artificial Intelligence (Искусственный интеллект / ИИ)
- CNN — Convolutional Neural Network (Сверточная нейронная сеть / СНС)
- ViT — Vision Transformer (Визуальный трансформер)
- DLA — Deep Layer Aggregation (Глубокое агрегирование слоев)
- QA — Quality Assurance (Обеспечение качества)
- QC — Quality Control (Контроль качества)
- GFLOPs — Giga Floating-Point Operations (Гигафлопс / Миллиард операций с плавающей запятой в секунду)
- FPS — Frames Per Second (Кадры в секунду)
- TP / TN / FP / FN — True Positive / True Negative / False Positive / False Negative (Истинно положительный / Истинно отрицательный / Ложноположительный / Ложноотрицательный)
- GPU — Graphics Processing Unit (Графический процессор / Видеокарта)
- CPU — Central Processing Unit (Центральный процессор / ЦП)
- RAM — Random Access Memory (Оперативная память / ОЗУ)
Литература
- Li, Z.; Ye, G.; Wang, Q.; Sun, C.C.; Fu, Q. Advancing the Understanding of Tablet Capping and Lamination: A Systematical Review. Int. J. Pharm. 2026, 696, 126827. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Rana, A.S.; Hari Kumar, S.L. Manufacturing Defects of Tablets—A review. J. Drug Deliv. Ther. 2013, 3, 200–206. [Google Scholar] [CrossRef] [Scilit]
- Ren, M.; Xu, H.; Zhang, X.; Guan, J.; Mao, S. Evaluation Methods and Strategies to Improve Compression Characteristics of Pharmaceutical Powders. J. Drug Deliv. Sci. Technol. 2024, 100, 106140. [Google Scholar] [CrossRef] [Scilit]
- Barimani, S.; Šibanc, R.; Tomaževič, D.; Meier, R.; Kleinebudde, P. 100% Visual Inspection of Tablets Produced with Continuous Direct Compression and Coating. Int. J. Pharm. 2022, 614, 121465. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Možina, M.; Tomaževič, D.; Pernuš, F.; Likar, B. Real-Time Image Segmentation for Visual Inspection of Pharmaceutical Tablets. Mach. Vis. Appl. 2011, 22, 145–156. [Google Scholar] [CrossRef] [Scilit]
- Bukovec, M.; Špiclin, Ž.; Pernuš, F.; Likar, B. Automated Visual Inspection of Imprinted Pharmaceutical Tablets. Meas. Sci. Technol. 2007, 18, 2921. [Google Scholar] [CrossRef] [Scilit]
- Kim, Y.H.; Nam, S.H.; Hong, S.B.; Park, K.R. GRA-GAN: Generative Adversarial Network for Image Style Transfer of Gender, Race, and Age. Expert Syst. Appl. 2022, 198, 116792. [Google Scholar] [CrossRef] [Scilit]
- Mahmood, T.; Batchuluun, G.; Kim, S.G.; Kim, J.S.; Park, K.R. A Lightweight Hierarchical Feature Fusion Network for Surgical Instrument Segmentation in Internet of Medical Things. Inf. Fusion 2025, 123, 103303. [Google Scholar] [CrossRef] [Scilit]
- Kim, S.H.; Han, S.H. Development of an Intelligent Tablet Press Machine for the In-Line Detection of Defective Tablets Using Machine Learning and Deep Learning Models. Pharmaceutics 2025, 17, 406. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Kim, J.Y.; Choi, D.H. Deep Learning-Based Image Classification and Quantification Models for Tablet Sticking. Int. J. Pharm. 2025, 678, 125690. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Ma, X.; Kittikunakorn, N.; Sorman, B.; Xi, H.; Chen, A.; Marsh, M.; Mongeau, A.; Piché, N.; Williams, R.O.; Skomski, D. Application of Deep Learning Convolutional Neural Networks for Internal Tablet Defect Detection: High Accuracy, Throughput, and Adaptability. J. Pharm. Sci. 2020, 109, 1547–1557. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Wang, G.; Wang, J.; Wu, C.; Yang, H.; Wan, F. SHMNet: A Lightweight Backbone Network with an Auxiliary Branch for Blister Pharmaceutical Detection. Neurocomputing 2026, 699, 134412. [Google Scholar] [CrossRef] [Scilit]
- Iwata, H.; Kumada, S.; Hayashi, Y. Image-Based Estimation of Component Ratios in Pharmaceutical Powders Using Optical Microscopy and Deep Learning. J. Drug Deliv. Sci. Technol. 2026, 115, 107682. [Google Scholar] [CrossRef] [Scilit]
- Quan, H.T.; Huy, D.D.; Hoan, N.T.; Duc, N.T. Deep Learning-Based Automatic Detection of Defective Tablets in Pharmaceutical Manufacturing. In Proceedings of the 8th International Conference on the Development of Biomedical Engineering in Vietnam; Van Toi, V., Nguyen, T.-H., Long, V.B., Huong, H.T.T., Eds.; Springer International Publishing: Cham, Switzerland, 2022; pp. 789–801. [Google Scholar]
- Rački, D.; Tomaževič, D.; Skočaj, D. Detection of Surface Defects on Pharmaceutical Solid Oral Dosage Forms with Convolutional Neural Networks. Neural Comput. Appl. 2022, 34, 631–650. [Google Scholar] [CrossRef] [Scilit]
- Ficzere, M.; Mészáros, L.A.; Kállai-Szabó, N.; Kovács, A.; Antal, I.; Nagy, Z.K.; Galata, D.L. Real-Time Coating Thickness Measurement and Defect Recognition of Film Coated Tablets with Machine Vision and Deep Learning. Int. J. Pharm. 2022, 623, 121957. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Tahirlee. Pharmaceutical Tablet Defect Detection. GitHub. 2026. Available online: https://github.com/tahirlee/pharmaceutical-tablet-defect-detection (accessed on 15 September 2026).
- Samsung Galaxy A35 5G: Specs, Camera & Battery. Available online: https://www.samsung.com/uk/smartphones/galaxy-a/galaxy-a35-5g-awesome-navy-128gb-sm-a356bzkbeub/ (accessed on 21 September 2026).
- Samsung Galaxy A05: Specs (Black, 64GB). Available online: https://www.samsung.com/ph/smartphones/galaxy-a/galaxy-a05-black-64gb-sm-a055fzkdphl/ (accessed on 21 September 2026).
- Lowe, D.G. Distinctive Image Features from Scale-Invariant Keypoints. Int. J. Comput. Vis. 2004, 60, 91–110. [Google Scholar] [CrossRef] [Scilit]
- pillQC Dataset. Available online: https://github.com/matlab-deep-learning/pillQC (accessed on 6 October 2026).
- Krizhevsky, A.; Sutskever, I.; Hinton, G.E. ImageNet Classification with Deep Convolutional Neural Networks. Commun. ACM 2017, 60, 84–90. [Google Scholar] [CrossRef] [Scilit]
- Simonyan, K.; Zisserman, A. Very Deep Convolutional Networks for Large-Scale Image Recognition. arXiv 2014, arXiv:1409.1556. [Google Scholar]
- Szegedy, C.; Liu, W.; Jia, Y.; Sermanet, P.; Reed, S.; Anguelov, D.; Erhan, D.; Vanhoucke, V.; Rabinovich, A. Going Deeper with Convolutions. In Proceedings of the 2015 IEEE Conference on Computer Vision and Pattern Recognition (CVPR), Boston, MA, SUA, 7–12 June 2015; pp. 1–9. [Google Scholar]
- He, K.; Zhang, X.; Ren, S.; Sun, J. Deep Residual Learning for Image Recognition. In Proceedings of the 2016 IEEE Conference on Computer Vision and Pattern Recognition (CVPR), Las Vegas, NV, USA, 27–30 June 2016; pp. 770–778. [Google Scholar]
- Huang, G.; Liu, Z.; Van Der Maaten, L.; Weinberger, K.Q. Densely Connected Convolutional Networks. In Proceedings of the 2017 IEEE Conference on Computer Vision and Pattern Recognition (CVPR), Honolulu, HI, USA, 21–26 July 2017; pp. 2261–2269. [Google Scholar] [CrossRef] [Scilit]
- Chollet, F. Xception: Deep Learning with Depthwise Separable Convolutions. In Proceedings of the 2017 IEEE Conference on Computer Vision and Pattern Recognition (CVPR), Honolulu, HI, USA, 21–26 July 2017; pp. 1800–1807. [Google Scholar]
- Yu, F.; Wang, D.; Shelhamer, E.; Darrell, T. Deep Layer Aggregation. In Proceedings of the 2018 IEEE/CVF Conference on Computer Vision and Pattern Recognition, Salt Lake City, UT, USA, 18–22 June 2018; pp. 2403–2412. [Google Scholar]
- Ma, N.; Zhang, X.; Zheng, H.-T.; Sun, J. ShuffleNet V2: Practical Guidelines for Efficient CNN Architecture Design; Springer: Cham, Switzerland, 2018; pp. 116–131. [Google Scholar]
- Howard, A.; Sandler, M.; Chen, B.; Wang, W.; Chen, L.-C.; Tan, M.; Chu, G.; Vasudevan, V.; Zhu, Y.; Pang, R.; et al. Searching for MobileNetV3. In Proceedings of the 2019 IEEE/CVF International Conference on Computer Vision (ICCV), Seoul, Republic of Korea, 27 October–2 November 2019; pp. 1314–1324. [Google Scholar]
- Tan, M.; Le, Q. EfficientNetV2: Smaller Models and Faster Training. In Proceedings of the 38th International Conference on Machine Learning; PMLR: New York, NY, USA, 2021; pp. 10096–10106. [Google Scholar]
- Dosovitskiy, A.; Beyer, L.; Kolesnikov, A.; Weissenborn, D.; Zhai, X.; Unterthiner, T.; Dehghani, M.; Minderer, M.; Heigold, G.; Gelly, S.; et al. An Image Is Worth 16×16 Words: Transformers for Image Recognition at Scale. arXiv 2020, arXiv:2010.11929. [Google Scholar]
- Liu, Z.; Lin, Y.; Cao, Y.; Hu, H.; Wei, Y.; Zhang, Z.; Lin, S.; Guo, B. Swin Transformer: Hierarchical Vision Transformer Using Shifted Windows. In Proceedings of the 2021 IEEE/CVF International Conference on Computer Vision (ICCV), Montreal, QC, Canada, 10–17 October 2021; pp. 9992–10002. [Google Scholar]
- Deng, J.; Dong, W.; Socher, R.; Li, L.-J.; Li, K.; Fei-Fei, L. ImageNet: A Large-Scale Hierarchical Image Database. In Proceedings of the 2009 IEEE Conference on Computer Vision and Pattern Recognition, Miami, FL, USA, 20–25 June 2009; pp. 248–255. [Google Scholar]
- Kingma, D.P.; Ba, J. Adam: A Method for Stochastic Optimization. Available online: https://arxiv.org/abs/1412.6980v9 (accessed on 13 September 2026).
- Mahmood, T.; Wahid, A.; Hong, J.S.; Kim, S.G.; Park, K.R. A Novel Convolution Transformer-based Network for Histopathology-image Classification Using Adaptive Convolution and Dynamic Attention. Eng. Appl. Artif. Intell. 2024, 135, 108824. [Google Scholar] [CrossRef] [Scilit]
- Haider, A.; Arsalan, M.; Park, C.; Sultan, H.; Park, K.R. Exploring Deep Feature-Blending Capabilities to Assist Glaucoma Screening. Appl. Soft Comput. 2023, 133, 109918. [Google Scholar] [CrossRef] [Scilit]
- Shipway, N.J.; Huthwaite, P.; Lowe, M.J.S.; Barden, T.J. Performance Based Modifications of Random Forest to Perform Automated Defect Detection for Fluorescent Penetrant Inspection. J. Nondestruct. Eval. 2019, 38, 37. [Google Scholar] [CrossRef] [Scilit]
- Paszke, A.; Gross, S.; Massa, F.; Lerer, A.; Bradbury, J.; Chanan, G.; Killeen, T.; Lin, Z.; Gimelshein, N.; Antiga, L.; et al. PyTorch: An Imperative Style, High-Performance Deep Learning Library. In Proceedings of the Advances in Neural Information Processing Systems; Curran Associates, Inc.: Red Hook, NY, USA, 2019; Volume 32. [Google Scholar]
- GeForce GPU. Available online: https://www.nvidia.com/ko-kr/geforce/graphics-cards/compare/ (accessed on 15 September 2026).
- Wilson, E.B. Probable Inference, the Law of Succession, and Statistical Inference. J. Am. Stat. Assoc. 1927, 22, 209–212. [Google Scholar] [CrossRef]
- Brown, L.D.; Cai, T.T.; DasGupta, A. Interval Estimation for a Binomial Proportion. Stat. Sci. 2001, 16, 101–133. [Google Scholar] [CrossRef] [Scilit]
- Efron, B.; Tibshirani, R.J. An Introduction to the Bootstrap; Chapman and Hall/CRC: New York, NY, USA, 1994; ISBN 978-0-429-24659-3. [Google Scholar]
- McNemar, Q. Note on the Sampling Error of the Difference between Correlated Proportions or Percentages. Psychometrika 1947, 12, 153–157. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Dietterich, T.G. Approximate Statistical Tests for Comparing Supervised Classification Learning Algorithms. Neural Comput. 1998, 10, 1895–1923. [Google Scholar] [CrossRef] [Scilit] [PubMed]
- Holm, S. A Simple Sequentially Rejective Multiple Test Procedure. Scand. J. Stat. 1979, 6, 65–70. [Google Scholar]
Авторы: Tahir Mahmood,,Sabi Ur Rehman, Arslan Niamat, Kang Ryoung Park