В данной статье рассматривается эволюция методов компьютерного зрения (Computer Vision, CV) от классических систем, основанных на детерминированных правилах и экспертных признаках (Rule-based CV), до современных архитектур на базе глубокого обучения (Deep Learning, DL). Проведен детальный сравнительный анализ обоих подходов по ключевым критериям: вычислительная сложность, потребность в данных, интерпретируемость («черный ящик») и устойчивость к изменениям среды. Особое внимание уделено концепции гибридных систем (Neuro-symbolic AI), объединяющих надежность правил с обобщающей способностью нейросетей.
Компьютерное зрение прошло путь от простых геометрических преобразований до сложных мультимодальных моделей, способных генерировать текстовое описание видеопотока в реальном времени. Исторически первой парадигмой был подход на основе явных правил, где инженеры вручную проектировали математические операторы для поиска контуров, текстур и форм.
С наступлением «весны глубокого обучения» в 2012 году (после победы архитектуры AlexNet в соревновании ImageNet) фокус сместился в сторону дата-центричного подхода. Нейронные сети начали самостоятельно извлекать иерархии признаков из огромных массивов данных. Сегодня индустрия стоит на пороге синергии этих двух подходов для создания безопасных и объяснимых систем.
Как проверка на основе правил, так и проверка с использованием глубокого обучения полезны, если они соответствуют характеру дефекта. Ошибка заключается в том, чтобы рассматривать принятие решения как публичное соревнование по установлению эталонных показателей, а не как анализ соответствия конкретному сценарию, основанный на базовых показателях самого предприятия.
Компьютерное зрение на основе правил (Rule-based CV)
Принципы функционирования
Классическое компьютерное зрение опирается на детерминированные алгоритмы цифровой обработки сигналов. Вместо обучения на примерах разработчик закладывает в систему жесткую математическую логику: «Если градиент яркости в пикселе (x, y) превышает порог (T), считать этот пиксель частью границы объекта».
Ключевые методы и дескрипторы
- Выделение контуров: Операторы Собеля, Прюитта, Лапласиана и детектор границ Кэнни (Canny edge detector).
- Поиск ключевых точек: Угловой детектор Харриса (Harris Corner Detector).
- Инвариантные дескрипторы признаков:
-
- SIFT (Scale-Invariant Feature Transform): устойчив к масштабированию и вращению.
- SURF (Speeded Up Robust Features): ускоренный аналог SIFT на основе матриц Гессе.
- ORB (Oriented FAST and Rotated BRIEF): быстрая альтернатива для систем реального времени (например, в SLAM).
-
- Преобразование Хафа (Hough Transform): поиск правильных геометрических фигур (линий, окружностей).
Преимущества и ограничения
- Плюсы: Не требуют GPU; работают на процессорах низкой мощности; не нуждаются в обучающих выборках; стопроцентная математическая интерпретируемость.
- Минусы: Экстремальная чувствительность к изменению освещения, ракурса, шума и окклюзии (перекрытию объектов). Неспособность к генерализации.
Компьютерное зрение на основе глубокого обучения (Deep Learning CV)
Парадигма сквозного обучения (End-to-End)
В отличие от классического подхода, глубокое обучение объединяет этапы извлечения признаков (Feature Extraction) и классификации/регрессии в единый вычислительный граф. Сеть оптимизирует свои веса методом обратного распространения ошибки (Backpropagation).
- Классический подход: [Изображение] -> [Ручной выбор признаков (SIFT)] -> [Классификатор (SVM)] -> [Результат]
- Глубокое обучение: [Изображение] -> [ Сквозная нейросеть (CNN / Визуальный Трансформер) ] -> [Результат]
Основные архитектуры
-
- Сверточные нейронные сети (CNN): Использование слоев свертки (Convolution) и пулинга (Pooling) для сохранения пространственной инвариантности. Семейства ResNet, EfficientNet.
- Детекторы объектов: Двухэтапные (Faster R-CNN) и одноэтапные (семейство YOLO, SSD), работающие в режиме реального времени.
- Визуальные трансформеры (ViT): Архитектуры, использующие механизм self-attention (внутреннего внимания) вместо сверток. Демонстрируют превосходное качество на сверхбольших датасетах.
Преимущества и ограничения
- Плюсы: Высочайшая точность, превосходящая человеческие возможности на специфических задачах; устойчивость к шумам и изменению ракурса; адаптивность через дообучение (Transfer Learning).
- Минусы: Проблема «черного ящика» (отсутствие объяснимости решений); критическая зависимость от объема и качества разметки данных; уязвимость к состязательным атакам (Adversarial Attacks).Сравнительный анализ
| Критерий сравнения | Компьютерное зрение на основе правил | Компьютерное зрение на основе DL |
|---|---|---|
| Потребность в данных | Нулевая (достаточно одного тестового кадра) | Критическая (от тысяч до миллионов изображений) |
| Вычислительные ресурсы | Низкие (CPU общего назначения) | Высокие (требуются специализированные GPU/TPU) |
| Интерпретируемость | Полная (детерминированная математика) | Низкая (скрытые слои из миллионов параметров) |
| Время разработки | Высокое (ручной подбор коэффициентов) | Среднее (при наличии готовых датасетов и пайплайнов) |
| Реакция на динамическую среду | Сбой при отклонении от заложенных правил | Высокая адаптивность и обобщение |
Гибридные системы: Нейросимволический подход (Neuro-symbolic AI)
Современный тренд развития CV заключается в объединении двух парадигм. Это позволяет создавать системы, которые точны как DL, но безопасны и предсказуемы как Rule-based алгоритмы.
Примеры интеграции:
- Каскадные системы фильтрации: Классические алгоритмы (например, детекторы контуров) используются для быстрой генерации регионов интереса (ROI), сокращая область поиска для «тяжелой» нейросети.
- Символические ограничения на выходе нейросети: Нейросеть предсказывает координаты объектов, а блок на основе жестких правил (геометрическая физика, логические предикаты) проверяет их на валидность. (Пример: в беспилотных автомобилях нейросеть распознает пешехода, но классический алгоритм физики торможения принимает финальное решение о стоп-линии).
- Инъекция знаний (Knowledge Injection): Использование правил логики предикатов в качестве регуляризаторов функций потерь (Loss function) при обучении нейросетей.
Не превращайте это в технологический конкурс
Контроль качества на основе правил и контроль с использованием глубокого обучения решают разные задачи по обеспечению качества. Система, основанная на правилах, хорошо работает, когда дефект или характеристика могут быть выражены в виде стабильного порогового значения: положение края, наличие отверстия, читаемость штрихкода, допуск по размерам или согласованное правило контраста. Глубокое обучение становится полезным, когда дефект изменяется по форме, текстуре, положению, реакции на освещение или степени тяжести.
Правильный вопрос не в том, что лучше: проверка на основе правил или глубокое обучение. Правильный вопрос в том, какой метод обеспечивает стабильное решение о выпуске для семейства дефектов, с которыми вы столкнулись.
Такой подход, основанный на анализе конкретных сценариев использования, также снижает юридические и логистические риски. Статья не требует сравнения с конкурентами или рейтингов поставщиков. Вместо этого она может оценить собственные режимы отказов предприятия, базовые данные и требования к валидации. Это соответствует Рамочной программе управления рисками в области ИИ NIST (AI RMF) , которая подчеркивает, что системы ИИ должны быть сопоставлены и измерены в контексте, прежде чем ими начнут управлять.
Для системы компьютерного зрения оптимальным решением является контроль дефектов различной степени. Платформа системы компьютерного зрения сочетает в себе захват изображений с сегментацией на основе глубокого обучения и высокоскоростным выводом результатов. Она наиболее актуальна в тех случаях, когда детерминированные рецептуры испытывают трудности с реальными производственными отклонениями.
Вопрос не в том, какой метод окажется более эффективным, а в том, какой тип отказа контролирует каждый из методов.
| Условия проверки | Подгонка на основе правил | Соответствие глубокому обучению |
|---|---|---|
| Характеристика является фиксированной и измеримой. | Плотная посадка | Обычно это не требуется, если контекст не сложный. |
| Дефекты, проявляющиеся в изменении формы в зависимости от партии или процесса, могут быть вызваны другими дефектами. | Слабое соответствие | Подходит при наличии достаточного количества примеров и подтверждений. |
| Реакция освещения непостоянна. | Требуется перепроектирование оптической системы. | Помощь может быть оказана только после стабилизации сигнала при визуализации. |
| Для обеспечения качества необходим объяснимый пороговый уровень. | Плотная посадка | Требуется предоставление примеров, масок, проверка достоверности и соблюдение правил публикации. |
| Частая смена режимов работы | Может потребоваться программирование рецептов. | Подходит, если процесс сбора данных и обновления модели контролируется. |
Используйте изменчивость дефектов в качестве первого критерия принятия решения
Контроль на основе правил эффективен, когда объект стабилен. Если необходимо наличие контактного штифта, открытого отверстия для прокладки или чтобы обработанная кромка оставалась в пределах допустимого диапазона, детерминированная логика может быть простой, контролируемой и быстрой. Модель глубокого обучения может усложнить процесс, не улучшив при этом решение о выпуске.
Изменчивость меняет ситуацию. Царапины могут появляться под разными углами. Заусенцы могут следовать по неровным краям. Пятна могут иметь цвет, совпадающий с цветом обычной текстуры. Дефекты сварных швов могут различаться по форме, контрасту и местоположению. В таких случаях контроль, основанный на правилах, часто превращается в лоскутное одеяло из исключений. Каждое исключение может исправить один набор изображений, одновременно создавая новое ложное отклонение для другого.
Системы компьютерного зрения разработаны именно для решения задач, связанных с распознаванием дефектов различной степени тяжести. Он поддерживает сегментацию на основе глубокого обучения, классификацию на уровне пикселей и многозадачное обнаружение. Практическая ценность заключается не в том, что ИИ заменяет все правила, а в том, что предприятие может перейти от распознавания дефектов различной степени тяжести к сегментации на основе данных.
Методы проверки различаются для каждого из них
Проверка на основе правил проверяет, остаются ли пороговое значение, область интереса и условия освещения стабильными в разных партиях, сменах и при использовании различных приспособлений. Проверка с помощью глубокого обучения проверяет, обобщает ли модель результаты на репрезентативные детали, соответствующие требованиям, детали, соответствующие истинным отклонениям, пограничные образцы и производственные отклонения. Оба метода терпят неудачу, если набор данных для проверки слишком узок.
Команде по обеспечению качества следует перенять подход ASQ, основанный на оценке стоимости качества. Метод, снижающий затраты на оценку, но увеличивающий затраты на внешние сбои, не является лучшей системой. Метод, выявляющий больше дефектов, но создающий неприемлемый избыток, также может оказаться финансово неэффективным. В оценочную таблицу валидации следует включить коэффициент ложных приемок (FA), коэффициент ложных отказов (FR), время цикла (CT), нагрузку на проверку и трудозатраты на обновление.
Для смешанных сценариев использования гибридная архитектура часто является наиболее эффективным решением. Детерминированные правила могут обрабатывать проверку наличия, измерения и штрихкодов, в то время как глубокое обучение обрабатывает дефекты поверхности, загрязнения или вариации формы. Предприятие не должно привязывать все решения по контролю к одному методу.
Практическое тестирование соответствия сценариям использования
Начните с 50-100 недавних примеров из семейства дефектов. Попросите инженера написать простое визуальное правило. Если правило короткое, стабильное и работает в разных партиях, то может подойти контроль на основе правил. Если же правило превращается в длинный список исключений, следует оценить возможности глубокого обучения.
Затем задайте обратный вопрос: может ли предприятие предоставить достаточно примеров и правил выпуска для проверки модели глубокого обучения? Если нет, соберите больше данных о работе в производственной среде, прежде чем принимать решение об использовании ИИ.
Используйте системы компьютерного зрения, когда изменчивость является узким местом
Покупателю следует рассмотреть UnitX, если проблема с контролем качества имеет три признака: дефекты различаются, линия не может замедлиться для ручной проверки, и команде контроля качества необходима прослеживаемость производства. В этом случае системы компьютерного зрения можгут улучшить качество изображений и запустить модель контроля качества на основе ИИ на производственной скорости.
Если ваш текущий рецепт становится всё более уязвимым с каждым изменением продукта, отправьте в последние изображения OK и NG, определения CT, FA и FR, а также правила отклонения для анализа соответствия практическому применению . Полезный результат — это не просто утверждение об использовании ИИ. Это рекомендация о том, следует ли оставить дефект на основе правил, перейти к глубокому обучению или использовать гибридный контрольный механизм.
Наиболее надежная схема контроля является нейтральной к методу до тех пор, пока дефект не покажет, какой метод необходим.
Как определить, когда оправдан гибридный подход
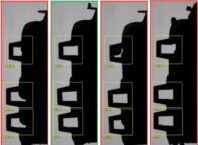
Гибридная схема контроля оправдана, когда на одной и той же станции требуются как детерминированные, так и переменные решения. Например, задача контроля разъемов может потребовать детерминированных проверок количества контактов и сегментации с помощью глубокого обучения для выявления изогнутых, поцарапанных или загрязненных участков. Принудительное выполнение всей задачи одним методом может затруднить проверку системы.
Слой, основанный на правилах, должен обрабатывать решения, которые команды контроля качества могут определить как стабильную геометрию или фиксированные пороговые значения. Слой глубокого обучения должен обрабатывать визуальную неоднозначность, которая не поддается обработке стабильными правилами. Передача данных между слоями должна быть четкой. Если детерминированный контрольный механизм не срабатывает, отбраковывается ли деталь немедленно или результат ИИ все еще имеет значение? Если ИИ обнаруживает пограничный дефект, отбраковывает ли, перенаправляет или отправляет деталь на проверку программируемый логический контроллер (ПЛК)?
Гибридные системы также нуждаются в ограничениях на техническое обслуживание. Изменение правил может потребовать утверждения рецепта. Обновление модели может потребовать проверки набора данных, изображений для проверки и контроля версий. Когда эти два пути обновления смешиваются без указания ответственных лиц, предприятие может потерять отслеживаемость. Поэтому при принятии решения о выборе метода следует учитывать, кто является владельцем каждого слоя после приемочных испытаний на объекте (SAT).
В проектах по созданию системы компьютерного зрения следует оценивать гибридную архитектуру, когда логика, основанная на правилах, все еще имеет ценность, но узким местом являются переменные дефекты. В результате получается не компромисс, а более чистая архитектура контроля: детерминированные проверки для детерминированных проблем, глубокое обучение для переменных визуальных доказательств и одно правило выпуска, которое может быть проверено отделом качества.
| Слой | Наиболее подходит для | Артефакт проверки |
|---|---|---|
| основанный на правилах | Проверка наличия, размеры, фиксированные пороговые значения, считывание штрихкодов | Рецепт, пороговая запись и эталонный набор образцов. |
| Глубинное обучение | Царапины, пятна, заусенцы, загрязнения и неправильная геометрия. | Примеры с маркировкой, контрольная выборка и отчет FA/FR. |
| решение ПЛК | Отклонить, перенаправить, приостановить или передать действия | Журнал проверки синхронизации и отслеживания деталей |
| Проверка качества | Пограничные или новые классы дефектов | Правило эскалации и обновление записи об утверждении |
Что следует задокументировать при принятии решения о пригодности метода?
В окончательном решении о пригодности метода следует объяснить, почему каждое решение по проверке основано на правилах, глубоком обучении или является гибридным. Сохраните примеры дефектов, логику пороговых значений, размеченные примеры, контрольную выборку и правила выпуска. Это важно, поскольку будущие изменения процесса могут сделать ранее стабильное правило ненадежным или создать новый класс дефектов, требующий поддержки модели.
При передаче данных также следует определить процедуры эскалации. Если результаты проверки на основе правил и глубокого обучения не совпадают, система должна иметь четкое действие: отклонить, перенаправить, приостановить или отправить на проверку. Без такого правила гибридная система может превратиться в два конкурирующих мнения вместо одного проверяемого решения о качестве.
Данная документация также помогает в дальнейшем устранении неполадок. При повышении уровня FR или появлении нового события выхода из системы инженеры могут определить, связана ли проблема с обработкой изображений, правилами, данными модели или окончательным решением ПЛК.
Стандарты доказательной базы, используемые в данном руководстве
В данной статье отсутствуют данные о рейтингах поставщиков и таблицы данных о конкурентах. Приведенные ниже внешние ссылки используются только в тех случаях, когда они подтверждают конкретное правило принятия решения, границу проверки, требование к интеграции или модель затрат.
| Источник | Как это используется |
|---|---|
| Структура управления рисками в области искусственного интеллекта NIST (AI RMF) | Поддерживает принятие решений по оценке рисков и проверке ИИ с учетом контекста. |
| Стоимость качества ASQ | Это позволяет связать выбор метода с затратами на устранение неполадок, избыточностью и риском выпуска продукта. |
| NIST гарантия качества производства | Поддерживает отслеживаемые измерения и мониторинг производства. |
| EMVA 1288 | Подтверждает тезис о том, что визуальные доказательства должны быть измеримыми, прежде чем выбирать метод. |
| ИСА-95 | Подтверждает необходимость увязывания решений по проведению инспекций с операционными системами. |
Прикладные области применения: специфика внедрения и интеграции подходов
Интеграция систем компьютерного зрения на основе правил и глубокого обучения варьируется в зависимости от требований конкретной отрасли к безопасности, вычислительной мощности и точности.
Медицинская диагностика и анализ изображений (MedTech)
В медицинском компьютерном зрении (анализ КТ, МРТ, рентгеновских снимков и гистологии) цена ошибки нейросети критически высока. Поэтому здесь доминирует жесткий двухконтурный контроль.
- Роль глубокого обучения: Сегментация аномалий (сверточные сети вроде U-Net) и классификация опухолей. DL-модели способны улавливать микроструктурные изменения ткани, невидимые для человеческого глаза и классических фильтров.
- Роль алгоритмов на основе правил: Валидация и анатомический контроль. Классические геометрические алгоритмы проверяют топологическую корректность сегментированного органа. Например, если нейросеть обнаружила «печень» в грудной клетке или сегментировала изолированные «островки» опухоли там, где их физически быть не может, система на основе правил блокирует выдачу результата и отправляет снимок на ручной пересмотр. Также классические методы (преобразование Радона) используются на этапе реконструкции самого сырого сигнала с томографа.
- Эффект синергии: Минимизация ложноположительных срабатываний (False Positives) и обеспечение стопроцентной интерпретируемости границ анатомических зон для хирургического планирования.
Робототехника и промышленная автоматизация (Industrial Vision)
На заводах и роботизированных складах условия среды (освещение, геометрия объектов) часто можно жестко контролировать, что накладывает свой отпечаток на выбор архитектуры.
- Роль алгоритмов на основе правил: Прецизионное измерение габаритов и калибровка. Для контроля дефектов микросхем или точности нарезки деталей используются детекторы Кэнни, операторы Собеля и субпиксельный поиск контуров. Эти методы дают субмиллиметровую точность и работают на частоте в сотни кадров в секунду на дешевых микроконтроллерах. Манипуляторы используют классический алгоритм сопоставления шаблонов (Template Matching) для захвата однотипных деталей с конвейера.
- Роль глубокого обучения: Работа в неструктурированной среде и “Bin Picking” (вытаскивание разнородных предметов из хаотично заполненной коробки). Нейросети (например, Mask R-CNN) распознают ориентацию случайно брошенных предметов сложной формы, оценивают степень их перекрытия друг другом и определяют оптимальную точку захвата для вакуумного или механического манипулятора.
- Эффект синергии: Нейросеть отвечает за высокоуровневое понимание сцены («что лежит и как повернуто»), а классический алгоритм — за финальное точное позиционирование роборуки с точностью до микрона и расчет кинематики без столкновений.
Беспилотные летательные аппараты (БПЛА) и автономный транспорт
В авиационных и автомобильных автономных системах ключевыми факторами являются ограничения по энергопотреблению (Edge Computing) и работа в режиме экстремального реального времени (Low Latency).
- Роль глубокого обучения: Семантическая сегментация дорожного полотна / подстилающей поверхности, детекция динамических объектов (пешеходов, других дронов, автомобилей) с помощью легковесных моделей вроде YOLO или MobileNet. DL-модели незаменимы для предсказания траектории движения объектов на основе их визуального поведения.
- Роль алгоритмов на основе правил: Навигация и выживание системы. В условиях подавления сигналов GPS/ГЛОНАСС БПЛА полагаются на алгоритмы оптического потока (Lucas-Kanade) и визуальную одометрию (VIO / VSLAM на базе дескрипторов ORB/FAST). Классическая математика жестко связывает смещение пикселей с физическим перемещением аппарата в пространстве. Более того, контур безопасности (Safety Kernel) пилотирования всегда пишется на основе детерминированных правил: если нейросеть «ошиблась» и не заметила провод, но радар или классический детектор линий зафиксировал препятствие на критической дистанции, дрон совершает автоматический отворот.
- Эффект синергии: DL обеспечивает ситуационную осведомленность коммерческого уровня, в то время как жесткие правила гарантируют отказоустойчивость (Fail-Safe) при деградации нейросетевых моделей в условиях тумана, дождя или засветки камеры.
Основные выводы
- Проверка на основе правил подходит для стабильных, измеримых характеристик. Глубокое обучение подходит для вариативных проявлений дефектов.
- Наилучшим методом является тот, который обеспечивает стабильное решение о выпуске продукта для данного семейства дефектов.
- Гибридный подход к инспекции зачастую оказывается более эффективным, чем принятие всех решений с использованием одного метода.
- Валидация должна включать проверку на ложное принятие (FA), ложное отклонение (FR), время цикла (CT) и нагрузку на поддержание модели или правил.
Часто задаваемые вопросы
1. Можно ли полностью отказаться от классического CV в пользу глубокого обучения?
Нет, нельзя. Даже в самых современных нейросетевых пайплайнах классические методы используются на этапе предобработки (изменение размера, нормализация яркости, фильтрация шумов Гауссом) и постобработки (аппроксимация контуров, подавление немаксимумов — NMS). Кроме того, для задач калибровки камер и геометрии (например, сшивка панорам) классическая математика до сих пор эффективнее и точнее нейросетей.
2. Что делать, если для обучения нейросети нет готового датасета?
В такой ситуации применяют три основные стратегии:
- Использование Rule-based CV для авторазметки: Сначала пишется строгий алгоритм на правилах. Пусть он ошибается в 30% сложных случаев, но он сможет быстро разметить тысячи простых изображений. Полученный датасет затем вручную корректируется и используется для обучения DL-модели.
- Синтез данных: Создание 3D-моделей объектов и генерация сотен тысяч их изображений в игровых движках (Unreal Engine, Unity) с автоматической идеальной разметкой.
- Few-shot / Zero-shot learning: Использование предобученных на гигантских массивах данных моделей (например, CLIP от OpenAI), которые могут распознавать объекты по текстовому описанию вообще без дообучения.
3. Почему нейросети называют «черным ящиком» и чем это опасно?
В классическом CV вы можете открыть код и увидеть, что система нашла объект, потому что угол равен 90 градусам, а контраст выше 120. В глубоком обучении решение принимается на основе распределения весов среди миллионов нейронов.
Опасность заключается в непредсказуемых сбоях. Например, нейросеть может классифицировать опухоль на рентгене не по форме ткани, а потому что на снимках из этой больницы в углу стоял определенный штамп врача (эффект «умного Ганса»). Без методов объяснимого ИИ (XAI, таких как Grad-CAM) невозможно понять, на что именно смотрит сеть.
4. Каковы требования к железу для обоих подходов?
- На основе правил: Минимальные. Алгоритмы могут работать в реальном времени на обычных центральных процессорах (CPU) общего назначения, микроконтроллерах (STM32, ESP32) и сигнальных процессорах (DSP).
- На основе глубокого обучения: Для этапа обучения критически необходимы мощные графические ускорители (накопители тензорных ядер вроде NVIDIA H100, A100). Для этапа вывода (Inference) на конечных устройствах (смартфоны, дроны) требуются специализированные нейропроцессоры (NPU) или одноплатные компьютеры (NVIDIA Jetson).
5. Что такое состязательная атака (Adversarial Attack) на нейросеть?
Это способ обмана нейросети путем внесения в изображение минимального, незаметного для человека шума (пертурбации). Например, если на дорожный знак «Stop» наклеить несколько определенным образом рассчитанных черно-белых квадратов, человек все равно безошибочно узнает знак, а автопилот на базе DL может классифицировать его как «Ограничение скорости 80 км/ч». Классические алгоритмы на основе геометрии к таким атакам устойчивы.
Заключение
В рамках проведенного исследования был выполнен детальный сравнительный анализ двух фундаментальных парадигм компьютерного зрения таких как: детерминированного подхода на основе правил (Rule-based CV) и дата-центричного подхода на основе глубокого обучения (Deep Learning). Эволюция технологий показала, что ни одна из этих концепций в отдельности не способна полностью закрыть потребности современных высокотехнологичных отраслей.
Классические алгоритмы, опирающиеся на жесткую математическую логику и дескрипторы (SIFT, ORB, Canny), остаются непревзойденными в условиях ограниченных вычислительных ресурсов, при дефиците обучающих выборок, а также там, где требуется абсолютная математическая точность и верифицируемость (калибровка оптических систем, субпиксельная дефектоскопия). Однако их критическая уязвимость к вариативности внешней среды делает их неприменимыми для анализа неструктурированных сцен. В свою очередь, глубокое обучение продемонстрировало революционные результаты в распознавании сложных паттернов, семантической сегментации и работе в динамических условиях, но столкнулось с фундаментальными барьерами: проблемой «черного ящика», уязвимостью к состязательным атакам и колоссальной ресурсоемкостью.
Проведенный анализ прикладных областей (медицина, робототехника, БПЛА) наглядно иллюстрирует, что наиболее жизнеспособным вектором развития индустрии является гибридизация подходов. Интеграция эмпирической силы нейросетей со строгими логическими ограничениями экспертных систем (нейросимволический ИИ) позволяет нивелировать недостатки обеих парадигм. В таких системах глубокое обучение берет на себя задачу высокоуровневого восприятия и аппроксимации функций, а алгоритмы на основе правил выступают в роли «контура безопасности» (Safety Kernel), интерпретируемого валидатора и инструмента финального прецизионного позиционирования.
Таким образом, дальнейший прогресс в области компьютерного зрения лежит не в плоскости конкуренции или полного вытеснения классических методов нейросетевыми архитектурами, а в создании синергетических сквозных систем. Разработка стандартизированных фреймворков для бесшовной интеграции символьной логики в градиентные вычислительные графы нейросетей является приоритетной задачей для академического и инженерного сообществ на ближайшее десятилетие.