


Искусственный интеллект все чаще используется в пивоварении, однако литература по этой теме охватывает различные области: пивоваренные технологии, качество пищевых продуктов, технологическое проектирование и анализ данных. В данном обзоре обобщены 188 публикаций по применению ИИ в пивоварении (176 первичных исследований и 12 обзоров), выявленных в результате поиска в семи библиографических базах данных и вручную проверенных на релевантность по четко сформулированному критерию того, что считается применением ИИ.
Исследования характеризовались фазой пивоварения, формой данных, вычислительным подходом и задачей и сопоставляются здесь с фазой пивоварения и основным используемым вычислительным подходом. Обзор показывает, что применение ИИ распределено неравномерно по всему процессу пивоварения. Наиболее изученными областями являются обеспечение качества и ферментация, в то время как розлив, планирование производства и оценка сырья представлены реже.
Нейронные сети особенно распространены в моделировании ферментации, где они используются для оценки состояния, прогнозирования, управления и оптимизации. Компьютерное зрение в основном применяется к сырью, розливу, пене, цвету и контролю качества продукции. Данные электронного носа и спектроскопические данные, интерпретированные с помощью хемометрических моделей и моделей машинного обучения, поддерживают аутентификацию пива, обнаружение дефектов, прогнозирование органолептических свойств и классификацию качества.
Системы Индустрии 4.0 и цифровые двойники обеспечивают инфраструктуру для сбора данных в масштабах всего процесса, планирования и оценки устойчивости. В целом, ИИ в пивоварении лучше всего понимать как набор инструментов, специфичных для каждого этапа, а не как единую технологию. Более широкое внедрение в промышленности потребует проверенных наборов данных, надежных датчиков, интерпретируемых моделей и интеграции с рутинными операциями пивоваренных заводов.
1. Введение
Пивоварение — это традиционный процесс производства продуктов питания и напитков, но он никогда не был простым. Он объединяет изменчивость сырья, биологическое брожение, тепло- и массообмен, операции очистки, упаковку, логистику и органолептические качества в единую производственную цепочку. Этот процесс также имеет долгую научную историю. Работа Луи Пастера о пиве связала пивоварение с микробиологией, контролем брожения и предотвращением загрязнения [1]. Более поздняя промышленная литература по пивоварению уже рассматривала отходы, потери и неэффективную работу как технические проблемы, заслуживающие систематического изучения; работа Хартли XIX века о расточительности в пивоварении является ранним примером этой перспективы [2]. В этом смысле современное пивоварение, основанное на данных, продолжает гораздо более старую тенденцию: измерять, понимать и улучшать сложный процесс.
Современные пивоварни сталкиваются с этими проблемами в значительно большем масштабе данных и принятия решений. Пивовар должен контролировать качество солода, хмеля, воды и дрожжей; управлять затиранием, фильтрацией, кипячением, охлаждением, брожением, созреванием, фильтрацией и розливом; и поддерживать стабильность качества продукции в разных партиях. В то же время пивоварни должны сокращать потребление энергии и воды, предотвращать потери, управлять производственными графиками и реагировать на разнообразные ожидания потребителей. Эти требования не ограничиваются крупными промышленными предприятиями. Крафтовые и микропивоварни часто производят множество сортов пива с ограниченной вместимостью резервуаров, небольшими командами и менее формализованной инфраструктурой данных. Для них способность эффективно использовать данные может напрямую влиять на стабильность качества, производительность и экономическую целесообразность.
Искусственный интеллект актуален для пивоварения, поскольку многие решения на пивоварнях зависят от сложных данных, которые трудно интерпретировать вручную. Изображения ячменя, хмеля, бутылок, пены или дрожжевых клеток могут использоваться для контроля и классификации. Спектры, сигналы электронного носа, сигналы электронного языка и химические отпечатки могут использоваться для обнаружения дефектов, аутентификации продукции или оценки качественных характеристик. Данные временных рядов брожения могут использоваться для прогнозирования плотности, концентрации алкоголя, фазы процесса или ожидаемого времени завершения. Производственные данные могут поддерживать планирование, распределение ресурсов и управление энергопотреблением. Эти задачи соответствуют практическим вопросам пивоварения: подходит ли сырье, нормально ли протекает брожение, является ли бутылка дефектной, соответствует ли пиво заявленному стилю или осуществим ли производственный план.
Последние достижения в области искусственного интеллекта (ИИ) расширили спектр методов, основанных на данных, применимых к этим задачам. Глубокое обучение улучшило моделирование изображений, сигналов и сложных нелинейных взаимосвязей [3]. В медицине ИИ часто представляют не как замену экспертной оценке, а как инструмент для поддержки диагностики, прогнозирования и принятия решений в условиях неопределенности [4]. Такое же различие актуально и в пивоварении. ИИ не следует понимать как замену знаниям пивоварения. Его практическая роль заключается в преобразовании технологических, лабораторных, визуальных, сенсорных и производственных данных в информацию, которая может помочь пивоварам, технологам и сотрудникам отдела контроля качества.
Пищевая промышленность предоставляет естественный контекст для этого развития. Недавние обзоры машинного обучения в автоматизированной обработке пищевых продуктов описывают применение в рецептуре, управлении процессами, оценке качества продукции и адаптивных производственных системах [5]. Более широкие дискуссии об ИИ в пищевой промышленности также подчеркивают рецептуру, обработку, понимание потребностей потребителей, устойчивость и необходимость интероперабельных данных и интерпретируемых моделей [6]. Аналогичные тенденции наблюдаются в виноделии, где ИИ рассматривался в контексте виноградарства, ферментации, розлива, отслеживаемости, безопасности и контроля качества [7]. Пивоварение сталкивается со многими из этих проблем, но также имеет свою собственную структуру процесса, сырье, характеристики ферментации, форматы упаковки и ожидания в отношении качества.
Внедрение ИИ в промышленности также связано с повышением эффективности и качества продукции. Отчеты об использовании ИИ на предприятиях указывают на возможное повышение производительности и снижение количества дефектов при эффективном внедрении ИИ [8]. Для пивоварен это особенно актуально, поскольку дефекты, задержки, неправильное распределение резервуаров, потери энергии и непостоянное качество могут иметь немедленные экономические последствия. Однако внедрение не происходит автоматически. Системы ИИ требуют надежных датчиков, репрезентативных наборов данных, проверки, интеграции с существующим оборудованием и достаточной интерпретируемости, чтобы им можно было доверять в производстве. Эти требования имеют центральное значение в пищевой промышленности, где решения влияют на безопасность, качество, стоимость и принятие потребителями.
В предыдущих обзорах уже обсуждались интеллектуальные технологии [9], машинное обучение [10] и общее влияние ИИ на пивоварение [11]. Эти обзоры указывают на растущую исследовательскую активность в области методов, связанных с ИИ, в пивоварении. Однако эта область разнообразна, и применение ИИ в пивоварении сильно зависит от процесса. Например, классификация сортов хмеля на основе изображений решает другую задачу, чем прогнозирование динамики брожения на основе LSTM, обнаружение дефектов на основе электронного носа или планирование производства с использованием цифровых двойников. Поэтому необходим обзор, ориентированный на процесс, чтобы показать, где используется ИИ, какие данные он требует и какие технологические решения он поддерживает.
В данной статье рассматриваются приложения искусственного интеллекта в пивоварении с точки зрения процессного подхода. После краткого введения в пивоварение и концепции ИИ, необходимые для понимания рассмотренной литературы, в работе анализируются 188 публикаций по всей цепочке пивоварения. Исследования обсуждаются в контексте общих технологических применений, сырья и лабораторных работ, планирования и подготовки, затирания, фильтрации, кипячения и охлаждения, ферментации, розлива и контроля качества. Такая структура рассматривает приложения, связанные с ИИ, не как единую технологию, а как набор вычислительных подходов, которые могут поддерживать конкретные задачи пивоварения при условии их связи с соответствующими данными, знаниями о процессе и валидацией.
1.1. Введение в пивоварение
1.1.1. Хранение сырья
В литературе по пивоварению сравнительно мало внимания уделяется хранению сырья. Именно на этом этапе сырье поступает на пивоваренный завод и проходит первоначальный контроль качества. Работники склада проверяют, не повреждена ли упаковка, и убеждаются, что все необходимые материалы, такие как дрожжи, солод, хмель, бутылки, этикетки и другие принадлежности, поступили в требуемом количестве и соответствуют соответствующим требованиям качества.
Дрожжи и хмель следует хранить в прохладных, сухих условиях, чтобы сохранить их качество и ограничить потерю аромата. Солод следует хранить в сухих, хорошо проветриваемых условиях, чтобы снизить риск образования плесени и заражения вредителями [12, 13].
1.1.2. Пивоварня
Пивоварня — это технологическая зона, в которой сусло готовится к ферментации. Операции, проводимые в пивоварне, также называются горячей стороной процесса [14]. Процесс пивоварения начинается с помола солода, в ходе которого шелуха отделяется от эндосперма. Шелуха служит фильтрующим средством во время фильтрации, а эндосперм содержит крахмал и ферменты, необходимые для гидролиза полисахаридов.
Процесс измельчения следует контролировать, чтобы обеспечить качество солода. Даже небольшое изменение в работе вальцовой мельницы может вызвать проблемы во время затирания или фильтрации [13]. Солод переносится в заторный резервуар, где он смешивается с водой и нагревается до температуры, подходящей для ферментативной активности. В ходе этого процесса образуется богатый сахарами раствор, называемый суслом.
В процессе затирания необходимо контролировать температуру и перемешивание для поддержания однородных условий процесса. На следующем этапе сусло отделяется от затора во время фильтрации. На этом этапе следует контролировать мутность фильтрата, параметры промывочной воды и температуру затора. Мутность дает информацию о качестве фильтрации, в то время как параметры промывочной воды и температура влияют на продолжительность процесса [15].
Отфильтрованное сусло кипятят с хмелем для извлечения соединений, ответственных за аромат и горечь пива. Во время кипячения сусла температура влияет на изомеризацию соединений хмеля в водорастворимые изомеры [16]. Также следует контролировать пенообразование, поскольку чрезмерное пенообразование может способствовать всплыванию частиц хмеля и их осаждению на стенках кипятильного сосуда.
Наконец, горячий осадок отделяется от сусла, как правило, путем вихревого перемешивания, после чего сусло охлаждается [17, 18]. На этом этапе процесса необходимо контролировать температуру и мутность сусла, чтобы горячий осадок не попал в бродильный резервуар.
1.1.3. Помещение для брожения
В зоне брожения охлажденное сусло инокулируют дрожжами и сбраживают пиво. Эта часть пивоварни также называется холодной стороной процесса [14]. Брожение начинается с внесения дрожжей в охлажденное сусло, что знаменует начало брожения. В зависимости от штамма дрожжей и стиля пива процесс проводится при температурах от 2 °C для некоторых слабоалкогольных сортов пива, до 8 °C-15 °C для пива низового брожения и до 28 °C для элей [18, 19].
В процессе брожения дрожжи метаболизируют углеводы в углекислый газ и этанол. В ходе брожения также образуется множество вторичных метаболитов, которые влияют на конечный аромат и вкусовой профиль [20, 21]. В этой части пивоварни необходимо контролировать состояние дрожжей и температуру. Плохое состояние дрожжей или неподходящая температура брожения могут привести к появлению нежелательных посторонних привкусов и изменению кинетики брожения.
После первичного брожения происходит созревание, длящееся от нескольких недель до нескольких месяцев. В течение этого этапа остаточные сбраживаемые сахара могут метаболизироваться, пиво насыщается углекислым газом, а осветление происходит путем осаждения. Созревшее пиво затем готово к переливу в конечную часть пивоварни [22]. Во время созревания температура обычно поддерживается в пределах от 1 °C до 5 °C.
Процессы ферментации требуют контроля состояния дрожжей, риска загрязнения, температуры и эффективности очистки.
1.1.4. Наполнение и хранение
Готовое пиво может быть отфильтровано в зависимости от технических характеристик продукта. При осветлении необходимо контролировать мутность пива. Затем пиво разливают в кеги, бутылки или банки. Условия упаковки напрямую влияют на качество продукта и срок годности. Правильно заполненные емкости помогают предотвратить загрязнение и окисление [23]. Как загрязнение, так и проникновение кислорода могут ускорить ухудшение качества.
Упакованное пиво следует проверять на уровень наполнения, целостность крышек, а также на наличие повреждений этикетки. Наконец, пиво хранится и отправляется потребителям. Работники, ответственные за розлив и хранение, уделяют внимание качеству процедур упаковки пива, обслуживанию линии розлива, условиям хранения и соответствующим мероприятиям по контролю качества.
1.1.5. Научные подходы к оптимизации процесса пивоварения
Контроль этих операций способствует повышению качества конечного продукта и стабильности процесса. Соответственно, в пивоваренной науке давно применяются методы микробиологии, химии, термодинамики и прикладной математики для мониторинга и оптимизации процесса [24].
Ферментация особенно широко изучалась с помощью методов моделирования и оптимизации, главным образом потому, что это один из самых длительных процессов в пивоварении. На крупных пивоварнях даже небольшая экономия времени может принести значительную экономическую выгоду. Например, Драгоне и др. смоделировали высокогравитационную ферментацию пива с использованием методологии поверхности отклика [25]. Макинтош и др. описали кинетику субстрата и продукта во время ферментации пива, особенно с помощью измерений выделения углекислого газа для мониторинга процесса ферментации [26]. Кухарчик и др. исследовали оптимизацию параметров ферментации для регулирования роста дрожжей и жизнеспособности клеток [27].
Методы, основанные на данных и искусственном интеллекте, предоставляют дополнительные подходы к мониторингу, прогнозированию, оптимизации и управлению процессами. В следующем подразделе будет представлена терминология, используемая для описания этих методов в данном обзоре.
1.2. Введение в искусственный интеллект
В этом подразделе представлены концепции и терминология искусственного интеллекта (ИИ), необходимые для чтения литературы, рассмотренной в Разделе 3. Он намеренно носит общий характер: цель состоит в том, чтобы объяснить, что представляют собой методы и как они работают, а не где они применялись в пивоварении, что является темой последующих разделов. Читатели, уже знакомые с машинным обучением, могут перейти к Разделу 2 .
Искусственный интеллект (ИИ) здесь используется как общий термин для вычислительных подходов, поддерживающих прогнозирование, классификацию, оптимизацию, управление или поддержку принятия решений в задачах, которые в противном случае потребовали бы экспертных знаний человека. Единого общепринятого определения этого термина нет, и его сфера применения со временем менялась. Для целей данного обзора более полезно характеризовать ИИ по выполняемым им задачам. Пять из них повторяются. Прогнозирование (регрессия) оценивает непрерывную величину. Классификация присваивает объекту одну из нескольких дискретных категорий. Оптимизация ищет настройки системы, которые наилучшим образом удовлетворяют заданной цели. Управление определяет, как система должна управляться во времени в ответ на ее измеренное или оцененное состояние. Поддержка принятия решений представляет результаты вышеописанных процессов в форме, доступной для человека. Большинство описанных ниже подходов служат одной или нескольким из этих задач.
1.2.1. Машинное обучение
Машинное обучение — это раздел ИИ, в котором модель не программируется с помощью явных правил, а вместо этого изучает отображение на основе примеров [28, 29]. Это контрастирует с механистическим моделированием, где поведение системы выводится из первых принципов и выражается в виде уравнений. Брейман описал их как две различные культуры моделирования: одна предполагает механизм генерации данных и оценивает его параметры, а другая рассматривает механизм как неизвестный и стремится только к точному отображению вход-выход [30]. Эти два подхода дополняют друг друга. Механистические модели кодируют знания о процессе и могут хорошо экстраполировать, когда их предположения верны; модели, основанные на данных, могут улавливать взаимосвязи, которые трудно формализовать, но которые требуют репрезентативных данных и не гарантируют производительности за пределами диапазона, на котором они были обучены.
Задачи обучения обычно делятся на два типа. В контролируемом обучении обучающие данные состоят из размеченных примеров, то есть пар входных данных и известных правильных выходных данных. Алгоритм корректирует модель таким образом, чтобы ее выходные данные соответствовали меткам, а затем подобранная модель применяется к новым, неразмеченным входным данным. Если выходное значение представляет собой непрерывное число, задача — регрессия; если это категория, — классификация. В неконтролируемом обучении метки не задаются, и алгоритм вместо этого ищет структуру в самих данных, например, путем кластеризации похожих наблюдений в группы или путем уменьшения размерности, которое переформулирует множество коррелированных переменных в терминах нескольких информативных. Классическим примером последнего является анализ главных компонентов [31], а самоорганизующаяся карта Кохонена — это нейронный метод, который сочетает кластеризацию с низкоразмерной визуальной компоновкой [32]. Третий подход, обучение с подкреплением, в котором агент изучает политику, действуя и получая вознаграждения [33], является центральным для современного ИИ, но в рассмотренной здесь литературе встречается лишь в незначительной степени.
1.2.2. Характеристики, представление и проклятие размерности
Независимо от алгоритма, модель не видит объект напрямую; она видит вектор чисел, описывающих его, называемый признаками. Выбор или построение этих чисел — это извлечение признаков, и исторически именно на это тратилась большая часть усилий в прикладном машинном обучении. Трудность заключается в том, что многие методы измерения производят гораздо больше переменных, чем образцов для обучения: спектр может содержать сотни или тысячи длин волн, измеренных всего на нескольких десятках образцов. В этом режиме модели легко подгоняются под шум, а расстояния между точками становятся неинформативными — набор проблем, известных как проклятие размерности [34]. Стандартные решения — это уменьшение размерности перед моделированием, использование алгоритмов, устойчивых ко многим коррелированным предикторам, таких как регрессия методом частичных наименьших квадратов [35], или регуляризация модели таким образом, чтобы сложность штрафовалась.
Дисциплина, разработавшая эти методы для химических и спектроскопических данных, — это хемометрика [36]. Здесь она рассматривается не как отдельный вид ИИ, а как совокупность методов и практик для извлечения интерпретируемой и проверенной информации из многомерных аналитических данных. В данном обзоре методы хемометрической калибровки и классификации включены в более широкую группу классических статистических подходов и подходов машинного обучения, если они удовлетворяют критерию включения, определенному в разделе 2.
1.2.3. Классическое (не нейронное) машинное обучение
Большая часть машинного обучения вообще не включает нейронные сети. В этом обзоре они называются классическими методами. К ним относятся линейная и логистическая регрессия; метод частичных наименьших квадратов; деревья решений, которые классифицируют, задавая последовательность пороговых вопросов; случайные леса, которые усредняют множество таких деревьев, выращенных на случайных подмножествах данных, чтобы уменьшить дисперсию [37]; машины опорных векторов, которые разделяют классы по максимально возможному расстоянию и, с помощью метода ядра, могут делать это в преобразованном пространстве, где граница не обязательно должна быть линейной [38]; метод k -ближайших соседей, который классифицирует объект по большинству голосов обучающих примеров, на которые он больше всего похож; и градиентный бустинг, который строит сильный предиктор из последовательности слабых, каждый из которых исправляет ошибки своего предшественника [39].
Эти методы остаются важными. Как правило, они требуют меньше данных, чем глубокие нейронные сети, и часто проще для интерпретации. В случае небольшого набора данных и хорошо подобранных признаков классическая модель может показывать сопоставимые или даже лучшие результаты, чем нейронная, поэтому выбор между ними должен основываться на эмпирических данных, а не на предполагаемой методологической сложности.
1.2.4. Нейронные сети
Искусственная нейронная сеть — это модель, состоящая из простых обрабатывающих блоков, расположенных слоями. Каждый блок формирует взвешенную сумму своих входных данных, добавляет смещение и пропускает результат через нелинейную функцию активации; выходные данные одного слоя становятся входными данными следующего. Идея восходит к перцептрону 1950-х годов [40], но стала практической благодаря обратному распространению ошибки, эффективному способу вычисления того, как каждый вес в сети должен изменяться для уменьшения ошибки на обучающих данных [41]. Затем обучение происходит методом градиентного спуска: веса корректируются небольшими шагами, на протяжении многих проходов по данным, пока ошибка не перестанет уменьшаться.
Привлекательность таких сетей заключается в их универсальности. Сеть даже с одним скрытым слоем может, в принципе, аппроксимировать любую непрерывную функцию с произвольной точностью при достаточном количестве элементов [42]. На практике более глубокие архитектуры могут обучаться иерархическим представлениям, позволяя извлекать полезные признаки из необработанных данных, а не требовать их ручного проектирования. Это центральная идея глубокого обучения [3, 43], практическое развитие которого с начала 2010-х годов поддерживалось большими размеченными наборами данных, параллельными вычислениями на графическом оборудовании и улучшениями методов обучения.
Для разных типов данных требуются разные архитектуры. Прямая нейронная сеть (также многослойный перцептрон, MLP или просто ANN) передает информацию в одном направлении, от входа к выходу, без памяти о предыдущих входных данных. Это выбор по умолчанию для табличных данных, где каждый пример представляет собой неупорядоченный список измеренных переменных.
Сверточная нейронная сеть (CNN) предназначена для данных с пространственной структурой, прежде всего изображений [44]. Вместо того чтобы соединять каждый пиксель с каждым блоком, CNN применяет небольшие, обученные фильтры по всему изображению, обнаруживая локальные закономерности, такие как края или текстуры. Последовательные слои объединяют их в постепенно более абстрактные представления. Поскольку одни и те же фильтры используются по всему изображению, CNN может использовать значительно меньше параметров, чем полносвязная сеть сопоставимой мощности, и может обучаться признакам, которые относительно устойчивы к изменениям положения объекта. Демонстрация того, что глубокие CNN могут превзойти признаки, созданные вручную, при распознавании изображений в больших масштабах [45], внесла существенный вклад в быстрое развитие современного компьютерного зрения.
Рекуррентная нейронная сеть (РНН) обрабатывает последовательность по одному элементу за раз, поддерживая при этом внутреннее состояние, которое суммирует то, что она видела до сих пор, так что ее выход в любой момент зависит от истории, а не только от текущего входа. Обычные РНН сложно обучать на длинных последовательностях, потому что градиенты, используемые для их обновления, уменьшаются или увеличиваются по мере их распространения назад через множество шагов [46]. Сеть с долговременной кратковременной памятью (LSTM) решает эту проблему с помощью вентильных блоков, которые могут хранить информацию в течение многих временных шагов и учиться, когда ее обновлять или отбрасывать [47]. Поэтому РНН и LSTM являются стандартными инструментами для обработки данных временных рядов — любого процесса, текущее состояние которого зависит от его траектории.
Трансформер заменяет рекуррентность механизмом внимания, который позволяет каждому элементу последовательности напрямую обращать внимание на каждый другой и взвешивать их релевантность [48]. Поскольку это устраняет последовательное узкое место RNN, он хорошо распараллеливается и масштабируется до очень больших моделей и корпусов. Трансформеры сейчас лежат в основе большинства работ по языку и все чаще по другим данным последовательностей и изображений.
1.2.5. Компьютерное зрение
Компьютерное зрение — это область, занимающаяся извлечением информации из изображений. В данном обзоре оно рассматривается как прикладной вычислительный подход, а не как отдельное семейство моделей, поскольку задачи компьютерного зрения могут быть реализованы с использованием как классических дескрипторов изображений и классификаторов, так и нейронных сетей. До появления глубокого обучения компьютерное зрение в основном опиралось на разработанные вручную дескрипторы — цвета, формы, краев и текстуры — которые подавались на вход классического классификатора. Этот подход остается жизнеспособным, когда соответствующая визуальная характеристика известна заранее, а обработка изображений хорошо контролируется. Современное компьютерное зрение вместо этого часто обучает дескрипторы, обычно с помощью сверточной нейронной сети (CNN). Удобно выделить три типа задач, поскольку они встречаются во всей рассмотренной литературе: классификация, которая присваивает метку всему изображению; обнаружение объектов, которое дополнительно локализует каждый объект с помощью ограничивающей рамки; и сегментация, которая помечает каждый пиксель и, таким образом, точно определяет контур объекта. Перенос обучения важен на практике: сеть, первоначально обученная на большом общем корпусе изображений, повторно используется, при этом переобучаются только ее последние слои, на меньшем специализированном наборе данных, что делает глубокое зрение осуществимым на наборах данных из нескольких сотен или нескольких тысяч изображений [49].
1.2.6. Искусственный интеллект на основе датчиков и распознавание образов в химических сигналах
Параллельная традиция применяет распознавание образов не к изображениям, а к химическим и физическим сигналам. Электронный нос — это массив газовых датчиков, индивидуальные отклики которых неспецифичны, но которые в совокупности создают характерный паттерн для данного запаха [50]; электронный язык — это аналог в жидкой фазе, использующий массив электродов [51]. Ни один из этих приборов сам по себе не является методом ИИ. Каждый из них создает многомерный отпечаток, и затем для интерпретации этого отпечатка используется модель классификации или регрессии, обученная на известных образцах. Та же логика применима к спектроскопии и к хроматографическим или масс-спектрометрическим отпечаткам: аналитический прибор предоставляет многомерный сигнал, а вычислительная модель выполняет прогнозирование или классификацию. Именно поэтому такие системы хороши настолько, насколько хороша их калибровка, и поэтому их необходимо повторно проверять при изменении прибора, способа представления образца или популяции образцов.
1.2.7. Оптимизация и метаэвристика
Многие практические задачи связаны не с предсказанием, а с выбором: имея пространство возможных конфигураций и меру качества каждой из них, необходимо найти оптимальную конфигурацию. Когда это пространство велико, дискретно или изобилует локальными оптимумами, точные методы становятся непрактичными, и используются метаэвристики — универсальные стратегии поиска, которые эффективно исследуют пространство, но не гарантируют нахождения глобального оптимума.
Генетические алгоритмы поддерживают популяцию решений-кандидатов и улучшают её по аналогии с естественным отбором: более приспособленные кандидаты отбираются предпочтительно, комбинируются посредством кроссовера и случайным образом подвергаются мутации [52, 53]. Дифференциальная эволюция следует той же популяционной схеме, но генерирует новых кандидатов путем добавления масштабированных разностей между существующими, что делает её эффективной для непрерывных параметров [54]. Когда цели противоречат друг другу, многоцелевая оптимизация возвращает не один ответ, а фронт Парето — множество решений, для которых ни одна цель не может быть улучшена без ущерба для другой, — оставляя окончательный компромисс человеку [55].
В отличие от них, но часто объединяя их в прикладных исследованиях, существует традиция исследования операций, которая формулирует задачи планирования явно и решает их с помощью математического программирования. Планирование распределяет задачи между ограниченными ресурсами во времени; определение размера партии определяет, сколько каждого продукта производить в каждый период; распределение ресурсов распределяет дефицитные мощности между конкурирующими потребностями. Это классические задачи оптимизации с ограничениями, а не методы ИИ в узком смысле, но они включены в этот обзор, поскольку они решают те же проблемы планирования пивоваренного производства и поддержки принятия решений, что и подходы к оптимизации на основе ИИ [56].
1.2.8. Управление и программные датчики
Управление касается направления динамической системы к желаемому состоянию. Подходы на основе ИИ особенно актуальны, когда система нелинейна, плохо изучена или лишь частично наблюдаема. Нечеткая логика кодирует знания в виде градуированных качественных правил, позволяя переменной быть частично «высокой» и частично «средней», и таким образом формализует опыт оператора, который не поддается точным уравнениям [57, 58]. Модель прогнозирующего управления многократно использует модель для моделирования последствий возможных действий на будущем горизонте и применяет наилучшую из них, перепланируя на каждом шаге [59]; MPC не является по своей сути методом ИИ, хотя базовая модель процесса может быть изучена, например, с помощью нейронной сети. Мягкий датчик (или виртуальный датчик) — это модель, которая выводит величину, которую трудно, медленно или дорого измерить напрямую, из других сигналов, которые легко доступны в сети [60]. Таким образом, мягкое зондирование может предоставлять оценочные переменные процесса для мониторинга или управления, когда прямое измерение нецелесообразно.
1.2.9. Цифровые двойники, Интернет вещей и Индустрия 4.0/5.0
Остальные термины описывают инфраструктуру, а не алгоритмы. Интернет вещей (IoT) относится к сетям оснащенных устройств, которые воспринимают информацию и обмениваются данными; киберфизические системы — это установки, в которых вычисления и физические процессы тесно связаны. Индустрия 4.0 — это название, данное результирующему переходу к взаимосвязанному, основанному на данных производству [61, 62], а Индустрия 5.0 — последующему переосмыслению, которое вновь ставит в центр внимания оператора-человека наряду с устойчивостью и отказоустойчивостью [63]. Цифровой двойник — это цифровая модель физического актива или процесса, синхронизированная с ним посредством канала передачи данных в реальном времени, так что модель может быть исследована, смоделирована и использована в экспериментах вместо реальной системы [64, 65]. Ни один из этих терминов сам по себе не является методом ИИ; они представляют собой среду, которая делает методы ИИ применимыми, предоставляя данные, на которых обучаются модели, и интерфейсы, через которые действуют их выходные данные.
1.2.10. Эмбеддинги, большие языковые модели и многоагентные системы
Эмбеддинг представляет собой дискретный элемент — слово, ингредиент, продукт — в виде вектора чисел, обученного таким образом, чтобы элементы, используемые в схожих контекстах, располагались близко друг к другу. Расстояния в этом пространстве затем несут семантическое значение, что делает эмбеддинги основой поиска сходства и рекомендаций [66].
Большая языковая модель (БЯМ) — это модель на основе трансформеров, обученная на очень больших текстовых корпусах с использованием предсказания следующего токена в качестве основной цели обучения. При достаточном масштабе такие модели могут генерировать беглый текст и выполнять ряд задач, связанных с языком [67], и могут управляться инструкциями, выраженными на обычном языке. Их известные ограничения важны в технических приложениях: они могут генерировать правдоподобные, но неверные утверждения, и у них нет доступа к информации за пределами данных и внешних источников, предоставленных им.
Многоагентная система (МАС) моделирует проблему как совокупность автономных агентов, каждый из которых действует на основе локальной информации и взаимодействует, при этом поведение на уровне системы возникает из этих взаимодействий [68]. В данном обзоре МАС рассматривается как парадигма вычислительного моделирования, а не как конкретный метод машинного обучения. Она особенно подходит для представления децентрализованных систем, таких как рынки, логистические сети или множество единиц оборудования, конкурирующих за общие ресурсы.
1.2.11. Оценка, переобучение и обобщение
Точность модели, о которой сообщается, трудно интерпретировать, если она не измеряется на данных, которые модель не видела во время обучения. Модель, которая запомнила свой обучающий набор — точно воспроизводит его, но плохо работает на новых данных — считается переобученной. Стандартная защита заключается в предоставлении тестового набора или использовании перекрестной проверки, при которой данные многократно разделяются, а модель обучается и оценивается на дополнительных частях [69]. Еще два момента повторяются на протяжении всего этого обзора. Интерпретируемость — степень, в которой рассуждения модели могут быть поняты — часто имеет значение наряду с точностью, когда модель влияет на решения, за которые человек остается ответственным, и ограниченная интерпретируемость является распространенной проблемой в глубоких сетях, что послужило мотивацией для ряда работ по методам объяснения [70, 71]. Обобщение в разных условиях является практическим ограничением: модель, обученная на данных одного инструмента, места или масштаба, может оказаться неэффективной на другом, данные которого распределены иначе. Эта проблема решается путем адаптации предметной области [49] и, если данные не могут быть объединены по практическим или коммерческим причинам, путем федеративного обучения, при котором модели обучаются совместно, без того, чтобы исходные данные покидали их владельцев [72].
Освоив эту терминологию, в следующих разделах мы перейдем к рассмотрению того, как эти методы фактически применялись в пивоварении, в порядке убывания стадии процесса их применения.
2. Обзор литературы
Данный обзор основан на корпусе из 188 публикаций, посвященных применению искусственного интеллекта в пивоварении. Окончательный структурированный поиск был проведен в Scopus 5 сентября 2026 года с использованием всех попарных комбинаций терминов, связанных с пивоварением и искусственным интеллектом, перечисленных в Таблице 1. Всего было выполнено 132 запроса. Поиск дал 1683 записи до объединения. Дублирующиеся записи были идентифицированы по DOI, если он был доступен, в противном случае — по названию и авторам. После удаления дубликатов осталось 936 уникальных записей, которые были вручную проверены на релевантность. Из них 67 публикаций были отобраны для обзора.
Таблица 1. Поисковые запросы, использованные в структурированном поиске Scopus. Каждый термин, связанный с пивоварением, был объединен с каждым термином, связанным с искусственным интеллектом, в результате чего было получено 132 поисковых запроса.
| Термины, связанные с пивоварением | Термины искусственного интеллекта |
|---|---|
| пивоварение | искусственный интеллект |
| рецепты пива | ИИ |
| планирование пивоварни | оптимизация |
| замешивание | генетические алгоритмы |
| фильтрация | метаэвристика |
| кипячение сусла | нейронные сети |
| охлаждение сусла | компьютерное зрение |
| брожение пива | магистр права |
| выдержка пива | большие языковые модели |
| розлив пива по бутылкам | многоагентные системы |
| качество пива | Индустрия 4.0 |
| цифровой двойник |
В исследование включались публикации, посвященные применению искусственного интеллекта или связанных с ним вычислительных методов в пивоварении, выборе пивоваренных материалов, этапах производства, планировании процессов или оценке качества. Публикации исключались, если компонент, связанный с пивоварением или искусственным интеллектом, отсутствовал, был второстепенным по отношению к исследованию или являлся результатом использования неоднозначного поискового запроса, не имеющего отношения к теме.
В ходе предварительного тестирования в качестве поисковых запросов, связанных с пивоварением, рассматривались также хмель и солод. В базе данных Scopus поисковые запросы, содержащие эти термины, выдали в общей сложности более 20 000 записей, причем значительная часть результатов не имела отношения к применению искусственного интеллекта в пивоварении. Поэтому эти термины были исключены из окончательной стратегии поиска.
Поиск по обратным ссылкам проводился при изучении списков литературы публикаций, уже включенных в корпус. В первом раунде было выявлено 59 дополнительных релевантных публикаций, а во втором — еще 7. Публикации, уже присутствующие в корпусе, повторно не учитывались.
В период с 1 мая 2026 года по 4 июля 2026 года также были проведены дополнительные поиски вручную в базах данных Web of Science, Google Scholar, EBSCO, SpringerLink, ProQuest и Wiley Online Library. Эти поиски использовались для выявления дополнительных релевантных публикаций. Поскольку поиски в этих источниках проводились вручную, общее количество просмотренных записей не было зафиксировано последовательно и не может быть достоверно восстановлено. Из публикаций, выявленных в ходе этих дополнительных поисков, 55 были уникальными дополнениями к корпусу, то есть они не были ранее обнаружены с помощью поиска в Scopus или обратного поиска по цитируемым источникам.
Таким образом, окончательный корпус включал 67 публикаций, отобранных в результате поиска в Scopus, 66 публикаций, выявленных в ходе двух раундов обратного поиска цитирований, и 55 публикаций, выявленных в ходе дополнительных поисков, что в общей сложности составило 188 публикаций. Процесс идентификации и отбора публикаций представлен на рисунке 1 .

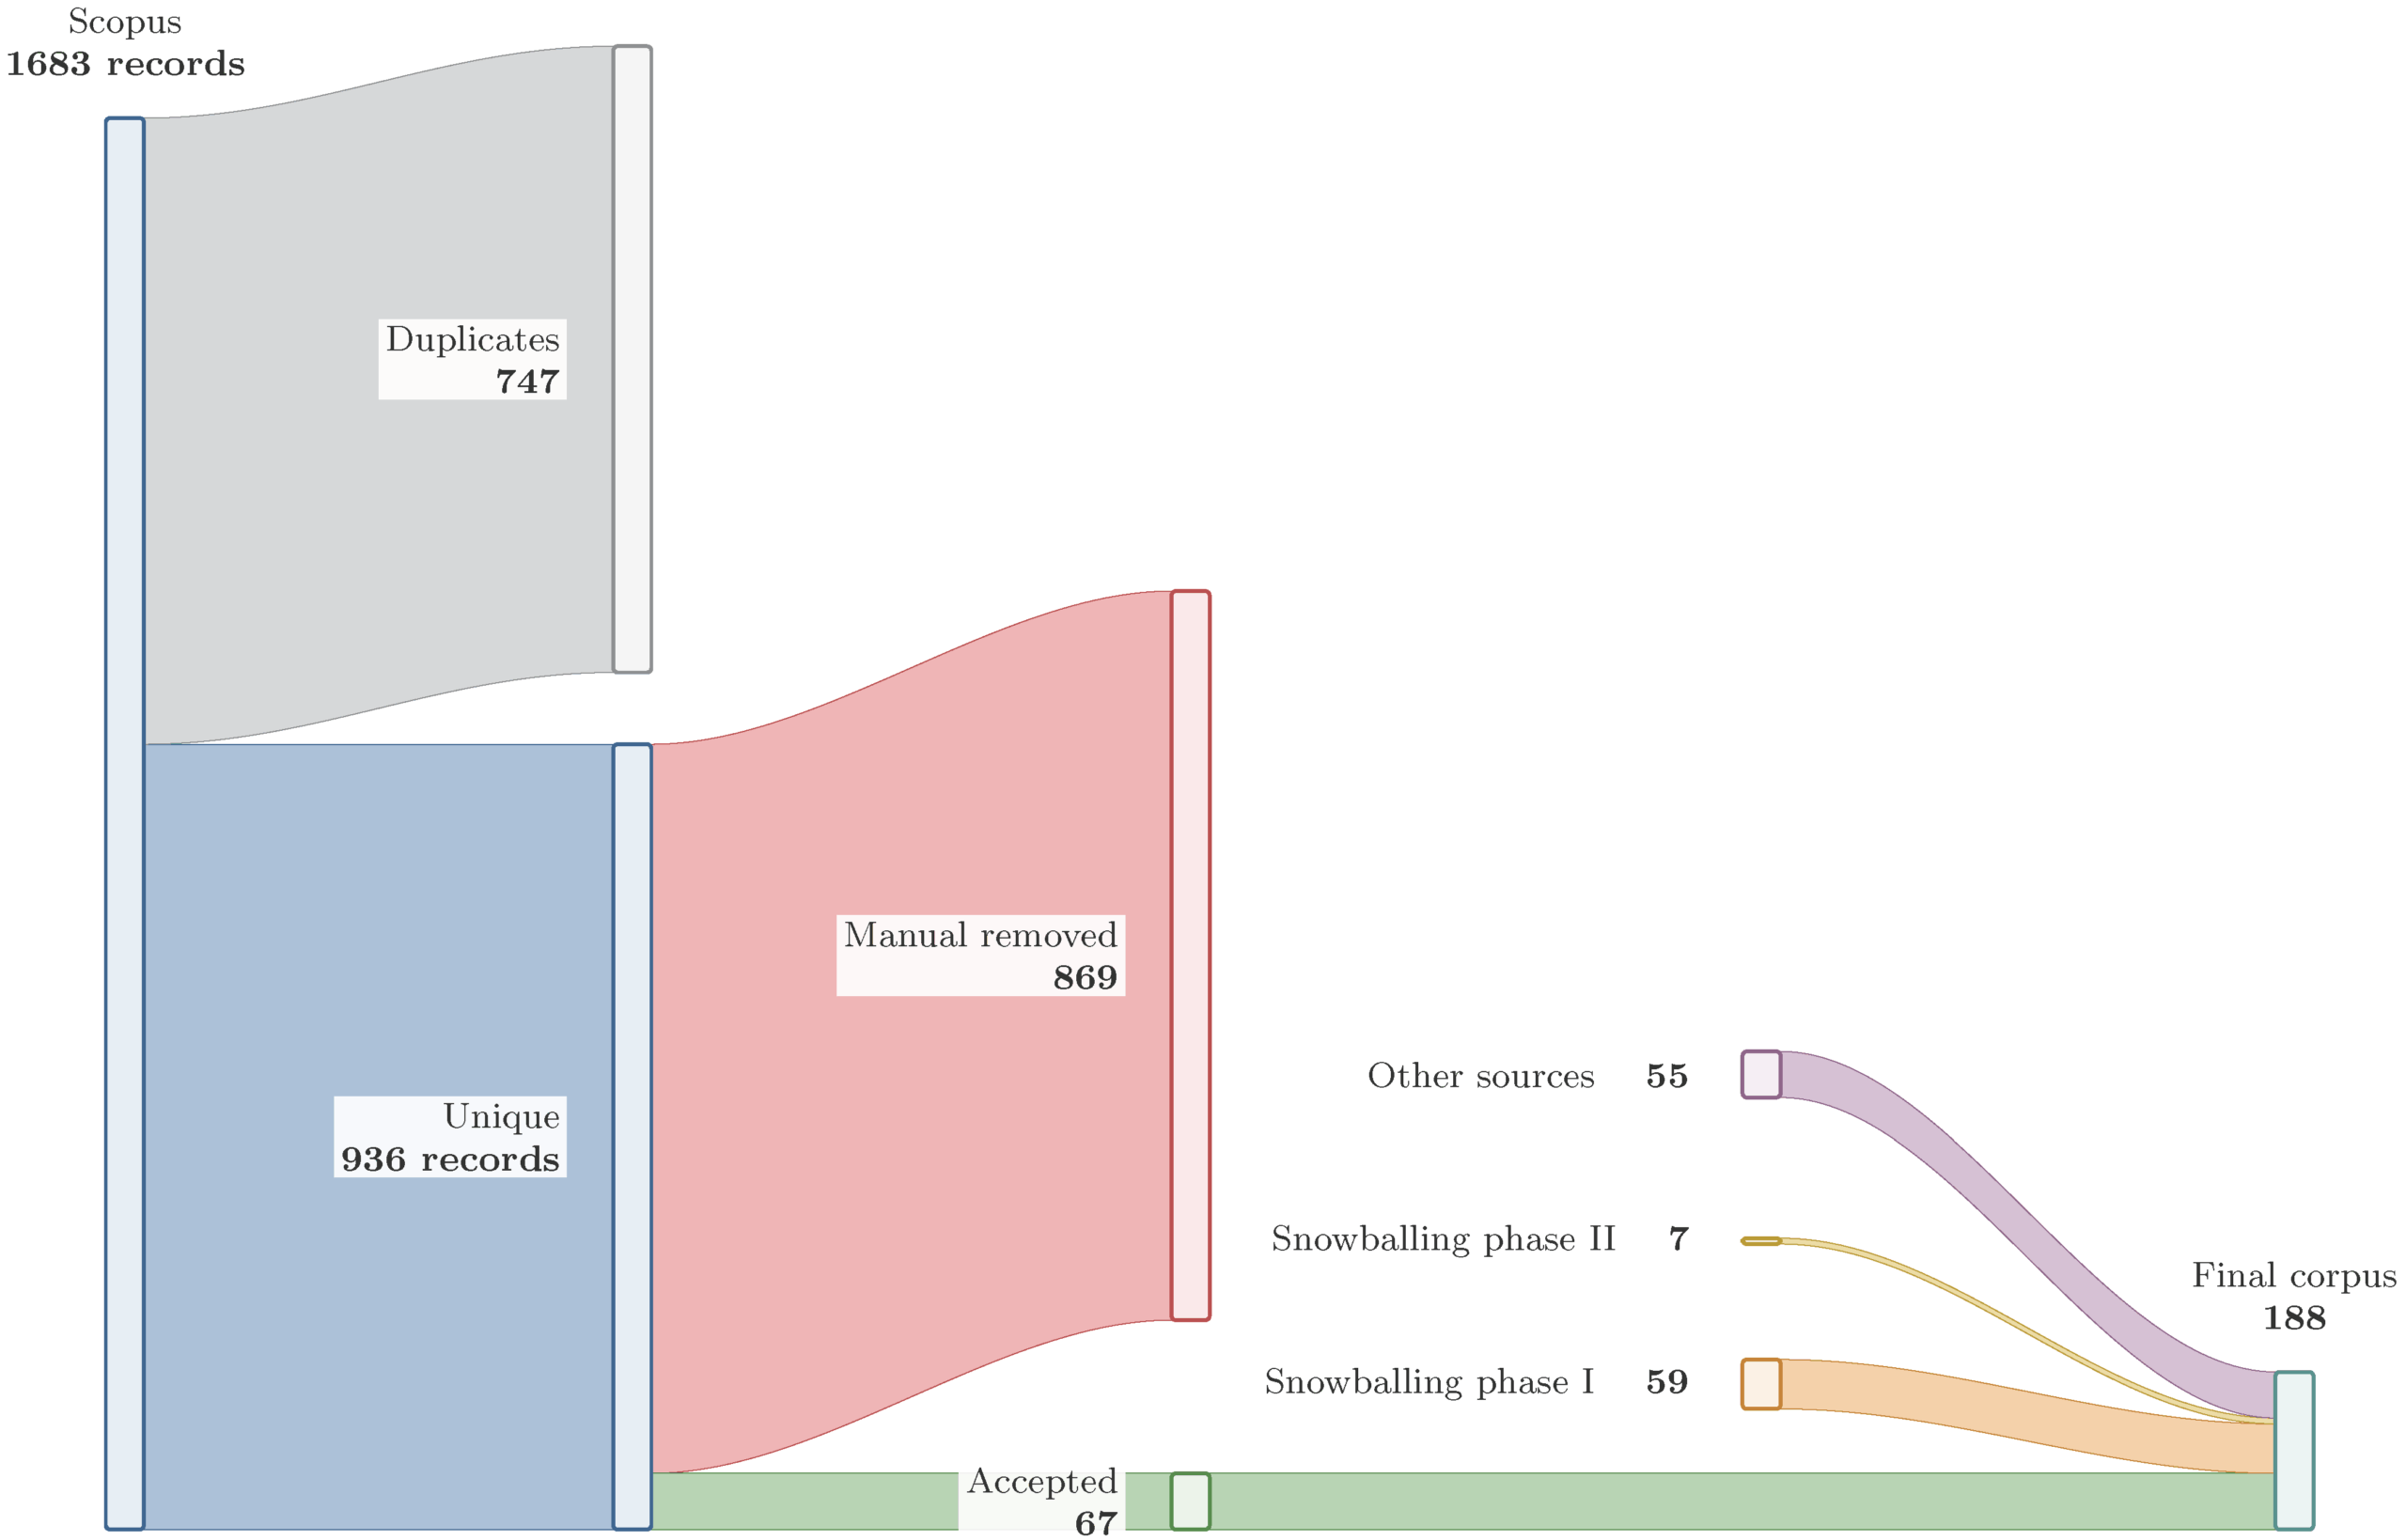
Рисунок 1. Схема отбора публикаций, выявленных с помощью структурированного поиска в базе данных Scopus, поиска по обратным ссылкам и дополнительных поисков, в результате чего был сформирован окончательный корпус из 188 публикаций.
Прошедшие отбор публикации были внесены в специально разработанное веб-приложение, а не в обычный менеджер библиографических ссылок, чтобы каждая запись могла содержать структурированные метаданные, выходящие за рамки стандартной библиографической записи. Наряду с записью BibTeX, каждая публикация была аннотирована страной, связанной с местом работы первого автора, ссылками на другие публикации, уже присутствующие в корпусе, на которые она ссылалась или на которые ссылались другие авторы, а также предварительным размещением на двух осях, описанных ниже. Эти метаданные вводились рецензентами непосредственно во время отбора, а не генерировались автоматически, и могли быть изменены по мере роста корпуса и уточнения определений осей.
Поскольку для искусственного интеллекта нет единого общепринятого определения (раздел 1.2), критерий, применяемый при отборе, здесь изложен явно. Публикация считалась релевантной искусственному интеллекту в пивоварении, если она удовлетворяла хотя бы одному из четырех условий: (i) она подгоняет модель на основе данных, так что взаимосвязь между входом и выходом изучается на примерах, а не задается заранее, что охватывает классическое машинное обучение, хемометрическую калибровку, нейронные сети и модели компьютерного зрения; (ii) она осуществляет поиск в пространстве вариантов решений по отношению к явно сформулированной цели, что охватывает метаэвристики, эволюционные алгоритмы и формулировки математического программирования, используемые для планирования и определения размеров партий; (iii) она описывает инфраструктуру сбора, интеграции или моделирования данных, с помощью которой методы типа (i) или (ii) развертываются на пивоварне, то есть установки IoT, киберфизические системы, архитектуры Индустрии 4.0 и цифровые двойники; или (iv) она синтезирует основную литературу, охватываемую пунктами (i)–(iii). Чисто механистические кинетические модели, традиционная статистическая проверка гипотез и описательная аналитическая химия не рассматривались как искусственный интеллект, если в них отсутствовал компонент, основанный на обучении или поиске.
Эти четыре условия не эквивалентны, и используемая в данном обзоре классификация не рассматривает их как таковые. Условия (i) и (ii) определяют вычислительные методы, включенные в операционную область применения ИИ, используемую в данном обзоре. Условие (iii) определяет вспомогательную инфраструктуру: как отмечалось в разделе 1.2 , установка IoT или цифровой двойник сами по себе не являются методом обучения, но в современной литературе эти системы последовательно представляются как контекст, в котором развертываются методы, основанные на данных, и их исключение исключило бы из поля зрения существенную и целостную часть этой области. Условие (iv) является свойством публикации, а не описываемой в ней технологии. Поэтому категории, вытекающие из условий (iii) и (iv), обозначаются соответствующим образом и приводятся отдельно от семейств методов везде, где указываются данные.
В данной литературе концептуально различаются четыре измерения, которые здесь остаются четко разграниченными: рассматриваемый этап исследования, модальность данных, с которыми работает работа, используемый вычислительный подход и задача, которую этот подход выполняет. Тип публикации — первичное исследование или обзор — является пятым, ортогональным атрибутом. В таблице 2 приведена сводная информация об этих измерениях и указано, где каждое из них представлено. Два из них, этап исследования и вычислительный подход, используются в качестве осей карты на рисунке 2 , поскольку именно по ним корпус делится наиболее четко, и потому что двухмерная проекция остается читаемой; задача и вычислительный подход каждой отдельной публикации приведены в таблице A1 , а модальность данных, которая тесно связана с инструментарием, описанным для каждого исследования, рассматривается в процессе-ориентированном обсуждении раздела 3 и возвращается к нему в разделе 4.2 . Таким образом, карта представляет собой проекцию пятимерной схемы кодирования на два измерения, структурирующие обзор, а не утверждение о том, что остальные измерения подчинены им.


Рисунок 2. Сопоставление 188 публикаций с этапами процесса пивоварения (столбцы) и вычислительными подходами (строки). Линии между узлами представляют собой ссылки на публикации. Столбцы обозначают: (A) общий процесс; (B) материалы и лаборатория; (C) планирование и подготовка; (D) затирание, фильтрация, кипячение и охлаждение; (E) ферментация; (F) розлив; и (G) обеспечение качества. Строки обозначают: (1) обзорные статьи (тип публикации, а не вычислительный подход), (2) Индустрия 4.0 и цифровые двойники (контекст внедрения, а не вычислительный подход), (3) LLM и MAS, (4) компьютерное зрение, (5) нейронные сети и (6) классические методы; см. Таблицу 2.
Таблица 2. Измерения, по которым был охарактеризован корпус, и где каждое из них указано. Карта на рисунке 2 проецирует корпус на измерения D1 и D3; тип публикации (D5) показан отдельной строкой на этом рисунке, а не как вычислительный подход.
| Размеры и категории | Где сообщается | |
|---|---|---|
| Д1 | Этапы пивоварения: общий процесс; материалы и лаборатория; планирование и подготовка; затирание, фильтрация, кипячение и охлаждение; брожение; розлив в бутылки; контроль качества. | Столбцы рисунка 2 ; подразделы раздела 3 |
| Д2 | Виды данных: временные ряды процессов; изображения; спектры; массивы химических датчиков; лабораторные и композиционные измерения; производственная и коммерческая документация; текст. | Повествование раздела 3 ; подразумевается в описаниях задач и подходов в таблице А1 ; раздел 4.2 |
| Д3 | Вычислительный подход: классическое (не нейронное) машинное обучение и статистическое обучение; нейронные сети; компьютерное зрение; большие языковые модели и многоагентные системы; оптимизация и метаэвристика. | Строки рисунка 2 , где методы оптимизации и метаэвристики сгруппированы в раздел классических методов; Таблица А1 |
| Д4 | Задача: прогнозирование (регрессия); классификация; оптимизация; управление и программное обеспечение для мониторинга; поддержка принятия решений. | Раздел 1.2 ; Таблица А1 |
| Д5 | Тип публикации: первичное исследование; обзор | Представлено отдельно по всему тексту; строка (1) рисунка 2 |
| — | Контекст внедрения (без использования вычислительных методов): Интернет вещей и киберфизические системы; Индустрия 4.0; цифровые двойники. | Строка (2) рисунка 2 ; Раздел 3.3 |
Первая ось карты — это этап процесса пивоварения, рассматриваемый в работе (измерение D1): общий процесс, материалы и лаборатория, планирование и подготовка, затирание/фильтрация/кипячение/охлаждение, ферментация, розлив в бутылки и контроль качества. Общий этап процесса охватывает работы, рассматривающие процесс пивоварения как единое целое, а не как отдельный этап.
Вертикальная ось рисунка 2, соответственно, содержит три типа категорий, и их следует читать именно так. Четыре строки представляют вычислительные подходы в смысле измерения D3: классическое (не нейронное) машинное обучение и статистические методы, нейронные сети, компьютерное зрение и большие языковые модели с многоагентными системами. Одна строка, «Индустрия 4.0 и цифровые двойники», представляет собой контекст развертывания условия (iii), а не вычислительный подход; размещенные там работы описывают инфраструктуру, и если они также содержат обучаемый компонент, это указано в таблице A1. Оставшаяся строка, «Обзорные статьи», представляет собой тип публикации измерения D5 и не является вычислительным подходом. Оптимизация и метаэвристика не образуют отдельную строку: эта работа сосредоточена на планировании и подготовке (раздел 3.3) и сгруппирована с классическими подходами, поскольку лежащие в основе алгоритмы не являются нейронными, и объем таких работ не оправдывает отдельную строку. Компьютерное зрение отделено от нейронных сетей, несмотря на то, что большинство последних работ в этой области посвящено сверточным технологиям, поскольку для процесс-ориентированного анализа важно различие в том, что измеряется — изображение зерна, бутылки или пенопластовой головы, — а не в том, какой оценщик его интерпретирует; описанные ниже границы делают это перекрытие явным, а не скрывают его.
В целом, первичные исследования и обзорные статьи различаются. Из 188 публикаций 176 содержат результаты первичных исследований, а 12 представляют собой обзорные или синтезирующие статьи; последние идентифицированы отдельно в Разделе 3 и размещены в строке (1) Рисунка 2, в столбце, соответствующем этапу пивоварения, который они рассматривают. Обзоры исключены из всех подсчетов вычислительных подходов, представленных ниже, чтобы распространенность подхода не завышалась статьями, которые просто его описывают. Однако они сохраняются в подсчетах этапов и в анализе цитирования, поскольку их тематика и поведение при цитировании дают представление об организации данной области. 12 обзоров распределены по общему процессу (3), планированию и подготовке (3), обеспечению качества (3), ферментации (2) и материалам и лаборатории (1).
Среди 176 первичных исследований наиболее распространенным вычислительным подходом являются нейронные сети (67), за которыми следуют классические методы (50), компьютерное зрение (43) и большие языковые модели с многоагентными системами (7); еще 37 исследований относятся к категории «Индустрия 4.0 и цифровые двойники», то есть они описывают инфраструктуру развертывания, а не конкретный вычислительный подход. Большинство публикаций относятся к одной категории, но 38 из 188 находятся на границе категорий. Они преимущественно расположены на оси вычислительных подходов: 21 находится между компьютерным зрением и нейронными сетями, где сверточные модели выполняют задачу компьютерного зрения, 13 — между нейронными сетями и классическими методами, и 2 — на границах остальных подходов; только 2 находятся между смежными этапами процесса. В целом по корпусу наиболее изученными этапами являются обеспечение качества (54 работы, 51 из которых — первичные исследования) и ферментация (45, из которых 42 — первичные).
Эти две оси не являются независимыми. Работа в области компьютерного зрения сосредоточена в сфере обеспечения качества, материалов и лабораторных исследований, а также розлива, где задача, как правило, заключается в проверке или классификации физических компонентов и готовой продукции. Исследования с использованием нейронных сетей наиболее часто проводятся в процессе ферментации, который долгое время рассматривался как динамический процесс, требующий моделирования и прогнозирования. Классические методы распределены более равномерно, и их наибольшее присутствие снова наблюдается в ферментации и обеспечении качества. Работы, посвященные Индустрии 4.0 и цифровым двойникам, как правило, работают на системном уровне, рассматривая обеспечение качества, планирование и общий процесс, а не отдельный физический этап. Обеспечение качества выделяется как этап, охватываемый самым широким спектром подходов.
Самые ранние работы датируются 1993 годом, и корпус демонстрирует явное изменение масштаба с течением времени (Рисунок 3). Выпуск работ оставался низким и нерегулярным примерно в течение двух десятилетий; 26 работ, опубликованных до 2004 года, в основном посвящены нейронным и классическим методам и в подавляющем большинстве случаев касаются ферментации. Ежегодное количество работ увеличивается с конца 2010-х годов, достигнув максимального показателя за один год в 2024 году (22 публикации). 122 работы, опубликованные с 2017 года — около двух третей корпуса — заметно более разнообразны, охватывая все этапы процесса и все вычислительные подходы. Самые последние категории, а именно, большие языковые модели с многоагентными системами и обзорные статьи, появляются почти исключительно в этот период; последнее указывает на то, что область исследований выросла настолько, что требует синтеза. Это ускорение согласуется с более широкими библиометрическими данными о быстром распространении генеративного ИИ в науке [73]. Показатель 2026 года отражает неполный год и поэтому не может быть напрямую сопоставлен с более ранними показателями.

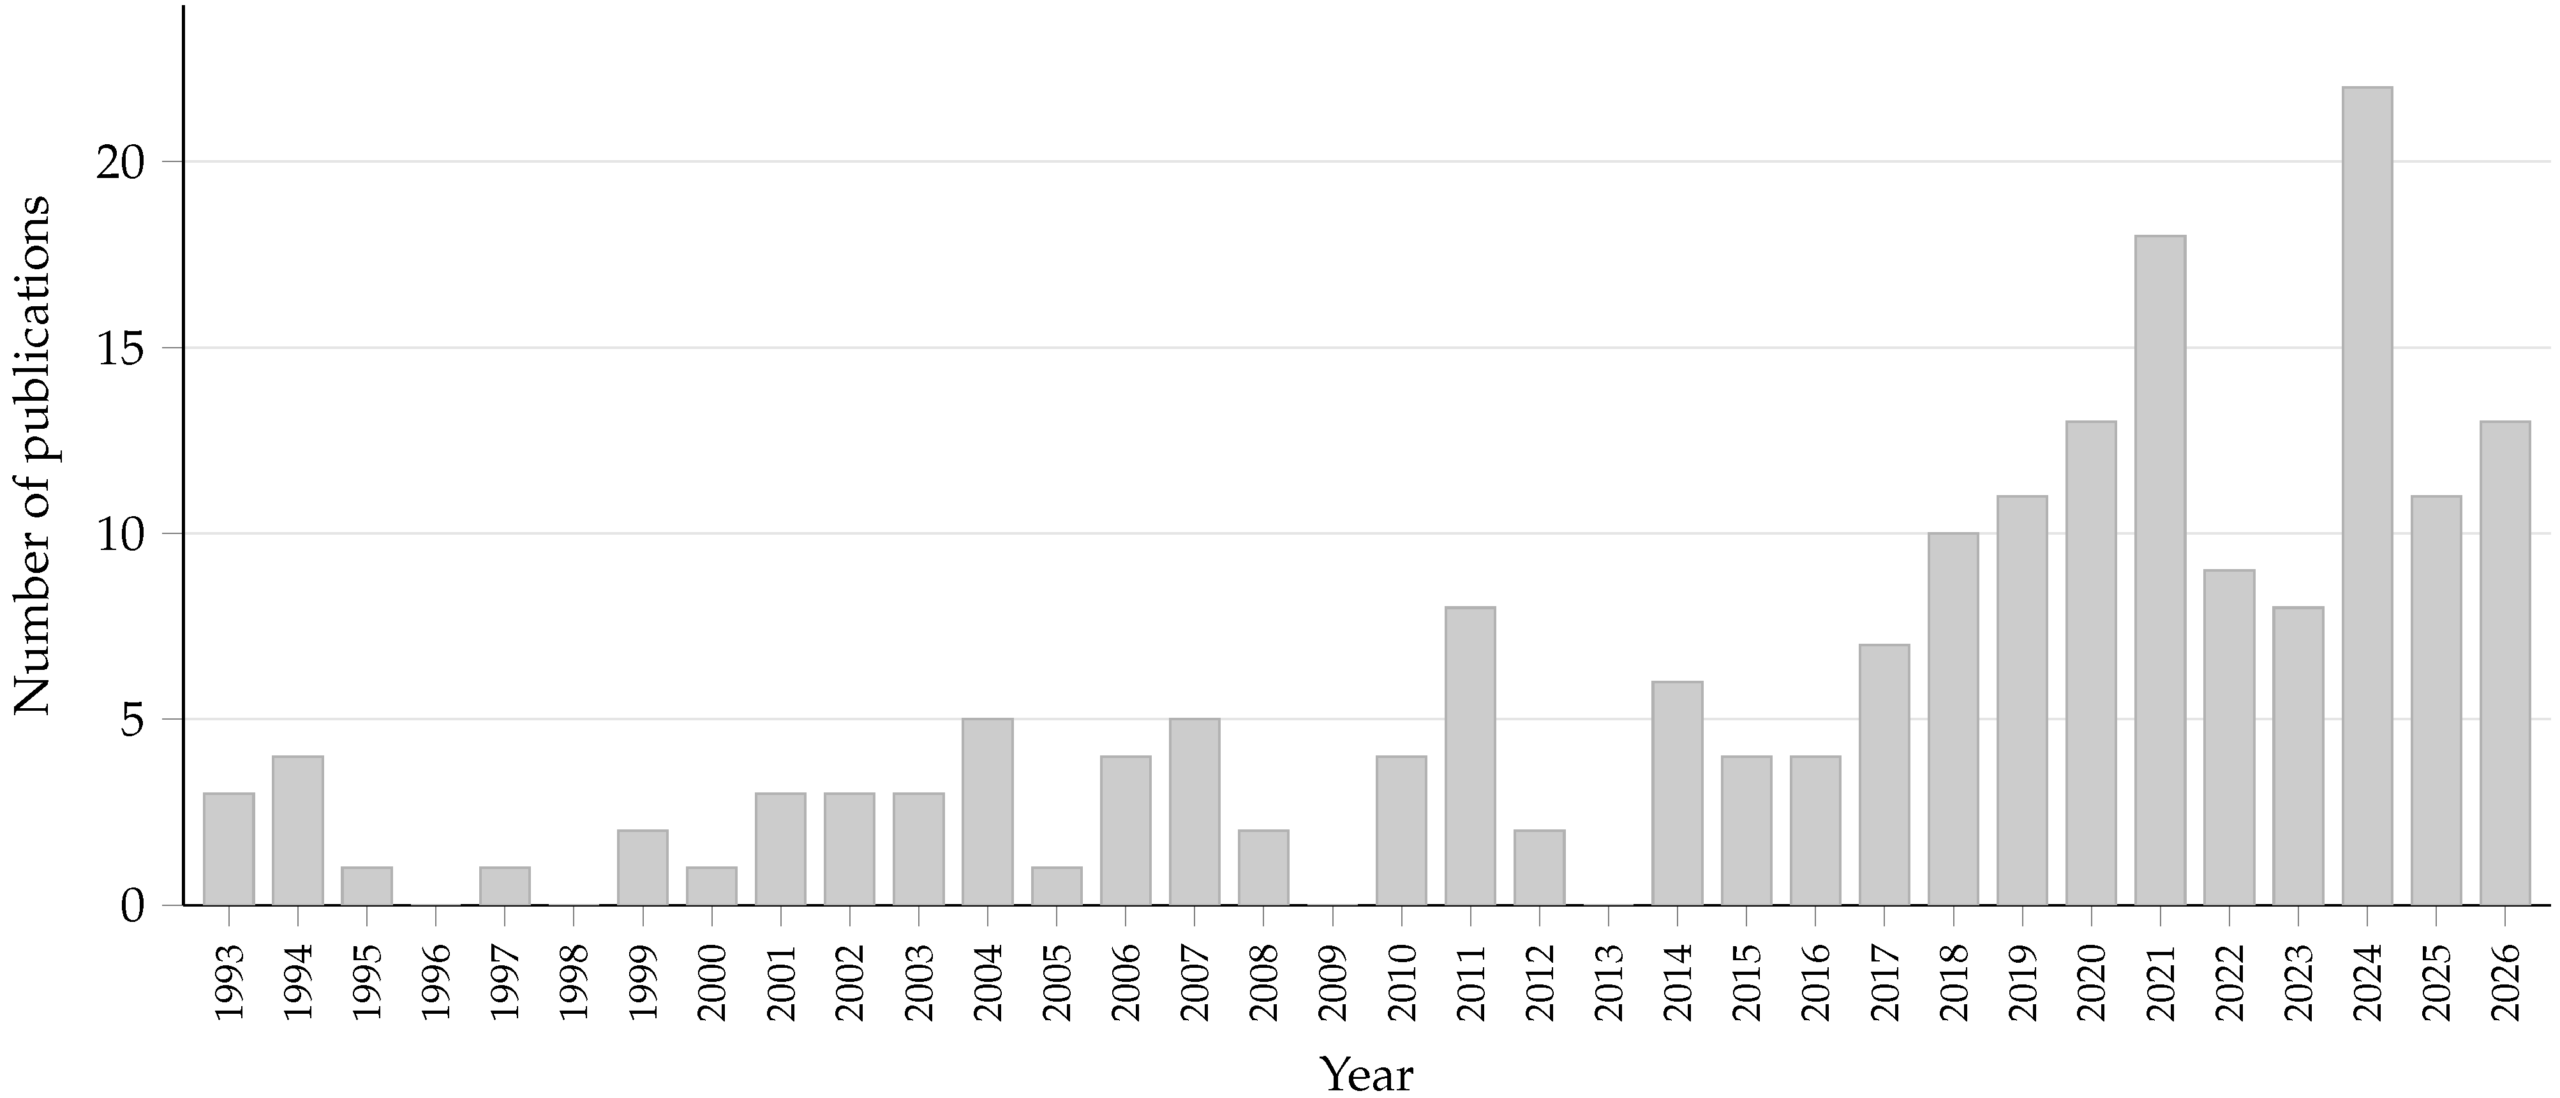
Рисунок 3. Количество публикаций в год по всему корпусу из 188 работ.
Каждая публикация была посвящена одной стране, что позволило получить данные из 39 стран (таблица 3). Наиболее представленными странами являются Польша (19), Австралия и Бразилия (17), Германия (16), Великобритания и Китай (15); более половины стран представлены одной или двумя публикациями. Распределение не совсем точно соответствует мировому производству или потреблению пива. Некоторые крупные производители и страны с устоявшимися традициями пивоварения хорошо представлены, включая Бразилию, Германию и Великобританию, но другие — нет: Китай, крупнейший производитель по объему, представлен относительно небольшим количеством публикаций по сравнению с его объемом производства, а Чехия, имеющая самый высокий уровень потребления на душу населения, упоминается один раз.
Таблица 3. Публикации по странам в сравнении с национальным производством и потреблением пива в 2024 году, в абсолютных показателях и на душу населения. Страны указаны по первой принадлежности ведущего автора и упорядочены по количеству публикаций. Не все страны, представленные в корпусе, показаны в этой таблице.
| Страна | Изд. | Прод. [М HL] | Конс. [М гл] |
Объем производства/качество [л] |
Вместимость/объем [л] |
|---|---|---|---|---|---|
| Польша | 19 | 34.6 | 33.4 | 89.4 | 86.3 |
| Австралия | 17 | 13.9 | 17.4 | 52.3 | 65.5 |
| Бразилия | 17 | 147.4 | 153.0 | 69.7 | 72.3 |
| Германия | 16 | 83.9 | 72.4 | 99.1 | 85,5 |
| Великобритания | 15 | 36.1 | 45.1 | 52.0 | 64.9 |
| Китай | 15 | 341.0 | 405.3 | 23.9 | 28.4 |
| Соединенные Штаты | 10 | 184.5 | 223.4 | 53.0 | 64.2 |
| Италия | 9 | 17.5 | 21.8 | 29.4 | 36.7 |
| Испания | 8 | 41.3 | 43.6 | 86.2 | 91.0 |
| Канада | 4 | 20.4 | 18.2 | 51.6 | 46.0 |
| Франция | 4 | 21.3 | 21.0 | 30.9 | 30.4 |
| ЮАР | 4 | 37.0 | 45.9 | 58.2 | 72.1 |
| Австрия | 3 | 10.1 | 9.4 | 110.7 | 103.0 |
| Бельгия | 3 | 21.0 | 6.7 | 179.1 | 57.1 |
| Болгария | 3 | 4.7 | 5.4 | 69.3 | 79.7 |
| Хорватия | 3 | 3.0 | 3.8 | 77.1 | 97,7 |
| Дания | 3 | 6.4 | 3.6 | 105.3 | 59.3 |
| Иран | 3 | 0.9 | — | 1.0 | — |
| Ирландия | 2 | 8.3 | 5.1 | 158.8 | 97.6 |
| Нидерланды | 3 | 21.3 | 11.7 | 116.1 | 63.8 |
| Мексика | 2 | 145.0 | 107.9 | 111.3 | 82.8 |
| Таиланд | 2 | 22.8 | 19.6 | 31.8 | 27.3 |
| Чехия | 1 | 20.0 | 15.6 | 185.3 | 144.6 |
| Финляндия | 1 | 3.2 | 3.8 | 57.0 | 67.7 |
| Венгрия | 1 | 5.6 | 7.4 | 57.8 | 76.4 |
| Португалия | 1 | 7.6 | 6.8 | 72.9 | 65.2 |
| Румыния | 1 | 15.0 | 17.1 | 78.7 | 89.7 |
| Сербия | 1 | 3.2 | 4.7 | 47.4 | 69.5 |
| Южная Корея | 1 | 16.2 | 23.1 | 31.3 | 44.6 |
В целом, географическая картина отражает скорее сочетание потенциала пивоваренной науки, общей исследовательской деятельности в области искусственного интеллекта и предвзятости при сборе данных, чем географию самого пивоваренного производства.
В дополнение к тематическому картированию, ссылки на цитирования, зафиксированные в корпусе, также были рассмотрены как сеть, где каждая публикация рассматривалась как узел, а каждая ссылка в корпусе — как направленное ребро. Из 394 ссылок, взятых из корпуса, 134 из 188 публикаций (71%) получают хотя бы одну ссылку из другой работы в выборке, в то время как 30 публикаций (16%, в основном начиная с 2017 года) не цитируются и не упоминаются ни в одной другой записи корпуса, что отражает тематическую фрагментацию области в ее более поздней, разнообразной фазе. В сети доминирует один кластер статей одной и той же австралийской исследовательской группы, на долю которой приходится шесть из десяти наиболее цитируемых работ и более половины (57%) собственных исходящих цитирований, что указывает на устойчивую индивидуальную исследовательскую программу, а не на широкое распространение в научном сообществе. Помимо этой группы, наиболее часто цитируемые работы — исследование электронного носа из Ирана [77], итальянская статья о компьютерном зрении [78] и чешское исследование классификации [79] — цитируются в нескольких несвязанных национальных группах и, следовательно, могут считаться более влиятельными в рамках корпуса. Ссылки на цитирование пересекают национальные границы примерно в 71% случаев, что указывает на то, что, несмотря на описанную выше географическую кластеризацию результатов, обмен идеями, представленный в корпусе, носит международный характер.
3. Искусственный интеллект в процессе пивоварения
Применение ИИ в пивоварении сильно различается в зависимости от этапа процесса. Один и тот же общий термин может относиться к анализу изображений сырья, прогнозированию параметров сусла или брожения, поддержке управления в процессе производства или обнаружению дефектов в упакованной продукции. Поскольку эти задачи используют разные данные и отвечают на разные технологические вопросы, в этом разделе рассматриваются приложения ИИ в зависимости от фазы пивоварения.
Следующие подразделы организованы по этапам разработки, то есть по измерению D1 в таблице 2. В каждом подразделе исследования сгруппированы по типу данных, с которыми они работают (D2), и по используемому вычислительному подходу (D3), а задача, выполняемая каждым исследованием (D4), указана в его описании, а не оставлена подразумеваемой. Это наиболее наглядно показано в разделе 3.7, где первые четыре подраздела напрямую соответствуют типам данных (летучие отпечатки с массивов химических датчиков, спектры, изображения и интегрированные многосенсорные платформы), а последние три соответствуют задачам: прогнозирование сенсорных характеристик и реакции потребителей, аутентификация и идентификация продукта, а также группа граничных случаев. Обзорные статьи обозначаются как таковые везде, где они обсуждаются, и описываются как обобщение литературы, а не как вклад в вычислительный подход; в соответствии с разделом 2, они не учитываются в числе вычислительных подходов.
3.1. Общие технологические применения
В нескольких предыдущих обзорах ИИ, машинное обучение и интеллектуальные технологии в пивоварении рассматривались как общеотраслевые темы. Виолино и др. рассмотрели интеллектуальные технологии в рамках концепции «Интернета пива», проследив производственную цепочку от затора до пинты [9]. Неттесхайм и др. представили систематический обзор, посвященный применению машинного обучения в процессе пивоварения [10]. Шлехтер обобщил влияние ИИ на пивоваренную промышленность с более широкой промышленной точки зрения [11]. Эти работы подтверждают, что методы, основанные на данных, актуальны для всего пивоварения, но в основном описывают эту область на высоком уровне. В следующих подразделах фокус сужается: как вычислительные подходы используются на конкретных этапах пивоварения, какие входные данные они требуют и какие технологические решения они поддерживают.
Су оптимизировал решения по производству пива, чтобы совместно максимизировать общий объем продаж и оценку качества [80], многоцелевая формулировка, в которой увеличение объема производства должно быть сбалансировано с качеством продукции.
Небольшая группа исследований использовала модели на основе нейронных сетей в более широком контексте, связанном с пивом, а не в рамках одной узко определенной технологической операции. Хлангвани и др. предложили метод моделирования для разработки биопроцесса для оптимального производства умкомботи, традиционного южноафриканского пива [81]. Этот тип работы актуален, поскольку он рассматривает производство пива как задачу проектирования и оптимизации процесса, где необходимо учитывать несколько технологических переменных одновременно. Ху и др. использовали искусственные нейронные сети вместе с PLS-SEM и IPMA для изучения крафтового пивного туризма, мотивации потребителей и потребительского поведения, связанного с напитками [82]. Хотя это исследование не сосредоточено на пивоваренных или погребных операциях, оно показывает, что вычислительные подходы, включенные в этот обзор, также применяются к более широкой цепочке создания стоимости пива, включая части сектора, ориентированные на потребителя.
Более обширная группа исследований, охватывающих весь процесс, касается цифровой инфраструктуры, необходимой для надежного использования ИИ на пивоварнях. В этих работах не всегда представлена одна конкретная модель прогнозирования для одного этапа пивоварения. Вместо этого они описывают, как данные могут быть собраны, связаны, обработаны и использованы на всей пивоварне. Недавно Неттесхайм и др. предложили концепцию проектирования пивоварения на основе данных в микропивоварнях, сочетающую архитектуру системы на основе датчиков с приложениями машинного обучения, направленными на обеспечение устойчивости [83]. Диас и др. обсудили цифровую трансформацию в производственных процессах микропивоварен с точки зрения бразильского рынка [84]. Обе работы актуальны для небольших пивоварен, где цифровые инструменты обычно должны быть модульными, недорогими и понятными для операторов.
Несколько исследований рассматривают пивоварение как среду производства Индустрии 4.0/5.0 или киберфизическую производственную среду. Ли и др. оценили инструменты с открытым исходным кодом для разработки гетерогенных цифровых двойников на основе моделей, используя в качестве примера микропивоварню [85]. Деузе и др. описали инфраструктуру обучения, основанную на машинном обучении и Интернете вещей, разработанную транснациональными киберфизическими пивоваренными лабораториями [86]. Шлехтер представил разработку и пример использования человекоцентричного пивоваренного завода, подготовленного для концепций Индустрии 5.0 [87]. Эти исследования показывают, что внедрение методов, связанных с ИИ, в пивоварении — это не только вопрос выбора алгоритма. В практическом производстве такие методы требуют датчиков, конвейеров данных, моделей процессов, человеко-машинных интерфейсов и интеграции с существующим оборудованием.
Другие работы связывают цифровизацию пивоварения с устойчивостью и экологичностью. Бриаторе и др. обсудили устойчивость 4.0 на линии по производству пива с использованием IoT, граничных вычислений, туманных вычислений и облачных вычислений [88]. Этот тип архитектуры актуален, когда данные должны обрабатываться на разных уровнях, от локального оборудования до облачных систем, и когда производственная линия должна реагировать на возмущения. Боулер и др. разработали калькулятор углеродного следа с открытым исходным кодом для цепочки создания стоимости крафтового пивоварения в Великобритании [89]. Маркович и др. обсудили инфраструктуры данных с поддержкой ИИ для обеспечения устойчивости в агропродовольственных системах, включая пример использования на пивоварне [90]. Ли и Пэн предложили многомасштабную структуру принятия решений на основе тензорных сетей для оптимизации переработки отходов пивоварения с целью достижения углеродной нейтральности [91], связывая решения, принимаемые в процессе, с явными экологическими целями. Эти исследования расширяют роль инфраструктуры, связанной с ИИ, за пределы управления процессом. Они связывают данные о пивоварении с энергопотреблением, экологической оценкой, управлением производством и долгосрочными целями устойчивого развития.
В целом, исследования, охватывающие весь производственный процесс, показывают, что применение ИИ в пивоварении не следует рассматривать только как изолированные модели, обученные для решения отдельных задач. Многие приложения сначала требуют наличия датчиков, подключенного оборудования, структурированных потоков данных и четких связей между переменными процесса и решениями, принимаемыми в процессе пивоварения. Таким образом, рассмотренные работы по цифровой трансформации, цифровым двойникам, киберфизическим лабораториям и устойчивому развитию обеспечивают основу для более конкретных приложений ИИ. Однако практическая роль ИИ становится более очевидной, когда отдельные этапы пивоварения рассматриваются отдельно. Поэтому следующие подразделы посвящены тому, как методы, основанные на данных, используются в оценке сырья, подготовке процесса, производстве сусла, ферментации, упаковке и обеспечении качества.
3.2. Сырье и лаборатория
Пиво производится из небольшого набора основных компонентов: воды, солода или других злаков, хмеля и дрожжей. Их качество влияет на процесс до начала затирания или брожения. В рассмотренных работах применение ИИ на этом этапе в основном используется для контроля, классификации, отбора и лабораторных измерений. Большинство работ посвящены ячменю, хмелю, дефектам зерна, обнаружению вредителей, оценке дрожжевых клеток или поддержке на уровне рецептуры.
На уровне обзора Патрисио и Ридер обсудили компьютерное зрение и ИИ в точном земледелии для зерновых культур [92]. Хотя этот обзор не ограничивается пивоварением, он актуален, поскольку качество солодового ячменя частично определяется до того, как зерно попадает в солодовню или пивоварню. Такая работа показывает, как контроль на основе изображений, мониторинг урожая и автоматическая классификация могут поддерживать управление сырьем на более раннем этапе цепочки поставок.
Классификация на основе датчиков была использована Ламанья и др., которые протестировали электронный нос для классификации хмеля [93]. Этот подход актуален для пивоварения, поскольку идентичность и качество хмеля тесно связаны с летучими соединениями. Исследование иллюстрирует общий принцип, используемый в более поздних приложениях, основанных на данных: химические или сенсорные различия, которые трудно оценить вручную, могут быть преобразованы в сигналы датчиков, а затем классифицированы вычислительным путем. Одди и др. использовали машинное обучение и парадигму Интернета вещей для прогнозирования созревания шишек хмеля [94]. Они сравнили два алгоритма машинного обучения для прогнозирования оптимального периода сбора урожая.
Отдельное приложение, связанное с сырьем, — это поддержка рецептов. Ревак предложил ИИ-помощника для крафтовых пивоварен, основанного на эвристических и встраиваемых моделях для рекомендаций рецептов пива [95]. Такая система не проверяет сырье в лаборатории, а вместо этого поддерживает выбор и сочетание ингредиентов на этапе рецептуры. Бравин и др. рассмотрели тот же этап с помощью генеративного подхода на основе трансформеров [96]. Авторы обучили конвейер трансформерных сетей на большом наборе данных общедоступных рецептов пива, чтобы предложить новые шаблоны рецептов, и использовали сгенерированный результат для приготовления экспериментального IPA. Эрми и др. использовали аналогичные общедоступные данные рецептов в обратном направлении, обучив глубокие нейронные сети прогнозировать химические свойства готового пива, включая содержание алкоголя, горечь и цвет, непосредственно из спецификации рецепта [97]. В совокупности эти исследования показывают, что вычислительные подходы могут поддерживать разработку рецептов посредством рекомендаций, генерации и прогнозирования ожидаемых свойств продукта до начала производства.
Большинство исследований в этом подразделе используют компьютерное зрение. К работам, связанным с хмелем, относятся набор данных UFOP-HVD для классификации сортов хмеля [98] и более позднее сравнение традиционного извлечения признаков и глубокого обучения для улучшения классификации сортов хмеля [99, 100]. Эти исследования показывают, как визуальные признаки образцов хмеля могут быть использованы для различения сортов, что может быть полезно для аутентификации, документирования или контроля качества.
Аналогичные подходы, основанные на изображениях, применялись к зерновым материалам. Рамирес-Паредес и Эрнандес-Бельмонте оценивали качество солодового ячменя, используя дескрипторы цвета, формы и текстуры [101]. Щипинский и Запоточный разработали алгоритм компьютерного зрения для идентификации зерен ячменя, оценки их ориентации и оценки структуры поверхности [102]. Гевара-Эрнандес и Гомес-Гил предложили систему машинного зрения для классификации зерен пшеницы и ячменя [103]. Позже Щипинский и др. использовали компьютерное зрение для идентификации сортов ячменя [104] и занимались идентификацией дефектов с использованием дескрипторов, извлеченных из отсканированных изображений зерен [105]. В том же направлении исследований Козловский и др. заменили созданные вручную признаки на сверточные нейронные сети, обученные непосредственно на изображениях зерен для классификации сортов [106], а затем расширили этот подход на идентификацию как дефектов, так и сортов солодового ячменя [107]. Эмбейале и др. аналогичным образом оценивали солодовый ячмень для пивоваренного производства с помощью сверточной нейронной сети, обученной на текстурных признаках [108]. В совокупности эти работы документируют прогресс от созданных вручную дескрипторов изображений к обученным представлениям и показывают, что анализ изображений может поддерживать быструю и воспроизводимую оценку свойств зерна, которые обычно оцениваются визуальным осмотром или лабораторной сортировкой.
В ряде работ для обнаружения загрязнения или повреждений зерна вредителями использовались методы визуализации. Форнал и др. использовали мягкое рентгеновское излучение и анализ изображений для обнаружения яиц и внутренних стадий развития амбарного долгоносика Sitophilus granarius в зерне пшеницы [109]. Бонецки и др. также использовали рентгеновские изображения для обнаружения зерен пшеницы, поврежденных амбарным долгоносиком [110]. Более поздние исследования представили нейронные подходы к обнаружению амбарного долгоносика, включая искусственные нейронные сети для идентификации Sitophilus granarius [111] и нейронное визуальное обнаружение того же вредителя в образцах зерна [112]. Эти исследования важны, поскольку внутреннее заражение может быть невидимым на поверхности зерна, но оно все же может повлиять на качество хранения и безопасность сырья.
Нейронные сети и машинное обучение также применялись в лабораторных и технологических задачах, помимо простой визуальной сортировки. Карвальял Пинто и др. использовали машинное обучение для повышения эффективности сушки хмеля Humulus lupulus L. [113]. Это связывает машинное обучение с послеуборочной обработкой, где условия сушки влияют на стабильность и качество хмеля. Вэй и др. использовали машинное зрение на основе нейронных сетей и темнопольную микроскопию для определения жизнеспособности клеток Saccharomyces cerevisiae без использования реагентов [114]. Фейзи и др. провели аналогичное измерение с использованием безлинзовой микроскопии на чипе в сочетании с классификацией на основе машинного обучения, сообщив о быстрой, портативной и не требующей реагентов оценке жизнеспособности дрожжей и концентрации клеток [115]. Оба исследования нацелены на параметры, актуальные до внесения дрожжей и во время обработки дрожжей, и иллюстрируют использование автоматизированных измерений на основе изображений в качестве альтернативы традиционной оценке клеток на основе окрашивания.
В целом, применение ИИ в сырьевых и лабораторных работах сосредоточено в области классификации, с меньшим количеством задач прогнозирования, таких как созревание хмеля, эффективность сушки и жизнеспособность дрожжей. Наиболее распространенный вычислительный подход — это компьютерное зрение, часто сочетающееся с извлечением признаков, машинным обучением или нейронными сетями. Эти подходы могут уменьшить субъективность визуальной оценки, ускорить скрининг образцов зерна и хмеля, а также обеспечить неразрушающие или безреагентные измерения. В то же время многие исследования остаются близкими к лабораторным наборам данных или прототипным системам. Их практическая ценность для пивоварен зависит от того, можно ли их интегрировать в рутинный учет сырья, контроль качества и разработку рецептур.
3.3. Планирование и подготовка
Планирование и подготовка производства пива — это скорее вычислительная задача, чем технологическая. В пивоварении производственный план должен определять, какое пиво производить, в каком количестве, когда начинать каждую партию и какие ресурсы следует использовать. Это сложно, поскольку пивоварение — это в основном периодический процесс. Мощность пивоварни, бродильные емкости, емкости для созревания, фильтрация, линии розлива, операции очистки и сроки поставки — все это создает ограничения. В информатике и исследовании операций этот тип задач обычно описывается как планирование, определение размера партии или распределение ресурсов. Планирование означает распределение производственных задач между ограниченными ресурсами во времени. Определение размера партии означает решение о том, сколько каждого продукта следует произвести в каждый плановый период. Эти решения важны на пивоварнях, поскольку первоначальные решения могут блокировать резервуары или линии на многие дни и влиять на последующую доступность.
Интеллектуальная оптимизация обеспечивает общую основу для таких проблем. Надыбский и Ревак обсуждали использование методов интеллектуальной оптимизации для повышения эффективности производственных процессов [116]. Хотя этот тип работы не ограничивается одной операцией пивоварения, он актуален, поскольку планирование пивоварни часто требует поиска приемлемых или близких к оптимальным решений при множестве ограничений. В этом контексте оптимизация не используется для непосредственного анализа пива. Она поддерживает принятие решений до начала производства или во время распределения ресурсов.
Несколько исследований рассматривали планирование пивоваренного производства с помощью классической оптимизации, составления графиков, определения размеров партий или прогнозирования спроса. Бальдо и др. предложили оптимизационный подход к задаче определения размеров партий и составления графиков в пивоваренной промышленности [117]. В более позднем исследовании Бальдо и др. сравнили альтернативные математические модели и подходы к решению задачи определения размеров партий и составления графиков пивоваренного производства в двух различных производственных ситуациях [118]. Саэнс-Аланис и др. изучали задачу планирования пакетной обработки на параллельных машинах в пивоваренном заводе [119]. Георгиадис и др. сосредоточились непосредственно на оптимальном планировании и составлении графиков производства на пивоварнях [120]. Эти исследования показывают, что планирование производства на пивоварне может быть формализовано как задача оптимизации с ограничениями, целью которой является эффективное использование резервуаров, линий и времени при одновременном выполнении производственных требований.
Чжэн и Дай сформулировали задачу планирования производства пива как междисциплинарную задачу оптимизации проектирования и решили ее с помощью схемы совместной оптимизации, в которой ограничение согласованности использует манхэттенское расстояние, а итерация обновляется алгоритмом роя хамелеонов [121]. Вклад носит скорее алгоритмический, чем специфический для пивоварни характер, но он иллюстрирует, почему метаэвристический поиск здесь привлекателен: связь между этапами пивоварения делает точную формулировку медленной для решения при реалистичных размерах задач. Липка и др. связали планирование с энергетической системой пивоварни, сформулировав смешанную целочисленную линейную программу, в которой время начала многомодальных пакетных процессов становится ресурсом гибкости для проектирования энергетической системы и диспетчеризации на сутки вперед [122]. Применение этой гибкости на действующем пивоваренном заводе лишь незначительно изменило оптимальную конструкцию системы, снизив требуемую емкость литий-ионных батарей примерно на десятую, но при этом уменьшило пиковую нагрузку на электросеть и годовые затраты на закупку на несколько процентов, причем большая часть выгоды была получена за счет задержки утренних партий всего на час.
Ревак предложил обобщенную структуру планирования пивоварни, охватывающую производство сусла, ферментацию, кондиционирование и упаковку, учитывающую гетерогенные емкости, разделение и объединение партий, очистку, ограничения персонала и неопределенное время обработки [123]. Их обзор 16 исследований показал, что ни одна из существующих моделей не охватывает весь производственный конвейер с таким уровнем операционной гибкости, что подчеркивает сквозное и стохастическое планирование как открытые проблемы.
Машинное обучение также может поддерживать планирование, прогнозируя будущие проблемы с производством или поставками. Ли использовал машинное обучение для прогнозирования задержек поставок на датских пивоварнях крафтового пива [124]. Эта задача не является планированием в строгом смысле слова, но она полезна для планирования, поскольку оценивает риск того, что спрос клиентов не будет удовлетворен вовремя. В другом исследовании, ориентированном на поставки, Неттесхайм и др. использовали моделирование для оценки того, как «умные» кеги могут улучшить логистику пивоварни [125], расширяя планирование на основе данных от производства к отслеживанию контейнеров и распределению. Ревак использовал дифференциальную эволюцию для генерации сценариев пивоварения для планирования периодического брожения на «умных» пивоварнях [126]. Это связывает классическое планирование с эволюционной оптимизацией в одной из наиболее ограничительных частей пивоваренного производства, поскольку бродильные емкости заняты в течение длительных и переменных периодов времени.
Нейронные сети и гибридные методы оптимизации использовались в другой группе исследований, связанных с планированием. Аканинвор и др. применили искусственную нейронную сеть прямого распространения для оптимизации производства и прибыли пивоваренного завода [127]. Модель была обучена на результатах линейного программирования для производства консервированного и бутылочного пива с учетом ограничений по сырью и использовалась для поиска более прибыльного распределения производства. Огбу и др. также объединили статистические подходы и методы машинного обучения для оптимизации производства в пивоваренной промышленности [128], сравнивая модели, основанные на данных, с традиционным анализом для выявления факторов, которые больше всего влияют на производительность производства. Такахаши и др. объединили искусственные нейронные сети с эволюционным алгоритмом для оптимизации процесса пивоварения [129]. Сунь предложил подход к планированию производства, основанный на генетическом алгоритме и нейронных сетях LSTM [130]. Хотя эта работа шире, чем просто пивоварение, она актуальна для планирования производства, поскольку сочетает прогнозирование последовательности с оптимизацией. Хассен и Асмаре использовали искусственные нейронные сети для моделирования прогнозируемой эффективности очистных сооружений сточных вод пивоварни «Хабеша» [131]. Это исследование касается вспомогательной пивоваренной установки, а не самого производства пива, но оно показывает, как нейронные модели могут поддерживать планирование и управление коммунальными службами, связанными с пивоварением.
В наиболее системно-ориентированных исследованиях планирование описывается как часть цифровой инфраструктуры пивоварни. Микейн и др. разработали систему поддержки принятия решений для планирования производства на пивоварне Feldschlösschen [132]. Та же группа расширила эту работу до стратегического планирования, сформулировав специфическую для пивоварни многоуровневую задачу определения размера партии с учетом ограничений по мощности, которая охватывает сроки выполнения, срок годности, многоуровневые процессы и ограничения резервуаров для хранения, и решив ее с помощью эвристики «фиксация-ослабление-оптимизация» на основе приоритетов [133]. Исследование примечательно тем, что модель планирования используется для ответа на стратегический, а не оперативный вопрос, а именно, как добавление продукции с низким спросом влияет на производственную систему в целом.
Кулурис и др. рассмотрели применение моделей процессов и цифровых двойников для моделирования производства и планирования при изготовлении пищевых ингредиентов и продуктов [134]. Вёстманн и др. предложили оптимизацию рецептов на основе данных с использованием унифицированных цифровых двойников и общих моделей прогнозирования [135]. Шлехтер и др. предложили концепцию бизнес- и производственного инжиниринга для индивидуального пивоварения с использованием методов цифровизации [136]. Ревак и Русецки представили надежное планирование ресурсов в интеллектуальных пивоварнях с помощью цифрового двойника гибких процессов периодического брожения [137]. Эти работы показывают, что планирование может поддерживаться цифровыми представлениями рецептов, ресурсов, ограничений процесса и состояний производства. Цифровой двойник может использоваться для тестирования вариантов рецептов, графиков и конфликтов ресурсов без нарушения работы реального предприятия.
В целом, приложения, связанные с ИИ, в планировании и подготовке отличаются от приложений на более поздних этапах пивоварения. Обычно они не измеряют напрямую дефекты сусла, пива или упаковки. Вместо этого они поддерживают принятие решений о рецептах, партиях, ресурсах, мощностях и сроках. Классическая оптимизация обеспечивает математическую основу для многих из этих задач, в то время как машинное обучение, нейронные сети и эволюционные алгоритмы добавляют возможности прогнозирования или поиска. Системы поддержки принятия решений и цифровые двойники обеспечивают более широкий вычислительный и операционный контекст для моделирования и планирования. Рассмотренная литература по планированию также указывает на то, что интегрированные модели, охватывающие несколько этапов производства, разнородное оборудование и неопределенное время обработки, остаются сравнительно недостаточно разработанными. Таким образом, планирование представляет собой важный этап, на котором вычислительные подходы могут поддерживать эффективность пивоварни до и на протяжении всего физического производственного процесса.
3.4. Затирание, фильтрация, кипячение и охлаждение
Затирание, фильтрация, кипячение и охлаждение составляют основную часть процесса производства сусла в пивоварении. На этом этапе сырье превращается в сусло, нерастворимые вещества отделяются, сусло кипятится, а горячая жидкость охлаждается перед ферментацией. Поэтому приложения, связанные с ИИ, на этом этапе процесса в основном связаны с оценкой процесса, прогнозированием свойств сусла, управлением теплом и водой, обнаружением загрязнений и оптимизацией условий эксплуатации. По сравнению с проверкой сырья, данные чаще представляют собой зависящие от времени измерения процесса, данные об энергии или переменные, описывающие эффективность экстракции и разделения. Ранним примером является работа Сарабии и др., которые применили нейронные сети для управления фильтрационным чаном, используя измерения процесса для управления отделением сусла от отработанного зерна [138]. Это одно из немногих приложений, основанных на данных, непосредственно касающихся фильтрации, где мутность и поведение потока влияют как на выход экстракта, так и на продолжительность процесса.
В некоторых работах этот этап описывается с помощью цифровой или интеллектуальной производственной инфраструктуры. Пого и др. разработали виртуальную среду для процесса затирания и кипячения в производстве крафтового пива [139]. Такие системы актуальны, поскольку они могут помочь представить состояния процесса и поддержать обучение операторов или анализ процесса без использования реального пивоваренного цеха. Нимбалкар и др. обсудили использование интеллектуальных производственных технологий для повышения эффективности и производительности пивоварен [140]. В контексте производства сусла этот тип работы связывает датчики, данные процесса и эффективность производства, а не фокусируется на одной изолированной модели.
Компьютерное зрение также использовалось для непосредственной оценки процесса затирания. Сонг и др. разработали систему машинного зрения на основе машинного обучения для оценки процесса затирания в пивоварении [141]. Это ранний пример использования информации на основе изображений для оценки этапа процесса, который обычно оценивается с помощью технологических параметров и опыта оператора. Это показывает, что машинное обучение может применяться не только к сырью или конечной продукции, но и к промежуточным состояниям процесса во время производства сусла.
В этом подразделе наибольшую группу составляют модели на основе нейронных сетей. Рембольд и др. использовали сеть LSTM для прогнозирования плотности сусла [142]. Это типичная задача прогнозирования процесса, поскольку плотность сусла является ключевым параметром для контроля экстрактивности и последующей эффективности брожения. Эстраканхолли и др. количественно определяли содержание углеводов в пивном сусле в режиме реального времени, сочетая ИК-спектроскопию с анализом нейронной сети [143], обеспечивая быструю обратную связь по составу во время производства сусла, которая в противном случае потребовала бы более медленных лабораторных анализов. Прибич и др. объединили искусственную нейронную сеть с генетическим алгоритмом для моделирования и оптимизации производства сусла из тритикале [144]. В этом случае нейронная сеть использовалась для описания реакции процесса, в то время как алгоритм оптимизации искал лучшие условия производства. Управление энергией и коммунальными услугами представляет собой смежное применение. Бай и др. использовали нейронные сети для анализа распределения энергопотребления на этапах пивоварения и для выявления потенциальных возможностей экономии [145]. Позже Кондуа и др. использовали модели на основе ИНС для прогнозирования энергопотребления в микропивоварнях и связали это с решениями для теплового аккумулирования [146]. В совокупности эти исследования иллюстрируют переход от анализа энергопотребления на уровне всего процесса к прогнозированию энергопотребления на уровне пивоварни. Это актуально для производства сусла, поскольку затирание, кипячение и охлаждение являются теплоемкими операциями, а потребление энергии составляет значительную долю производственных затрат пивоварни [147].
Несколько исследований нейронных сетей касаются побочных потоков, теплообмена или вспомогательных процессов, связанных с работой пивоварни. Коста Жуниор и др. смоделировали извлечение фенольных соединений из жома пивного солода с помощью искусственной нейронной сети [148]. Девасме разработал программные датчики на основе нейронных сетей для оценки ключевых компонентов в анаэробном реакторе для очистки сточных вод пивоварни [149]. Акинпелу и др. объединили методологию поверхности отклика и искусственные нейронные сети для оптимизации очистки кислых шахтных стоков с использованием сточных вод пивоварни [150]. Эти исследования не моделируют непосредственно затирание или кипячение, но они показывают, как модели, основанные на данных, могут быть применены к побочным потокам и вспомогательным процессам, связанным с производством пива.
Системы охлаждения и теплопередачи рассматривались с помощью гибридных и мягких методов измерения. Риверол и Наполитано оценили общий коэффициент теплопередачи трубчатого теплообменника при загрязнении с помощью нейронной сети и применили модель к пастеризатору пива [151]. Хоу и др. использовали метод мягкого измерения для онлайн-измерения загрязнения в испарителе сусла пивоварни [152]. Позже Хоу и Чжоу расширили эту работу, используя гибридную нечеткую нейронную сеть для оценки периодического загрязнения при чередовании производственных рецептов [153]. Эти исследования иллюстрируют принцип мягкого измерения, при котором загрязнение или эффективность теплопередачи определяются на основе общедоступных измерений процесса, а не измеряются напрямую. Впоследствии Эдгар и др. предложили гибридную термодинамическую оптимизацию и оптимизацию машинного обучения характеристик пластинчатого теплообменника для систем охлаждения пивоварни [154]. В совокупности эти области применения актуальны для процессов теплопередачи на пивоваренных заводах, поскольку загрязнение и производительность теплообменника влияют на время процесса, энергопотребление, требования к очистке и подготовку к брожению.
В других исследованиях для улучшения процесса использовались статистические или оптимизационные методы. Шен и др. разработали статистическую модель для оптимизации эффективности разделения затора в промышленном пивоварении [155]. Эта работа напрямую связана с фильтрацией или разделением затора, где целью является эффективное извлечение экстракта при сохранении стабильного технологического потока. Петтигрю и др. оптимизировали использование воды в системе очистки на месте на пивоварне с использованием эталонных сетей [156]. Хотя очистка не является реакцией производства сусла, она является частью подготовки и обслуживания оборудования пивоварни и сильно влияет на потребление воды. Аль-Рифаи и Кавацца представили многоцелевую эволюционную оптимизацию пива [157]. Такие подходы полезны, когда необходимо одновременно сбалансировать несколько технологических или продуктовых целей.
Одно из более масштабных исследований связывает переменные процесса с конечным сенсорным качеством. Шреурс и др. использовали машинное обучение для прогнозирования и улучшения сложного вкуса пива [158]. Эта работа не ограничивается затиранием или кипячением, но она актуальна здесь, поскольку условия производства сусла влияют на предшественники вкуса и последующие свойства продукта. Она также показывает, что модели могут связывать ранние решения процесса с результатами качества, измеряемыми в конце производства.
В целом, применение искусственного интеллекта в процессах затирания, фильтрации, кипячения и охлаждения сосредоточено на прогнозировании, оптимизации и повышении эффективности использования ресурсов. Наиболее наглядные примеры касаются плотности сусла, оценки процесса затирания, разделения затора, теплообмена и энергопотребления в процессе. Другие работы распространяют ту же логику моделирования на сточные воды, очистку, побочные потоки и результаты, связанные с вкусом. В совокупности эти исследования показывают, что вычислительные подходы в производстве сусла не ограничиваются одной технологической операцией. Они также могут поддерживать более широкую техническую среду, необходимую для эффективного и стабильного производства сусла до начала брожения.
3.5. Ферментация
Ферментация — одна из наиболее изученных фаз пивоварения в литературе, посвященной искусственному интеллекту. Это неудивительно, поскольку ферментация — длительный, динамичный и биологически обусловленный процесс. На этом этапе дрожжи превращают сбраживаемые сахара в этанол, углекислый газ и множество ароматических соединений. Процесс также меняется со временем, и не все важные переменные легко измерить напрямую или непрерывно. По этой причине многие вычислительные подходы, применяемые к ферментации, сосредоточены на оценке состояния, прогнозировании траекторий процесса, онлайн-мониторинге, поддержке управления и раннем обнаружении отклонений.
На уровне обзора Ю и др. обсудили подходы на основе ИИ для разработки традиционных ферментированных алкогольных напитков [159]. Этот обзор шире, чем пиво, но он актуален, поскольку помещает брожение пива в более широкую группу микробных процессов производства напитков, где ИИ может поддерживать рецептуру, мониторинг и оптимизацию. Василева и Милева ранее описали программные инструменты на основе ИИ для мониторинга и контроля пивоварения [160]. Эта работа важна как ранний процессно-ориентированный взгляд на ИИ в пивоварении, где основная роль вычислительных инструментов заключалась в том, чтобы помочь наблюдать и контролировать брожение, а не заменять технологическую экспертизу.
В недавней серии исследований ферментация рассматривается с помощью цифровых моделей и цифровых двойников. Эти системы сами по себе не являются методами ИИ, но могут обеспечить контекст моделирования и развертывания для мониторинга и управления на основе данных. Даззарола и др. разработали цифровую модель для контроля качества пива, интегрировав данные промышленного процесса с дескрипторами ферментации на основе модели [161]. Этот подход актуален, поскольку он связывает данные о производстве с интерпретируемыми дескрипторами поведения ферментации, а не рассматривает процесс только как задачу прогнозирования «черного ящика». Муктадир и др. сосредоточились на управлении согласованностью модели в цифровом двойнике пивоварни [162]. Это решает практическую проблему использования цифровых двойников: модели должны оставаться согласованными при изменении данных процесса, допущений или компонентов системы. Гоффи и др. разработали цифровой двойник для мониторинга и контроля отбора проб при ферментации пива [163]. В этом случае цифровой двойник поддерживает конкретную операционную задачу, а именно отбор проб, что по-прежнему важно на пивоварнях, поскольку лабораторные измерения часто остаются частью контроля ферментации.
Другие исследования были сосредоточены на определении текущей фазы или состояния брожения. Буонокоре и др. предложили онлайн-идентификацию фаз брожения пива [164]. Это полезная задача, поскольку технологическое значение переменных процесса зависит от фазы брожения; одно и то же измерение может указывать на нормальный прогресс на одном этапе и отклонение на другом. Ванн и др. применили ближнеинфракрасную спектроскопию для онлайн-мониторинга критических параметров брожения и интегрировали эти измерения в стратегию управления с опережающей обратной связью [165]. Эта работа связывает аналитические измерения с управлением, показывая, как быстрая спектральная информация может быть использована для поддержки решений во время брожения, а не только после лабораторного анализа.
3.5.1. Нейронные сети в процессе ферментации
Нейронные сети имеют долгую историю применения в моделировании процесса брожения пива. В ранних исследованиях их использовали, поскольку брожение сложно полностью описать с помощью простых механистических уравнений. Рост дрожжей, поглощение сахара, образование этанола, влияние температуры и образование ароматических соединений взаимосвязаны, но их взаимосвязи нелинейны и изменяются в течение всего процесса. Нейронные сети предложили способ изучения этих взаимосвязей на основе данных процесса и поддержки прогнозирования или управления.
Д’Аморе и др. представили моделирование с помощью нейронных сетей как область применения для пивоваренных процессов [166]. Сю и др. использовали нейронные сети для прогнозирования пивоваренных процессов [167]. Гарсия и др. применили нейронные сети для контроля и прогнозирования параметров качества во время брожения пива [168]. Эти ранние исследования заложили направление, которое оставалось важным в последующих работах: нейронные модели могут дополнять знания о пивоварении, оценивая, как, вероятно, будет развиваться процесс на основе измеренных переменных.
Несколько ранних работ были посвящены оценке состояния в реальном времени и прогнозированию процесса. Симутис и др. предложили нейронную сеть с поддержкой нечеткой логики для оценки состояния в реальном времени и прогнозирования на этапе образования спирта при пивоварении в промышленных масштабах [169]. Гваздайтис и др. объединили нейронные сети с обратной связью для регулирования температуры в ферментерах пивоварен [170]. Русу и др. изучали прогнозирование скорости брожения пива в лабораторных и промышленных масштабах [171]. Корриё и др. рассмотрели онлайн-оценку и прогнозирование плотности и изменения содержания этанола в процессе брожения в пивоварении [172]. Эти работы показывают, что нейронные модели уже использовались для переменных, которые являются центральными для практического управления брожением: температура, скорость брожения, плотность и образование этанола.
Более поздние исследования расширили этот подход на более широкое прогностическое и промышленное моделирование. Трелеа и др. сравнили прогностические модели пивоваренного брожения, от моделей, основанных на знаниях, до подходов «черного ящика» [173]. Беккер и др. использовали динамические нейронные сети для онлайн-оптимизации промышленного брожения [174]. Ассиджо и др. применили искусственные нейронные сети для моделирования промышленного пивоварения [175]. В совокупности эти исследования знаменуют переход от изолированных задач прогнозирования к более интегрированным моделям поддержки процесса, где модели, основанные на данных, используются для отслеживания динамики брожения и поддержки оперативных решений во время производства.
3.5.2. Более новые модели
В недавних исследованиях мы вернулись к динамике брожения, используя новые последовательные модели и неинвазивные измерения. О’Брайен и др. использовали авторегрессивные рекуррентные нейронные сети для моделирования и прогнозирования динамики брожения пива в смешанной культуре [176]. В более позднем исследовании О’Брайен и др. использовали сети LSTM для моделирования динамики брожения пива [177]. Эти модели подходят для брожения, поскольку они могут использовать предыдущие состояния процесса для прогнозирования последующего поведения, что важно в периодическом процессе, где текущее состояние сильно зависит от предыдущей траектории.
Сипос и др. использовали нейронные сети для получения косвенной информации о переменных состояния в процессе спиртового брожения [178]. Этот тип работы актуален, когда важные переменные процесса не могут быть измерены в режиме реального времени с достаточной частотой или надежностью. Вместо прямого измерения каждой переменной модель может оценивать скрытые или трудноизмеримые состояния на основе доступных сигналов.
Боулер и др. использовали ультразвуковые измерения и машинное обучение для прогнозирования концентрации алкоголя во время брожения пива [179]. Ультразвуковой мониторинг полезен, поскольку он может предоставлять неинвазивную информацию о процессе без повторного ручного отбора проб. В аналогичной работе Боулер и др. изучали адаптацию домена и федеративное обучение для ультразвукового мониторинга брожения пива [180]. Это решает практическое ограничение многих наборов данных пивоварен: модели, обученные в одной среде, могут не переноситься напрямую на другую пивоварню, емкость или продукт. Поэтому адаптация домена и федеративное обучение актуальны, когда модели брожения необходимо совместно использовать или адаптировать без простого объединения всех исходных данных.
3.5.3. Продукты ферментации
Другая группа исследований использовала модели, основанные на данных, для связи ферментации с качеством продукта. Это важно, потому что ферментация не только уменьшает экстрактивность и производит этанол. Она также формирует аромат, кислотность, свойства, связанные с пенообразованием, и другие качественные характеристики, влияющие на конечное пиво. Гарсия и др. смоделировали образование эфиров в процессе промышленной ферментации пива [181]. Позже Риверол и Куни использовали нейронные сети для оценки образования эфиров во время ферментации пива [182]. Эти исследования сосредоточены на соединениях, которые имеют важное технологическое значение, поскольку эфиры в значительной степени влияют на аромат пива и зависят от метаболизма дрожжей и условий ферментации.
В других работах прогнозировались химические или функциональные свойства, связанные с качеством. Чжан и др. использовали нейронные сети и машины опорных векторов для прогнозирования содержания уксусной кислоты в конечном пиве [183]. Милева и Васильева применили прогнозирование на основе ИНС к антиоксидантным характеристикам во время пивоваренного брожения [184]. Эти примеры показывают, что прогностические модели могут использоваться не только для переменных процесса, таких как плотность или этанол, но и для показателей качества, которые обычно оцениваются позже или требуют лабораторного анализа.
Оптимизация формирования аромата также изучалась как задача управления. Трелеа и др. рассмотрели динамическую оптимизацию производства аромата в процессе пивоварения [185]. Эта работа актуальна, поскольку в ней рассматривается формирование вкуса как процесс, который может регулироваться условиями процесса, а не только наблюдаться после ферментации. Вьехо и др. использовали машинное обучение для моделирования влияния обработки звуковыми волнами на пенообразование и сенсорные свойства пива [186]. Хотя это исследование не является стандартным случаем управления ферментацией, оно связывает обработку процесса, сенсорный отклик и прогностическое моделирование, что соответствует более широкому использованию вычислительных моделей для разработки процессов, ориентированных на качество.
3.5.4. Неинвазивный мониторинг
Спектроскопические измерения в сочетании с хемометрическим и многомерным моделированием образуют еще одну важную группу исследований по мониторингу ферментации. Эти подходы полезны, поскольку позволяют оценить несколько параметров процесса на основе одного быстрого измерения, часто с ограниченной подготовкой образца. Грасси и др. использовали ИК-спектроскопию с преобразованием Фурье и многомерным анализом данных для мониторинга параметров ферментации пива [78]. Джовенцана и др. применили спектроскопию видимого/ближнего инфракрасного диапазона для быстрой оценки качества крафтового пива во время ферментации [187]. Оба исследования показывают, как спектральные данные могут быть преобразованы в практическую информацию о ходе ферментации и качестве продукта.
Франса и др. предложили единую модель для мониторинга многоступенчатого производства крафтового пива с использованием ближнеинфракрасной спектроскопии и хемометрики [188]. Это актуально, поскольку производство крафтового пива может включать несколько взаимосвязанных этапов процесса, в то время как пивоварням часто требуются простые аналитические инструменты, которые могут работать на нескольких этапах. Рейд и др. предсказали скорость брожения в эле, лагере и виски [189]. Хотя это исследование включает как виски, так и пиво, оно полезно в этом контексте, поскольку рассматривает скорость брожения как измеримую и предсказуемую характеристику процесса при различных стадиях алкогольного брожения.
В совокупности эти исследования показывают, что мониторинг ферментации на основе данных зависит не только от нейронных сетей. Хемометрические и многомерные модели, применяемые к спектральным данным, также могут способствовать более быстрой оценке процесса. Их основная ценность носит практический характер: они могут уменьшить зависимость от медленных лабораторных измерений и предоставить более раннюю информацию о состоянии ферментации, развитии качества и ожидаемой продолжительности процесса.
3.5.5. Управление и оптимизация
Контроль и оптимизация составляют еще одну группу исследований ферментации в рамках оперативной области данного обзора. В этих работах используются модели не только для описания ферментации, но и для поддержки решений о том, как следует управлять процессом. Торо и др. использовали генетические алгоритмы для оптимизации процесса периодической ферментации [190]. Это актуально, поскольку управление ферментацией часто требует поиска среди множества возможных рабочих профилей, например, температурных или стратегий подачи, чтобы найти условия, которые улучшат результат процесса.
Нечеткая логика и когнитивные методы также исследовались для управления и прогнозирования процесса пивоварения. Ранним примером является нечеткий предиктор, разработанный Уитнеллом и др. для времени брожения на коммерческом пивоваренном заводе, который кодировал опыт оператора в виде градуированных правил, а не полагался на явную кинетическую модель [191]. Это одно из самых ранних приложений, основанных на знаниях о брожении, в корпусе. Позже О’Коннор и др. изучали интеграцию процедур управления на основе нечеткой логики в пивоварении [192]. Курц и др. рассматривали наблюдение и контроль брожения пива с использованием когнитивных методов [193]. Эти подходы полезны, когда знания о процессе частично носят качественный характер, например, когда опыт оператора может быть выражен в виде правил, а не в виде точных уравнений.
Другие исследования были сосредоточены на структуре модели, изменчивости процесса и оценке параметров. Спирс и др. использовали нелинейное моделирование для промышленных процессов пивоварения [194]. Дефернес и др. моделировали изменчивость между промышленными процессами брожения пива, изучая, какая часть вариаций от партии к партии может быть отнесена к измеримым факторам процесса [195]. Это дополняет модели средней траектории брожения, рассматривая, как и почему отдельные партии могут отклоняться от типичного поведения. Замудио Лара и др. изучали оценку параметров динамических моделей брожения пива [196]. Такая работа важна, поскольку для использования модели брожения для прогнозирования, моделирования или управления необходимы надежная структура модели и параметры. Лавриньчук объединил онлайн-оптимизацию заданных значений с предиктивным управлением процессом дрожжевого брожения с использованием подхода на основе нейронных сетей [197]. Это связывает нейронное моделирование с решениями по управлению, где модель помогает выбирать более оптимальные заданные значения в процессе.
3.5.6. Другие области применения
Методы компьютерного зрения и микроскопии образуют меньшую, но отдельную группу исследований ферментации. Маляр и др. предложили алгоритм компьютерного зрения для идентификации основных стадий пивного брожения [198]. Этот подход полезен, когда визуальная информация о броженном пиве может быть связана с ходом процесса. Дитлер и др. разработали сверточную нейронную сеть для точной сегментации микроскопических изображений дрожжей [199]. Хотя эта работа охватывает более широкий круг вопросов, чем только пивоварение, она актуальна для лабораторий ферментации, поскольку морфология дрожжей и наблюдения на клеточном уровне могут поддерживать микробиологическую оценку процесса.
Процесс ферментации также изучался с точки зрения энергопотребления и охлаждения. Ховард и др. использовали многоагентное моделирование для оптимизации энергетической гибкости в процессе охлаждения при ферментации в пивоварении [200]. В аналогичном исследовании Ховард и др. проанализировали потенциал энергетической гибкости 239 датских пивоварен с использованием многоагентного моделирования [201]. Эти работы не моделируют метаболизм дрожжей напрямую, но они актуальны, поскольку ферментация требует контролируемой температуры в течение длительных периодов времени. Поэтому потребность в охлаждении может стать серьезным операционным ограничением, особенно когда одновременно работает много ферментеров.
В целом, ферментация является одной из наиболее широко изученных и методологически разнообразных областей литературы по пивоварению, связанной с искусственным интеллектом. Рассмотренные исследования охватывают прогнозирование с помощью нейронных сетей и рекуррентных моделей, хемометрический анализ спектроскопических данных, мягкое зондирование, нечеткое управление, оптимизацию с помощью генетических алгоритмов, компьютерное зрение и многоагентное моделирование, а также цифровые двойники, которые обеспечивают более широкий контекст моделирования и внедрения. Большинство приложений решают одну из трех практических задач: оценка текущего состояния ферментации, прогнозирование развития процесса или поддержка решений по управлению и оптимизации. Такая концентрация исследований отражает технологическую важность ферментации. Это точка, где биологическая активность, время процесса, контроль температуры, формирование аромата и производственная мощность встречаются в одной динамической системе.
3.6. Упаковка
Упаковка — это заключительный этап производства, на котором пиво переносится из производственной среды в потребительскую или распределительную тару. На этом этапе приложения, связанные с искусственным интеллектом, меньше внимания уделяют биохимическим преобразованиям и больше — проверке, обнаружению, отслеживанию и контролю операций по упаковке. Основные задачи включают проверку пустых бутылок, обнаружение дефектов, проверку уровня наполнения и герметичности укупорки, идентификацию бутылок или ящиков, а также оценку упакованного продукта без вскрытия тары. Поэтому большинство исследований в этом подразделе основаны на компьютерном зрении, обнаружении объектов или неинвазивном зондировании.
Ранние работы в этой области были сосредоточены на машинном зрении для проверки бутылок. Дуань и др. предложили систему проверки пустых бутылок на основе машинного зрения [202]. В более позднем исследовании Дуань и др. разработали систему машинного зрения для проверки пивных бутылок [203]. Хуан и др. также изучали технологии машинного зрения для систем проверки пустых бутылок [204]. Эти системы отвечают практической потребности заводов по розливу: бутылки необходимо быстро и последовательно проверять перед розливом, поскольку загрязнение, трещины, остатки материала или дефекты формы могут повлиять на безопасность, качество и эффективность линии.
Другие исследования были сосредоточены на конкретных задачах контроля упаковочной линии. Язди и др. разработали алгоритм извлечения признаков для проверки уровня наполнения и крышек в разливочной машине [205]. Мусич и др. предложили датчик на основе изображений для мониторинга уровня жидкости во время розлива, с применением в крафтовом и домашнем пивоварении [206]. Эти работы важны, поскольку неправильный уровень наполнения или ошибки в укупорке напрямую влияют на консистенцию продукта, соответствие нормативным требованиям и восприятие потребителями. Кампос и др. использовали компьютерное зрение для проверки ящиков с бутылками в пивоваренной промышленности [207]. Это расширяет проблему проверки от отдельных бутылок до логистики упаковки, где состояние ящика и правильное размещение бутылок также важны для автоматизированной обработки.
В последних исследованиях все чаще используется глубокое обучение для обнаружения и классификации. Лян и др. предложили автоматизированную систему контроля дефектов пивных бутылок на основе глубокого остаточного обучения [208]. Реммельцваал использовал глубокое обучение для обнаружения объектов и отслеживания ящиков и бутылок на заводе по розливу [209]. Хольфельд и др. применили обнаружение объектов и трансферное обучение для классификации пивных бутылок [210]. Эти исследования показывают переход от визуального распознавания, разработанного вручную, к моделям, которые изучают соответствующие шаблоны изображений на основе данных. Это полезно в розливе, поскольку дефекты, этикетки, типы бутылок и конфигурации ящиков могут различаться в зависимости от продукта и производственной линии.
Связанное направление — это проверка через упаковку. Харрис и др. использовали неинвазивную спектроскопию через бутылку в сочетании с машинным обучением для поддержки аутентификации пива, оценки качества и контроля [211]. Эта работа находится на границе между упаковкой и обеспечением качества. Она актуальна здесь, поскольку измерение проводится на упакованном продукте, где бутылка становится частью аналитической задачи. Такие методы могут помочь оценить качество пива без вскрытия упаковки или прерывания цепочки распределения.
В целом, в сфере применения ИИ в упаковке преобладают методы визуального контроля и классификации. По сравнению с ферментацией или производством сусла, модели обычно не используются для описания динамики процесса. Вместо этого они поддерживают высокопроизводительные решения о том, является ли бутылка, крышка, уровень наполнения, ящик или упакованный продукт приемлемыми. Таким образом, упаковка представляет собой наглядный пример использования компьютерного зрения и связанных с ним вычислительных подходов для поточного контроля и автоматизации в конце процесса пивоварения.
3.7. Обеспечение качества
Обеспечение качества — это самая широкая группа приложений, связанных с искусственным интеллектом, в рассмотренной литературе. В отличие от более ранних этапов пивоварения, оно не относится к одной конкретной технологической операции. Оно охватывает оценку готового или почти готового продукта, включая подлинность, стиль пива, фирменную идентичность, аромат, вкус, цвет, пену, дефекты, приемлемость для потребителей и качество упакованного продукта. Один и тот же вопрос качества может изучаться с использованием различных типов данных, таких как изображения, сигналы электронного носа, спектроскопия, химические отпечатки, сенсорные оценки или отзывы потребителей.
Несколько обзоров показывают, что оценка качества пива стала одной из основных областей, где применяются хемометрические подходы, компьютерное зрение и машинное обучение. Да Коста и др. рассмотрели использование хемометрических алгоритмов и алгоритмов машинного обучения для аутентификации пива [212]. Эта работа актуальна, поскольку аутентификация является центральной задачей обеспечения качества: модель проверяет не только приемлемость пива, но и соответствие его химического или сенсорного профиля заявленному происхождению, стилю или идентичности.
Лукинац и др. рассмотрели методы компьютерного зрения в оценке качества пива [213]. Этот обзор охватывает важную часть визуального контроля качества, где цвет, пена, пузырьки, прозрачность и внешний вид могут быть количественно оценены по изображениям, а не только визуально. Такие методы привлекательны для пивоварен, поскольку они могут быть быстрыми, неразрушающими и проще в стандартизации, чем ручная оценка.
Вьехо и др. обсудили новые технологии на основе ИИ для оценки качества напитков и потребительских предпочтений [214]. Хотя этот обзор шире, чем просто пиво, он важен для этого раздела, поскольку связывает инструментальную оценку качества с оценкой, ориентированной на потребителя. В случае с пивом эта связь особенно актуальна: технически правильный продукт все еще может отличаться по приемлемости, восприятию аромата, восприятию пены или ожиданиям стиля. Эти обзоры показывают, что обеспечение качества на основе ИИ в пивоварении — это не одна задача, а набор взаимосвязанных проблем, объединяющих аналитические измерения, визуальный осмотр, сенсорную науку и идентичность продукта.
3.7.1. Электронные носы, массивы датчиков и летучие отпечатки пальцев
Значительная часть исследований в области обеспечения качества пива с использованием искусственного интеллекта основана на данных о летучих соединениях. Аромат пива формируется множеством соединений, присутствующих в различных концентрациях, и дефекты качества могут проявляться как изменения в профиле летучих соединений, а не как один легко измеряемый параметр. Электронные носы и связанные с ними массивы датчиков генерируют паттерны отклика датчиков, а для интерпретации этих паттернов используются модели классификации или прогнозирования.
В ранних работах Гарднера и др. использовалась многосенсорная система на основе проводящих полимеров и предиктивных классификаторов для мониторинга вкуса пива [215]. Позже Циосек и Вроблевски использовали проточный массив датчиков с миниатюрными твердотельными электродами для распознавания пива [216]. Эти исследования демонстрируют основную идею, лежащую в основе многих более поздних применений: образцы пива могут быть представлены многомерными сигналами датчиков, а вычислительные модели затем могут различать продукты или состояния качества.
Несколько работ были посвящены непосредственно электронным носам для распознавания и классификации пива. Порнпаномчай и Сутхамсмаи изучали классификацию пива с помощью электронного носа [217]. Гасеми-Варнамхасти и др. обсуждали потенциальное применение технологии электронного носа на пивоварнях [77]. Та же исследовательская группа использовала данные электронного носа для характеристики «отпечатков» старения пива [218]. Позже Гасеми-Варнамхасти и др. сравнили более простые методы классификации с машинным обучением для бинарной дискриминации пива с использованием данных электронного носа [219]. Сиадат и др. применили контролируемые искусственные нейронные сети для распознавания пива на основе ответов электронного носа [220]. Эти работы демонстрируют постепенный переход от классификации на основе концепции к более явной интерпретации сенсорных паттернов с помощью машинного обучения.
Электронные носы также используются для обнаружения дефектов и более специфических задач контроля качества. Сантос и Лозано разработали портативный электронный нос для обнаружения дефектов пива в режиме реального времени [221]. Сантос и др. рассмотрели применение электронных носов в пивоварении [222]. Восс и др. предложили прототип для определения содержания алкоголя в пиве с помощью электронного носа [223]. Либоа и др. использовали датчики на основе оксидов металлов (MOX) для анализа образцов пива в режиме реального времени и определения различных уровней восприятия диацетила [224]. Эти примеры важны, поскольку они выходят за рамки идентификации продукта и затрагивают качественные характеристики, которые непосредственно важны для контроля качества на пивоварне, такие как риск появления посторонних привкусов, уровень алкоголя и восприятие дефектов.
Извлечение признаков — повторяющаяся проблема в анализе электронного носа. Мен и др. предложили стратегию извлечения признаков для классификации пива на основе данных датчика электронного носа [225]. Нимсук повысил точность классификации пива, используя переходные признаки в сигналах электронного носа [226]. Мен и др. также изучали слияние данных из сигналов электронного языка и электронного носа для классификации вкуса пива [227]. Эти исследования показывают, что качество модели зависит не только от классификатора, но и от того, как обрабатываются ответы датчиков перед классификацией.
В целом, исследования электронных носов показывают, как профили летучих веществ могут быть использованы для распознавания пива, оценки степени старения, определения содержания алкоголя, обнаружения дефектов и классификации вкуса. Их основным ограничением является то, что для получения данных с датчиков требуется тщательное извлечение признаков, калибровка и валидация для различных продуктов. По этой причине некоторые более поздние системы обеспечения качества объединяют электронные носы с другими датчиками и контролируемыми измерительными платформами, как обсуждается ниже.
3.7.2. Спектроскопия и химический дактилоскопический анализ
Спектроскопические и химические измерения составляют еще одну важную группу исследований качества пива, связанных с искусственным интеллектом. Эти подходы полезны, поскольку позволяют быстро получать сложную химическую информацию и поддерживают классификацию, прогнозирование или аутентификацию при использовании в сочетании с подходящими вычислительными моделями. В этой группе компонентом, связанным с искусственным интеллектом, является не сам аналитический прибор, а хемометрическая модель или модель машинного обучения, используемая для интерпретации многомерных аналитических данных.
Инфракрасная и УФ-видимая спектроскопия использовались для оценки качественных характеристик и идентификации продукции. Иньон и др. объединили среднеинфракрасную и ближнеинфракрасную спектроскопию для определения качественных характеристик пива [228]. Коэльо де Оливейра и др. использовали данные УФ-видимой спектроскопии для быстрого мониторинга качественных характеристик пива [229]. Гордон и др. использовали спектроскопию ослабленного полного отражения в среднеинфракрасном диапазоне с многомерным анализом для идентификации пива [230]. Эти исследования показывают, как спектральные измерения могут уменьшить необходимость в более медленных традиционных анализах, когда целью является скрининг, классификация или быстрая оценка качества.
Масс-спектрометрия и хроматографические отпечатки также использовались для аутентификации и различения вкусов. Сикорска и др. различали вкусы пива, анализируя летучие вещества с помощью масс-спектрометра, используемого в качестве электронного носа [231]. Маттаруччи и др. аутентифицировали траппистское пиво, используя отпечатки LC-MS и многомерный анализ данных [232]. Кайка и др. распознавали марки пива по отпечаткам летучих веществ с помощью многомерного анализа [79]. Эти работы актуальны, поскольку они рассматривают идентичность пива как проблему химического паттерна: модель оценивает весь отпечаток, а не одно маркерное соединение.
Спектроскопия и машинное обучение также полезны, когда пиво уже упаковано. Харрис и др. использовали неинвазивную спектроскопию через бутылку с моделями машинного обучения для поддержки аутентификации пива, оценки качества и контроля [211]. Этот подход важен для обеспечения качества, поскольку он может позволить оценивать упакованные продукты, не открывая бутылку. Он также показывает, почему упаковка может стать частью аналитической задачи, поскольку модель должна отделять информацию, связанную с пивом, от сигналов, на которые влияет контейнер.
В целом, спектроскопия и химические отпечатки пальцев представляют собой дополнительный подход к электронным носам. Электронные носы, как правило, ближе к распознаванию ароматических паттернов, в то время как спектроскопические и хроматографические методы предоставляют более широкую химическую информацию. В обоих случаях практическая роль вычислительного моделирования схожа: сложные аналитические сигналы преобразуются в выходные данные, которые могут использоваться для аутентификации, обнаружения дефектов, сравнения продукции и рутинного контроля качества.
3.7.3. Компьютерное зрение для распознавания цвета, пены, пузырьков и визуальной идентичности.
Компьютерное зрение широко используется в контроле качества пива, поскольку многие характеристики продукта видны или могут быть измерены в контролируемых условиях визуализации. Цвет, высота пены, стабильность пены, размер пузырьков, внешний вид, связанный с мутностью, и визуальные различия между сортами пива могут быть количественно оценены по изображениям. Это не заменяет химический или органолептический анализ, но позволяет получать быстрые и воспроизводимые измерения, менее зависимые от ручного осмотра.
Ранние исследования анализа изображений были сосредоточены на основных визуальных признаках качества. Фэнся и др. использовали анализ изображений для определения цвета пива [233]. Хепворт и др. применили компьютерное зрение для определения распределения размеров пузырьков в пиве [234]. Сильва и др. использовали анализ изображений для идентификации светлого лагера [235]. Эти работы показывают, что методы, основанные на изображениях, могут поддерживать как оценку физического качества, так и различение продуктов.
Пена является важным объектом компьютерного зрения, поскольку она представляет собой важный качественный атрибут и тесно связана с восприятием потребителя. Чимини и др. разработали недорогую систему анализа изображений для улучшения прибора для измерения удержания пивной пены Рудина [236]. Габрова и др. использовали цифровую обработку изображений для определения изменений объема и стабильности пивной пены [237]. Нярко и др. оценили стабильность пены в лагерном пиве с помощью цифрового анализа изображений с RGB и 3D камер [238]. Эти исследования показывают, что поведение пены можно измерить более объективно, когда получение и обработка изображений стандартизированы.
Более поздние исследования используют компьютерное зрение на основе ИИ для классификации и задач, связанных с дефектами. Дутра и др. применили компьютерное зрение с ИИ для быстрого и недорогого прогнозирования стилей и марок пива [239]. Перес-Калабуиг и др. предложили компьютерное зрение на основе ИИ для обнаружения глютена в безглютеновом пиве [240]. Ревак и др. представили многоатрибутный набор данных коммерческих бутылок [241] для дальнейших исследований. Эти работы расширяют визуальную оценку качества от простого измерения до идентификации продукта, проверки заявлений и разработки моделей на основе наборов данных.
В целом, компьютерное зрение предоставляет практический способ контроля качества пива, когда соответствующий параметр можно наблюдать визуально или с помощью контролируемой съемки. Его главные преимущества — скорость, низкая стоимость и неразрушающий контроль. Однако его ограничения также очевидны: модели, основанные на изображениях, сильно зависят от освещения, настроек камеры, геометрии бокала или бутылки, условий розлива и способа представления образца.
3.7.4. Интегрированные недорогие платформы, роботизированная разливка и направление исследований RoboBEER
Отдельная группа исследований разработала интегрированные платформы для оценки качества пива. Эти системы объединяют контролируемое наливание, получение изображений, датчики, спектроскопию, электронные носы, биометрические данные потребителей и модели машинного обучения. Они отделены от общих исследований в области компьютерного зрения, поскольку их основной вклад заключается не только в анализе изображений, но и в создании воспроизводимых рабочих процессов измерения качества пива.
Система RoboBEER является наиболее ярким примером этого направления. Вьехо и др. представили роботизированный дозатор, созданный из доступных материалов, открытого оборудования и датчиков, для оценки качества пивной пены с использованием компьютерного зрения и распознавания образов [242]. Позже в той же работе были объединены оценка пенообразуемости, химический состав, ближнеинфракрасная спектроскопия и машинное обучение [243]. Затем Вьехо и др. использовали роботизированный дозатор, компьютерное зрение и алгоритмы машинного обучения для оценки качественных характеристик коммерческого пива [244]. Эти исследования показывают, как контролируемое наливание может уменьшить вариативность в тестах на пивную пену и сделать измерения качества на основе изображений более воспроизводимыми.
Впоследствии платформа была расширена за пределы одних только измерений пены. Вьехо и др. объединили робототехнику, компьютерное зрение и неинвазивную потребительскую биометрию для оценки характеристик пенообразуемости пива [245]. Вьехо и др. разработали модели искусственных нейронных сетей для оценки приемлемости пива по сенсорным свойствам с помощью роботизированного дозатора [246]. Вьехо и др. также предложили быстрый метод оценки пенообразуемости пива по относительному содержанию белка с использованием RoboBEER и моделирования машинного обучения [247]. Эти исследования связывают инструментальные измерения с сенсорной или композиционной информацией, что важно, поскольку качество пены зависит как от химического состава пива, так и от восприятия потребителя.
В рамках того же направления исследований были разработаны недорогие инструменты для обнаружения аромата и дефектов. Вьехо и др. разработали недорогой электронный нос для оценки ароматических профилей пива с помощью ИИ [248]. Вьехо и Фуэнтес обсудили оценку аромата и качественных характеристик пива с использованием искусственного интеллекта [249]. Вьехо и Фуэнтес также предложили недорогие методы оценки качества пива, включающие робототехнику, электронный нос и машинное обучение [250]. Позже Вьехо и др. объединили ближнеинфракрасную спектроскопию, недорогой электронный нос и ИИ для обнаружения дефектов в пиве [251]. Фуэнтес и др. разработали биосенсорное компьютерное приложение для оценки физиологических и эмоциональных реакций участников сенсорной панели [252]. В совокупности эти работы демонстрируют согласованную попытку создания недорогих многосенсорных систем обеспечения качества, которые связывают свойства пива с данными об инструментальных и человеческих реакциях.
В целом, исследования RoboBEER и связанных с ним недорогих платформ лучше всего рассматривать как интегрированные системы обеспечения качества, а не как изолированные приложения компьютерного зрения или электронных носов. Их главная ценность заключается в стандартизации: одна и та же процедура обработки образцов может предоставлять визуальные, химические, ароматические и сенсорные данные для моделей машинного обучения. Это полезно для пивоварен, которым необходима более быстрая обратная связь по качеству, но которые не могут проводить полный лабораторный или сенсорный анализ каждой партии.
3.7.5. Сенсорные качества, приемлемость, реакция потребителей и органолептическая оптимизация
Некоторые исследования по обеспечению качества выходят за рамки инструментального обнаружения и сосредотачиваются на сенсорном восприятии или реакции потребителей. Это отличается от измерения одного химического или визуального параметра. Модель должна связывать аналитические данные, сенсорные описания или оценки потребителей с результатами оценки качества, которые отчасти носят субъективный характер. Такие исследования важны, поскольку качество пива в конечном итоге оценивается не только по соответствию спецификациям, но и по вкусу, аромату, консистенции, приемлемости и предпочтениям.
Уилсон и Треплтон использовали искусственный интеллект для прогнозирования вкуса пива на основе химического анализа [253]. Эта работа является ранним примером связи измеренного состава с результатами сенсорного анализа. Табассум и др. использовали прогностическое моделирование на основе ИИ для оценки сенсорной панелью в процессе производства пива по индивидуальному заказу [254]. Такой подход полезен, когда пивоварням необходимо оценить результаты сенсорного анализа до того, как станет доступна полная сенсорная панель, или когда разрабатываются варианты продукта для конкретных целей.
Предпочтения потребителей были рассмотрены Пилоном и др., которые использовали ИИ для изучения предпочтений крафтового пива и оценки того, соответствуют ли итальянские производители ожиданиям потребителей [255]. Это смещает проблему обеспечения качества на рыночную сторону качества продукции. Пиво может соответствовать техническим характеристикам, но при этом не соответствовать сенсорным или стилистическим ожиданиям целевых потребителей. Браттин и др. использовали искусственную нейронную сеть для прогнозирования удовлетворенности клиентов пивоварни [256], расширяя моделирование, связанное с качеством, от атрибутов продукта к результатам на уровне клиента. Аль-Рифайе и Кавацца предложили эволюционную оптимизационную структуру для органолептических свойств пива [257]. В этом случае оптимизация используется не только для прогнозирования качества, но и для поиска лучших комбинаций сенсорных атрибутов.
В целом, сенсорные и потребительские исследования показывают, что обеспечение качества пива с помощью ИИ не ограничивается обнаружением дефектов. Вычислительные подходы также могут поддерживать разработку продукта, прогнозирование сенсорных характеристик, моделирование предпочтений и оптимизацию органолептических свойств. Эти задачи сложнее стандартизировать, чем химические или визуальные измерения, но они важны, поскольку связывают аналитическое качество с воспринимаемым качеством пива.
3.7.6. Аутентификация, стиль пива, классификация бренда и идентификация продукта.
Другая группа исследований рассматривает обеспечение качества пива как проблему идентификации продукта. Цель состоит в определении того, относится ли пиво к заявленному стилю, бренду, категории или группе продуктов. Эта задача пересекается с аутентификацией и обнаружением мошенничества, но также полезна для сравнительного анализа продукции, анализа рынка и автоматизированной документации коммерческого пива.
Дебска и Гузовска-Свидер обсуждали использование искусственных нейронных сетей в классификации продуктов питания [258]. Хотя эта работа шире, чем просто пиво, она актуальна, поскольку классификация пива следует той же общей логике: многомерные данные о продукте используются для отнесения образцов к предопределенным категориям. Бонатто предложил новую систему классификации категорий и стилей пива, основанную на крупномасштабном интеллектуальном анализе данных и самоорганизующихся картах рецептов пива [259]. Этот подход отличается от лабораторной аутентификации, поскольку он использует информацию в масштабе рецепта для организации стилей и категорий пива.
Гомес Памиес и др. классифицировали стили крафтового пива на основе рутинно измеряемых физико-химических параметров, включая содержание алкоголя, конечную плотность, горечь и цвет, используя глубокую нейронную сеть, обученную на образцах, сваренных в соответствии с национальными стандартами стиля [260]. Это более дешевый способ проверки стиля, чем спектроскопическая или летучая дактилоскопия, поскольку он повторно использует измерения, которые пивоварни уже проводят для контроля процесса.
Идентификация продукта также рассматривалась в исследованиях, основанных на электронных носах, химических отпечатках пальцев и компьютерном зрении, как обсуждалось в предыдущих подразделах. В этом подразделе ключевым моментом является то, что сама классификация может быть задачей обеспечения качества. Стиль пива и фирменная идентичность — это не просто маркетинговые обозначения; они определяют ожидаемые сенсорные, визуальные и композиционные свойства. Поэтому вычислительные модели могут поддерживать обеспечение качества, проверяя, соответствует ли продукт заявленной им идентичности.
3.7.7. Граничные случаи: генеративный ИИ, LLM и коммуникация, связанная с качеством пива.
Небольшое количество исследований лишь косвенно связано с обеспечением качества пива. Они не измеряют состав пива, не выявляют дефекты и не классифицируют образцы в обычном аналитическом смысле, но показывают, как новые модели и приложения ИИ могут повлиять на более широкий контекст качества пива. Чжоу и др. предложили прототип, исследующий возможность связи больших языковых моделей с обонятельной информацией [261]. Эта работа не является стандартным методом контроля качества на пивоварнях, но она актуальна как пограничный случай, поскольку оценка качества пива часто зависит от описания аромата, сенсорного словаря и интерпретации данных, связанных с запахом.
Истмент и Джо изучали эффективность генеративного ИИ в рекламных кампаниях крафтового пива для небольших пивоварен [262]. Это еще дальше от лабораторного контроля качества, но связано с тем, как характеристики пива, идентичность стиля и воспринимаемое качество передаются потребителям. Поэтому это следует рассматривать как часть более широкой цепочки создания стоимости пива с использованием ИИ, а не как аналитическое приложение для контроля качества.
В целом, обеспечение качества является наиболее разнообразной областью исследований, связанных с искусственным интеллектом, в рассмотренной литературе по пивоварению. В исследованиях используются данные химических отпечатков пальцев, электронных носов, спектроскопии, изображений, сенсорных оценок и отзывов потребителей, а также вычислительные подходы, включая хемометрические модели, машинное обучение, нейронные сети, компьютерное зрение и оптимизацию. Интегрированные платформы, такие как роботизированные системы розлива, обеспечивают дополнительный контекст измерения и развертывания. Эти подходы поддерживают такие задачи, как сенсорное прогнозирование, классификация стилей, аутентификация и обнаружение дефектов. Это разнообразие отражает саму природу качества пива: это не одна переменная, а комбинация состава, внешнего вида, аромата, вкуса, стабильности, упаковки, идентичности и восприятия потребителя. В то же время многие системы по-прежнему зависят от контролируемого отбора проб, ограниченных наборов данных или конкретных приборов. Их практическое внедрение на пивоварнях будет зависеть от того, можно ли их проверить на разных стилях пива, в разных масштабах производства, с разными типами упаковки и в реальных процедурах контроля качества.
4. Обсуждение
4.1. Крупное, но плохо интегрированное поле
Уже одно количество публикаций — 188 работ, 114 из которых опубликованы с 2017 года — может свидетельствовать о зрелости данной области исследований. Однако анализ сети цитирования в разделе 2 усложняет эту картину. Только 68% корпуса получают хотя бы одну внутрикорпусную цитируемую работу, 18% работ полностью изолированы, а большая часть наиболее цитируемой литературы сосредоточена в рамках одной исследовательской программы, а не распределена между независимыми группами. Вместо того чтобы демонстрировать явную конвергенцию по общим точкам отсчета и общему методологическому словарю, сеть указывает на множество параллельных, слабо связанных микролитературных источников. Таким образом, рост числа публикаций сам по себе не является свидетельством кумулятивной интеграции в данной области; аналогичные проблемы, включая оценку состояния, классификацию дефектов и прогнозирование аромата, часто изучаются в относительно разрозненных областях литературы.
4.2. Удобство данных
Концентрация приложений, связанных с ИИ, в процессах ферментации и контроля качества обычно объясняется технологической значимостью этих этапов. equally priusable, and complementary, explanation is that these stages produce the kind of data to be convenient to modeling.
Ферментация генерирует плотные, регулярно дискретизированные временные ряды, которые естественным образом отображаются на рекуррентные и последовательные модели, как это отражено в работе по прогнозированию плотности и содержания этанола, рассмотренной в разделе 3.5 [165, 197]. Задачи обеспечения качества часто сопровождаются естественной меткой — дефект или его отсутствие, подлинность или нет — которая подходит для контролируемой классификации. Затирание, фильтрация, кипячение, планирование и упаковка имеют важное экономическое значение, но редко дают сравнительно удобные, предварительно размеченные наборы данных, что, вероятно, способствует более разреженному объему литературы по этим этапам, представленной на рисунке 2.
4.3. Несоответствие масштаба
Цифровые двойники, киберфизические лаборатории и архитектуры Индустрии 4.0/5.0, как правило, предполагают инфраструктуру — сетевые датчики, базы данных истории, выделенный инженерный персонал — которая реалистична для крупных промышленных пивоварен, но не для малых и крафтовых пивоварен, на долю которых приходится большая часть недавнего роста сектора. В то же время, одна неудачная партия, упущенный привкус или неэффективный график ферментации, вероятно, оказывают наибольшее относительное экономическое воздействие именно в этом меньшем масштабе. Это создает несоответствие между условиями, в которых ИИ в пивоварении технически наиболее развит, и условиями, в которых он мог бы принести наибольшую относительную выгоду, противоречие, уже видимое в небольшом количестве исследований, направленных непосредственно на микропивоварни [83, 84].
Несоответствие заключается не только в стоимости инфраструктуры. Небольшие пивоварни обладают техническими характеристиками, которые затрудняют перенос многих опубликованных вычислительных методов в неизменном виде. Их оборудование часто нестандартное: резервуары, мельницы и насосы часто собираются из разных поставщиков и поколений, модернизируются, а не проектируются как единая согласованная система, что затрудняет интеграцию датчиков и перенос обучения между предприятиями по сравнению с однородной промышленной линией. Производство также отличается высокой гибкостью, а не повторяемостью — многие крафтовые пивоварни используют большое количество рецептов, каждый из которых варится нечасто и в небольших объемах, поэтому контролируемые модели редко видят достаточное количество повторяющихся примеров одного и того же пива, чтобы изучить стабильную закономерность, в отличие от больших однородных серий партий, доступных в промышленном масштабе [137]. Наконец, без специализированной команды по обработке данных или инженерии практическую ценность инструмента прогнозирования или мониторинга может быть трудно оправдать по сравнению с его стоимостью и сложностью. Это ограничение внедрения, которое нельзя преодолеть только точностью модели.
Единого пути внедрения систем, основанных на искусственном интеллекте, в пивоварении не существует, особенно потому, что осуществимый уровень оснащения сильно зависит от масштаба пивоварни и имеющихся ресурсов. Для небольших пивоварен практичной отправной точкой является использование измерений, которые уже регулярно проводятся. Цифровые датчики температуры, установленные в заторных чанах и ферментерах, могут служить легкодоступным источником данных о процессе для мониторинга и, при необходимости, управления на основе данных. Плотность сусла — еще одна регулярно измеряемая переменная, обычно регистрируемая после затирания и кипячения, а также во время брожения; даже измерения, записанные вручную, могут внести вклад в структурированный исторический набор данных. Встроенные рефрактометры могут предоставлять данные о брожении с более высокой частотой, хотя их стоимость может быть значительной для небольших пивоварен, а ценность полученного долгосрочного набора данных проявляется только со временем. Камеры, установленные в отдельных местах технологического процесса, таких как заторные чаны, фильтрационные чаны или ферментеры, могут стать еще одним относительно недорогим источником данных для мониторинга процесса и контроля качества. Крупные пивоваренные заводы могут дополнительно интегрировать датчики pH, ИК-спектроскопию, рамановскую спектроскопию и другие аналитические приборы. Такие системы могут обогатить наборы данных для оптимизации процесса, но их капитальные затраты и стоимость внедрения существенно возрастают, когда приборы необходимо дублировать на нескольких емкостях или технологических линиях.
4.4. Прогнозирование — это не управление.
Большинство исследований нейронных сетей в области ферментации сообщают о точной оценке плотности, этанола или фазы процесса, не предпринимая никаких действий на основе этой оценки. Исследования, которые сочетают прогнозирование с явной стратегией управления или оптимизации — прямое управление на основе спектроскопического мониторинга [165] или предиктивное управление с онлайн-оптимизацией заданного значения [197] — сравнительно редки. Это различие имеет большее значение для промышленного внедрения, чем фаза пивоварения, на которой применяется модель: точная предиктивная модель, которая никогда не влияет на принятие решения, имеет ограниченную практическую ценность, в то время как скромная модель, встроенная в петлю обратной связи, может существенно изменить результат. Формирование корпуса по этой оси «прогнозирование против управления», а не только по стадии процесса, предлагает более прямую оценку того, насколько близка эта область к практическому внедрению.
4.5. Отсутствующие контрольные показатели
В отличие от смежных областей, таких как точное земледелие [263] или виноделие [264], в пивоварении в значительной степени отсутствуют общие, многократно используемые наборы данных или эталоны. Наборы данных о сортах хмеля [98] и фотографиях бутылок [241] являются редким исключением; большинство исследований с использованием электронного носа, спектроскопии и компьютерного зрения, рассмотренных в разделе 3.7, основаны на данных, собранных для одного исследования и редко публикуемых. Без общих эталонов сложно сравнивать технический прогресс в этой области между исследованиями, и многие модели вряд ли пройдут проверку на уровне одной пивоварни, независимо от заявленной точности.
4.6. Интерпретируемость и устойчивость
В рассмотренной литературе интерпретируемость рассматривается как общее желательное условие, однако практические последствия ошибок модели существенно различаются в зависимости от области применения. В мониторинге или управлении процессами неверное предсказание может привести к неверным решениям в процессе или экономическим потерям, хотя параллельные измерения и контроль со стороны оператора могут обеспечить дополнительные гарантии. В аутентификации, классификации стилей и брендов неправильная классификация может, наоборот, повлечь за собой репутационные или регуляторные последствия — например, когда подлинный продукт ошибочно идентифицируется как не соответствующий заявленной идентичности. Поэтому требования к интерпретируемости в приложениях для пивоварения, связанных с ИИ, должны отражать последствия ошибок в конкретном приложении, а не рассматриваться как единое проектное ограничение для всей технологической цепочки.
Небольшое, но растущее подмножество корпуса — калькуляторы углеродного следа [89], фреймворки тензорных сетей для переработки отходов [91], инфраструктуры данных об устойчивом развитии с поддержкой ИИ [90] и многоагентные исследования энергетической гибкости для охлаждения брожения [122, 200, 201] — не очень хорошо вписывается в столбцы этапов процесса на Рисунке 2, поскольку оно рассматривает потоки энергии, воды и отходов, охватывающие весь пивоваренный завод, а не только одну технологическую операцию. Поэтому устойчивое развитие лучше понимать не как еще одну ячейку, которую можно добавить к существующей классификации, а как третью ось, наряду с фазой пивоварения и вычислительным подходом, вдоль которой можно было бы организовать будущую работу в этой области.
4.7. Уровень зрелости представленного исследования
Общая зрелость исследований, рассмотренных в данном исследовании, остается ограниченной. Одним из повторяющихся ограничений является относительно небольшой размер наборов данных, используемых для разработки и проверки моделей. Надежные модели, как правило, требуют многократных экспериментов и измерений, охватывающих достаточно широкий диапазон условий процесса. Однако количество необходимых наблюдений зависит от процесса, измеряемых переменных и подхода к моделированию, и общий пороговый уровень определить невозможно. В результате модели, разработанные на основе ограниченных экспериментальных наборов данных, могут демонстрировать хорошую производительность в условиях, представленных в обучающих данных, но могут плохо обобщаться за их пределы.
Второе ограничение заключается в неоднородности экспериментального оборудования, методов измерения и масштабов процесса. Данные, представленные в рассмотренных исследованиях, были собраны с использованием методов, варьирующихся от ручных измерений до автоматизированных систем мониторинга. Различия в датчиках, методах отбора проб и неопределенности измерений влияют на сопоставимость и точность получаемых наборов данных. Аналогичные проблемы возникают при переносе моделей, разработанных для одного масштаба процесса, на другой. Системы пивоварения лабораторного, пилотного и промышленного масштабов различаются по параметрам смешивания, однородности, гидравлике емкостей, распределению температуры, гидростатическому давлению и другим характеристикам процесса. Следовательно, нельзя предполагать, что модель, хорошо работающая в лабораторных условиях, сохранит ту же точность в промышленной установке.
Доступность промышленных данных представляет собой дополнительное ограничение. Крупные пивоваренные заводы редко публикуют подробные данные о технологических процессах, отчасти из-за политики компании и коммерческой конфиденциальности производственных данных. Поэтому исследователи часто полагаются на наборы данных, созданные специально для отдельных исследований. Это ограничивает как объем данных, доступных для разработки моделей, так и возможности проверки моделей на независимых промышленных предприятиях.
Эти ограничения указывают на то, что данная область все еще развивается в направлении более надежных и применимых на практике моделей. Более широкая доступность больших наборов данных, собранных в хорошо документированных и сопоставимых условиях, облегчила бы проверку моделей, сравнение исследований и перенос результатов лабораторных и пилотных экспериментов в промышленные процессы пивоварения.
4.8. Открытые проблемы
Пробелы, видимые на рисунке 2, указывают на то, где применение ИИ остается ограниченным, но сами по себе они не указывают, какие из этих пробелов наиболее актуальны для пивоваренной практики. Поэтому в этом подразделе выделен целенаправленный набор проблем, которые в значительной степени остаются нерешенными в рассмотренной литературе. Выбор основан на промышленном и академическом опыте авторов, с особым вниманием к малым и крафтовым пивоварням, и акцентирует внимание на проблемах, которые представляются решаемыми с помощью вычислительных подходов, уже представленных в других разделах исследования.
Некоторые из этих проблем касаются потока материалов и информации вокруг производства, а не самого производства. Прием сырья и контроль запасов получают мало внимания в рассмотренной литературе, связанной с ИИ, за исключением прогнозирования невыполненных заказов [124] и логистической работы над «умными кегами» [125]. Поэтому небольшие пивоварни, которые обычно работают с ограниченными буферными запасами и относительно небольшими объемами закупок, могут представлять собой полезную среду для прогнозирования спроса и потребления, адаптированного к этому масштабу производства. Риск загрязнения и состояние дрожжей также контролируются на протяжении всего процесса (раздел 1.1), однако вычислительные приложения к микробиологическим лабораторным данным, включая подсчет клеток, результаты окрашивания и кривые роста, в значительной степени отсутствуют в корпусе. Автоматизированная интерпретация таких данных потенциально может сократить интервал между отбором проб и получением пригодного результата в условиях ограниченных лабораторных мощностей. Механическое оборудование представляет собой еще один малоизученный источник данных: мельницы, насосы и двигатели генерируют звуковые и вибрационные сигналы по мере изменения условий их работы, однако эти методы практически не представлены в рассмотренной литературе по сравнению с визуализацией и спектроскопией. Для этой цели можно исследовать аналогичные подходы к обнаружению и классификации аномалий, которые уже применялись к другим типам сигналов в разделе 3.7. Мониторинг окружающей среды внутри пивоварни также представлен лишь в незначительной степени; такие приложения, как обнаружение видимых загрязнений, роста плесени или износа уплотнений, потенциально могут использовать подходы компьютерного зрения, уже применяемые для контроля качества продукции.
Вторая группа проблем ближе к самому процессу и к разграничению прогнозирования и контроля, обсуждавшемуся выше. Несколько исследований уже оценивают текущую фазу брожения [164], но ни одно исследование, выявленное в рассмотренном корпусе, не связывает такую оценку напрямую с исполнительным механизмом, ответственным за переливание пива между стадиями брожения, что является наглядным примером разрыва между прогнозированием и автоматизированным управлением. Настройка работы центрифуги для осветления с целью достижения заданного, преднамеренно ненулевого уровня мутности является более узкой задачей, чем большинство задач, рассмотренных в разделе 3.7, но потенциально может быть решена с использованием методов регрессии и управления, аналогичных тем, которые уже применялись к другим непрерывным показателям качества. Проверка того, были ли возвратные бутылки должным образом очищены перед повторным наполнением, является задачей визуального контроля, тесно связанной с работой по проверке пустых бутылок, рассмотренной в разделе 3.6 , но в корпусе не было выявлено соответствующего применения. В процессе брожения также образуется CO2, который потенциально может быть утилизирован и повторно использован в других местах пивоварни; Оптимизация процесса извлечения представляет собой проблему управления процессом и эффективности использования ресурсов, связанную с рассмотренными выше исследованиями в области устойчивого развития, однако ни одно приложение, связанное с ИИ и решающее эту проблему, не было выявлено. Две другие проблемы касаются разработки продукта, а не отдельной технологической операции. Партионное смешивание можно сформулировать как задачу оптимизации, используя композиционные и сенсорные профили доступных сортов пива, в то время как селективное извлечение ароматических соединений в процессе деалкоголизации можно исследовать с помощью прогностических и оптимизационных моделей. Ни одно из этих приложений не было выявлено в рассмотренном корпусе приложений для пивоварения, использующих ИИ.
В литературе по пивоварению, не связанной с ИИ, можно выделить дополнительный набор потенциальных направлений исследований. Следующие исследования не были разработаны как приложения ИИ, но в них представлены многомерные, нелинейные или многопараметрические данные, которые могут послужить основой для прогнозных или оптимизационных исследований. Постиго и др. разработали и оценили четыре рецепта крафтового пива, основанных на региональных источниках солода, хмеля и дрожжей, объединив характеристику сырья, мониторинг ферментации и физико-химические, сенсорные и потребительские данные в едином конвейере [265]; такие объединенные входные и выходные данные могут поддерживать будущие модели рекомендаций рецептов или рецептур. Климчак и др. оценили коммерческие штаммы дрожжей для производства пива с пониженным содержанием алкоголя, используя измерения ферментации вместе с физико-химическими и сенсорными характеристиками полученного пива [266]; такие многопараметрические данные могут поддерживать прогностические модели, связывающие выбор дрожжей и поведение ферментации с содержанием алкоголя и качеством конечного продукта. Маккейб и др. Проанализировали 51 летучее соединение в трех сортах пива, подвергнутых сухому охмелению, и отметили, что прогнозирование аромата пива на основе сорта хмеля или метода охмеления «остается сложной задачей» [267], предполагая возможную проблему регрессии, связывающую химический состав хмеля с сенсорными результатами. Модзелевска и др. оптимизировали извлечение ксантогумола из отработанного хмеля с помощью физической, химической и ферментативной предварительной обработки, нескольких параметров процесса и нескольких систем растворителей [268]; эту многофакторную задачу оптимизации выхода потенциально можно решить с помощью методов поверхности отклика или метаэвристических подходов, аналогичных тем, которые уже применялись к другим задачам извлечения побочных продуктов пивоварения [148, 150]. Гвидо и Феррейра рассмотрели взаимосвязь между антиоксидантной активностью солода и изменением вкуса пива [269], предложив возможное направление для моделей, связывающих характеристики поступающего солода с последующей стабильностью.
Точчи и др. связали тип солода и штамм дрожжей с 34 летучими соединениями в пиве на основе ржи с помощью описательной статистики [270]; этот многомерный дизайн также может поддерживать контролируемое моделирование ароматических профилей на основе параметров рецепта. Томпсон-Витрик и др. охарактеризовали летучий профиль пива на основе проса относительно сорго и ячменя [271]; в рассмотренном корпусе не было обнаружено соответствующего ориентированного на ИИ набора данных для этого сырья, что делает перенос из моделей, разработанных для более изученных злаков, возможным направлением исследований. Сатора и Патер охарактеризовали ароматические соединения, продуцируемые нетрадиционными дрожжами [272]; такие данные могут поддерживать модели, связывающие выбор дрожжей с результатами ароматизации, расширяя направление поддержки рецептов, уже присутствующее в корпусе [95, 96]. Шутя и др. составили руководство по устранению неполадок, связывающее конкретные соединения, вызывающие посторонний привкус, с их происхождением в процессе производства и корректирующими действиями [273]; формализация этих взаимосвязей в виде базы правил могла бы обеспечить основу для интерпретируемой системы диагностики дефектов. Меса-Маркес и др. создали модель FT-MIR, предсказывающую семь параметров качества крафтового пива с очень высокой точностью на одном калибровочном наборе [274]; проверка ее обобщаемости на пивоварни, сырье и условия измерения напрямую решит проблемы сравнительной оценки и переносимости, обсуждавшиеся выше.
Некоторые из упомянутых выше промышленных направлений также являются предметом текущей работы группы авторов, но поскольку эти исследования еще не опубликованы, они не были включены в корпус и не использовались в качестве доказательств в представленном здесь анализе.
5. Ограничения
Данный обзор имеет ряд ограничений, которые следует учитывать при интерпретации полученного корпуса и выявленных на его основе закономерностей. Во-первых, поиск литературы подвержен влиянию предвзятости баз данных и терминологии. Хотя поиск проводился в семи библиографических базах данных с использованием комбинаций терминов, связанных с пивоварением и искусственным интеллектом, ни одна стратегия поиска не может охватить всю терминологию, используемую в такой разнородной области, как пивоварение, пищевая наука, технологическое проектирование, хемометрика, информатика и исследование операций. Соответствующие исследования могут описывать по существу схожие методы, используя различную дисциплинарную лексику, и поэтому могли не быть найдены с помощью выбранных комбинаций ключевых слов. С другой стороны, включение Google Scholar и баз данных конкретных издателей увеличило охват, но также снизило единообразие поисковой среды во всех источниках. Поэтому полученный набор из 188 публикаций следует интерпретировать как широкое отображение доступной литературы, а не как исчерпывающий библиографический обзор.
Отбор, извлечение метаданных и классификация проводились вручную. Это позволило оценить технологическую значимость и различить приложения, которые было бы сложно разделить, используя только библиографические метаданные, но также внесло определенную долю субъективной оценки рецензента. Границы искусственного интеллекта сами по себе не фиксированы. В данном обзоре ИИ намеренно использовался как широкий оперативный зонтик, охватывающий машинное обучение и нейронные методы, а также подходы к оптимизации и компьютерному зрению, в то время как цифровые двойники, системы, ориентированные на Индустрию 4.0, и связанные с ними технологии были сохранены как контексты, обеспечивающие или внедряющие их, где они составляли существенную часть литературы по пивоварению. Таким образом, эти категории не являются методологически эквивалентными, и их включение отражает то, как эти концепции встречаются в литературе по пивоварению, а не утверждение, что они представляют собой один и тот же тип вычислительного метода. Следовательно, размер и кажущаяся важность отдельных категорий изменились бы при более узком определении ИИ.
Аналогичные соображения применимы и к отнесению публикаций к стадиям разработки и вычислительным подходам. Многие исследования затрагивают более одной технологической проблемы или сочетают несколько вычислительных методов, и 27 публикаций были явно отнесены к границам категорий. Их размещение основывалось на доминирующей задаче и подходе, интерпретированном рецензентами, но в некоторых случаях были бы разумны альтернативные классификации. Поэтому двухмерную карту следует рассматривать как аналитическую основу для описания структуры литературы, а не как однозначно определенную таксономию. Добавление публикаций на основе цитирования вносит дополнительный источник потенциальной предвзятости. В корпус были добавлены релевантные публикации, обнаруженные при изучении ссылок, что улучшило охват работ, пропущенных исходной терминологией, но эта процедура не являлась единым систематическим протоколом «снежного кома». Она может преимущественно выявлять публикации, связанные с уже идентифицированными исследовательскими группами или темами, и тем самым усиливать тесно связанные части литературы.
Анализ по странам также носит описательный характер, а не является показателем национальной исследовательской продуктивности. Каждая публикация была отнесена к одной стране в соответствии с местом работы первого автора. Эта практика не учитывает многонациональное сотрудничество, вклад соавторов из других стран, изменения в месте работы авторов или различия в размерах национальных исследовательских сообществ. Сравнения с производством и потреблением пива обеспечивают отраслевой контекст, но их не следует интерпретировать как доказательство того, что объем производства или потребления напрямую определяет исследовательскую активность. Базовая статистика по пивоварению также получена из различных источников данных и методологий, и охват публикаций по-прежнему зависит от поисковых и языковых особенностей самого корпуса.
Наконец, анализ сети цитирования отражает только связи внутри корпуса из 188 публикаций. Ребро указывает на то, что одна включенная работа цитирует другую включенную работу; цитирования публикаций за пределами корпуса не представлены. Таким образом, полученная сеть описывает внутреннюю связность рассмотренной литературы, а не полное научное влияние отдельных исследований или исследовательских групп. Ее структура также чувствительна к составу корпуса, включая описанные выше дополнения, основанные на цитировании. Более поздние публикации имели меньше времени для цитирования, в то время как повторяющиеся публикации одной и той же исследовательской группы могут создавать плотные локальные кластеры, не обязательно указывая на более широкое влияние в данной области. Поэтому такие показатели, как доля изолированных публикаций, межстрановые связи цитирования или сильно связанные кластеры, следует интерпретировать как свойства данного обзорного корпуса, а не как полные библиометрические показатели исследований, связанных с ИИ в пивоварении.
Несмотря на эти ограничения, комбинированный поиск, ручной отбор, процесс-ориентированная классификация и картирование цитирований обеспечивают структурированный обзор литературы, которая распределена по нескольким дисциплинам и использует непоследовательную терминологию. Поэтому основные выводы обзора касаются общих закономерностей — концентрации работ на конкретных этапах пивоварения, распространенности определенных вычислительных подходов и ограниченной интеграции между частями данной области — а не точных оценок общего размера, национального распространения или влияния цитирования в данной области исследований.
6. Выводы
В данном обзоре проанализировано 188 публикаций по искусственному интеллекту в пивоварении, охватывающих различные этапы процесса и вычислительные подходы. Приложения сосредоточены в области ферментации и контроля качества, при этом нейронные сети особенно распространены в исследованиях ферментации, а компьютерное зрение — в исследованиях контроля качества, в то время как сеть цитирования остается лишь слабо интегрированной. Из этого следует три вывода. Во-первых, эта концентрация, по-видимому, отражает как технологическую важность, так и доступность данных, оставляя затирание, фильтрацию, кипячение, охлаждение, планирование и упаковку сравнительно менее изученными. Ферментация генерирует плотные временные ряды данных и имеет прямое влияние на продолжительность процесса, качество продукта и производственную мощность, в то время как контроль качества предоставляет четко определенные задачи классификации и прогнозирования на основе аналитических, сенсорных и графических данных. В отличие от этого, другие этапы пивоварения часто предоставляют меньше легкодоступных или стандартизированных наборов данных, что может частично объяснить их меньшую представленность в литературе. Во-вторых, рост числа публикаций в этой области не сопровождается ростом числа общих наборов данных, эталонных показателей или интеграции цитирований, и устранение этого разрыва, вероятно, будет иметь большее значение для промышленного внедрения, чем дальнейшее повышение точности на основе данных отдельных исследований. В-третьих, интерпретируемость и управляемость — возможность понимания результатов модели и их использование для принятия оперативных решений — являются важными показателями практической готовности, выходящими за рамки только этапа пивоварения или вычислительного подхода. Более широкое промышленное внедрение, особенно среди малых и крафтовых пивоварен, чье нестандартное оборудование, гибкие рецепты и ограниченная инфраструктура данных недостаточно представлены в рассмотренной литературе, будет зависеть от прогресса в этих областях и от распространения вычислительных подходов на управление запасами, техническое обслуживание, мониторинг окружающей среды, рекуперацию ресурсов и другие недостаточно изученные в настоящее время проблемы пивоварения.
Список сокращений
В данной статье используются следующие сокращения:
| Сокращение | Расшифровка на русском языке |
|---|---|
| AI | Искусственный интеллект (Artificial intelligence) |
| ANN | Искусственная нейронная сеть (Artificial neural network) |
| FT-NIR | Ближняя инфракрасная спектроскопия с преобразованием Фурье (Fourier-transform near-infrared spectroscopy) |
| IPMA | Анализ карты важности и эффективности (Importance–performance map analysis) |
| IoT | Интернет вещей (Internet of Things) |
| IPA | Индийский бледный эль (India pale ale) |
| LC-MS | Жидкостная хромато-масс-спектрометрия (Liquid chromatography–mass spectrometry) |
| LLM | Большая языковая модель (Large language model) |
| LSTM | Долгая краткосрочная память (Long short-term memory) |
| MOX | Металлооксидный (полупроводниковый датчик) (Metal oxide) |
| NIR | Ближняя инфракрасная спектроскопия (Near-infrared spectroscopy) |
| PLS-SEM | Моделирование структурными уравнениями методом частичных наименьших квадратов (Partial least squares structural equation modeling) |
| RGB | Цветовая модель RGB / Красный-зеленый-синий (Red–green–blue color model) |
| UFOP-HVD | Набор данных сортов хмеля Федерального университета Ору-Прету (UFOP hop varieties dataset) |
| UK | Великобритания (United Kingdom) |
| UV-Vis | Спектроскопия в ультрафиолетовой и видимой областях (Ultraviolet–visible spectroscopy) |
| vis/NIR | Спектроскопия в видимой и ближней инфракрасной областях (Visible and near-infrared spectroscopy) |
Приложение А
Таблица А1. Классификация библиографического корпуса по стадии разработки и методу искусственного интеллекта.
| Цитата | Задача | Метод | |
|---|---|---|---|
| [ 127 ] | Аканинвор и др. (2021) | оптимизация прибыли пивоваренного производства | прямое направление искусственной нейронной сети |
| [ 150 ] | Акинпелу и др. (2020) | Оптимизация очистки кислых шахтных стоков с использованием сточных вод пивоваренных заводов. | Методология поверхности отклика + искусственные нейронные сети |
| [ 157 ] | Аль-Рифаи и Кавацца (2022) | многоцелевая оптимизация пива | многоцелевая эволюционная оптимизация |
| [ 257 ] | Аль-Рифаи и Кавацца (2022) | оптимизация органолептических свойств пива | эволюционная оптимизация |
| [ 190 ] | де Андрес-Торо и др. (1997) | оптимизация процесса периодического брожения | генетические алгоритмы |
| [ 175 ] | Ассиджо и др. (2006) | моделирование промышленного пивоваренного завода | искусственные нейронные сети |
| [ 145 ] | Бай и др. (2011) | анализ энергопотребления на всех этапах процесса пивоварения | нейронные сети |
| [ 117 ] | Балдо и др. (2014) | определение размеров партий и составление графика производства на пивоварне | оптимизационный подход |
| [ 118 ] | Балдо и др. (2017) | определение размеров партий и составление графика производства на пивоварне | математические модели и методы оптимизации |
| [ 174 ] | Беккер и др. (2002) | онлайн-оптимизация промышленной ферментации | динамические нейронные сети |
| [ 259 ] | Бонатто (2026) | классификация категорий и стилей пива | крупномасштабный анализ данных + самоорганизующиеся карты |
| [ 110 ] | Бонецки и др. (2014) | Обнаружение зерен пшеницы, поврежденных амбарным долгоносиком. | Рентгеновская визуализация |
| [ 112 ] | Бонецки и др. (2020) | обнаружение амбарного долгоносика в образцах зерна | нейронное визуальное обнаружение |
| [ 180 ] | Боулер и др. (2021) | ультразвуковой мониторинг процесса брожения пива в различных условиях | Адаптация предметной области + федеративное обучение |
| [ 179 ] | Боулер и др. (2021) | прогнозирование концентрации алкоголя во время брожения пива | ультразвуковые измерения + машинное обучение |
| [ 89 ] | Боулер и др. (2024) | Расчет углеродного следа цепочки создания стоимости в крафтовом пивоварении Великобритании | Машинное обучение на основе Интернета вещей |
| [ 256 ] | Браттин и др. (2018) | прогнозирование удовлетворенности клиентов пивоварни | искусственная нейронная сеть |
| [ 96 ] | Бравин и др. (2021) | создание шаблонов рецептов пива | генеративная модель на основе трансформатора |
| [ 88 ] | Бриаторе и др. (2024) | обеспечение устойчивости производственной линии по выпуску пива | Интернет вещей + периферийные вычисления + туманные вычисления + облачные вычисления |
| [ 164 ] | Буонокоре и др. (2024) | онлайн-идентификация фаз брожения пива | предложенное машинное обучение |
| [ 79 ] | Кайка и др. (2010) | распознавание марок пива по изменчивым отпечаткам пальцев | многомерный анализ |
| [ 207 ] | Кампос и др. (2010) | осмотр ящиков с бутылками | компьютерное зрение |
| [ 113 ] | Карвальял Пинто и др. (2023) | повышение эффективности сушки хмеля | машинное обучение |
| [ 99 ] | Кастро и др. (2021) | улучшение классификации сортов хмеля | традиционное извлечение признаков + глубокое обучение |
| [ 98 ] | Кастро и др. (2021) | классификация сортов хмеля | |
| [ 100 ] | Кастро и др. (2023) | улучшение классификации сортов хмеля | традиционное извлечение признаков + глубокое обучение |
| [ 236 ] | Чимини и др. (2016) | измерение стойкости пивной пены | недорогой анализ изображений |
| [ 216 ] | Циосек и Вроблевски (2006) | признание пива | Массив проточных датчиков с миниатюрными твердотельными электродами |
| [ 146 ] | Кондуа и др. (2025) | прогнозирование потребления энергии в мини-пивоварнях | Модели на основе искусственных нейронных сетей |
| [ 172 ] | Корриё и др. (2000) | Онлайн-оценка и прогнозирование изменения плотности и содержания этанола. | нейронные сети |
| [ 148 ] | Коста Жуниор и др. (2020) | моделирование экстракции фенольных соединений из жома пивного солода | искусственная нейронная сеть |
| [ 212 ] | да Коста и др. (2020) | обзор методов аутентификации пива | Обзор хемометрики и алгоритмов машинного обучения |
| [ 166 ] | Д’Аморе и др. (1993) | моделирование пивоварения и брожения | нейронные сети |
| [ 149 ] | Девасме (2019) | Оценка ключевых компонентов в анаэробном реакторе для очистки сточных вод пивоваренного завода. | программные датчики на основе нейронных сетей |
| [ 161 ] | Даззарола и др. (2026) | Контроль качества пива с использованием дескрипторов брожения. | цифровая модель, объединяющая данные промышленного процесса и дескрипторы ферментации на основе модели. |
| [ 258 ] | Дембска и Гузовска-Свидер (2011) | классификация продуктов питания | искусственные нейронные сети |
| [ 195 ] | Дефернес и др. (2007) | моделирование изменчивости между процессами промышленного пивоварения | многомерное статистическое моделирование |
| [ 86 ] | Деузе и др. (2024) | разработка учебной инфраструктуры для киберфизических пивоваренных лабораторий | машинное обучение + Интернет вещей |
| [ 84 ] | Диас и др. (2023) | анализ цифровой трансформации в производстве микропивоварен | цифровая трансформация |
| [ 199 ] | Дитлер и др. (2020) | сегментация изображений дрожжевой микроскопии | сверточная нейронная сеть |
| [ 202 ] | Дуань и др. (2004) | проверка пустой бутылки | машинное зрение |
| [ 203 ] | Дуань и др. (2007) | проверка пивных бутылок | машинное зрение |
| [ 262 ] | Истмент и Джо (2024) | оценка рекламных кампаний крафтового пива | генеративный ИИ |
| [ 154 ] | Эдгар и др. (2025) | Оптимизация работы пластинчатого теплообменника для охлаждения пивоваренного завода. | гибридная термодинамическая модель и модель машинного обучения |
| [ 108 ] | Эмбейале и др. (2025) | сортировка солодового ячменя для пивоваренных заводов | сверточная нейронная сеть, обученная на текстурных признаках |
| [ 97 ] | Эрми и др. (2018) | Прогнозирование химических свойств пива на основе рецептов пивоварения | глубокие нейронные сети |
| [ 143 ] | Эстраканхолли и др. (2024) | количественное определение углеводов в пивном сусле в режиме реального времени | ИК-спектроскопия + анализ с помощью нейронных сетей |
| [ 115 ] | Фейзи и др. (2016) | анализ жизнеспособности и концентрации дрожжевых клеток | Безлинзовая микроскопия на чипе + машинное обучение |
| [ 233 ] | Фэнся и др. (2004) | определение цвета пива | анализ изображений |
| [ 109 ] | Форнал и др. (2007) | Обнаружение яиц и внутренних стадий развития амбарного долгоносика в зерне пшеницы. | Мягкое рентгеновское излучение + анализ изображений |
| [ 188 ] | Франса и др. (2021) | мониторинг многоступенчатого производства крафтового пива | ближнеинфракрасная спектроскопия + хемометрика |
| [ 252 ] | Фуэнтес и др. (2018) | оценка физиологических и эмоциональных реакций участников сенсорной панели | биосенсорное компьютерное приложение |
| [ 237 ] | Габрова и др. (2021) | измерение объема и стабильности пивной пены | цифровая обработка изображений |
| [ 181 ] | Гарсия и др. (1994) | моделирование образования сложных эфиров в процессе промышленного пивоварения | нейронные сети |
| [ 168 ] | Гарсия и др. (1995) | Контроль и прогнозирование параметров качества в процессе брожения пива. | нейронные сети |
| [ 215 ] | Гарднер и др. (1994) | мониторинг вкуса пива | Многосенсорная система на основе проводящих полимеров + прогностические классификаторы |
| [ 120 ] | Георгиадис и др. (2021) | оптимальное планирование и составление графика производства на пивоварне | Оптимизация MILP |
| [ 218 ] | Гасеми-Варнамхасти и др. (2011) | Характеристика признаков старения пива | данные электронного носа |
| [ 77 ] | Гасеми-Варнамхасти и др. (2011) | Применение электронных носов на пивоварнях | электронный нос |
| [ 219 ] | Гасеми-Варнамхасти и др. (2015) | бинарная дискриминация пива на основе данных электронного носа | электронный нос + классификация на основе машинного обучения |
| [ 187 ] | Джовенцана и др. (2014) | экспресс-оценка качества крафтового пива в процессе брожения | видимая/ближняя инфракрасная спектроскопия |
| [ 163 ] | Гоффи и др. (2025) | мониторинг и контроль отбора проб в процессе брожения пива | цифровой двойник |
| [ 260 ] | Гомес Памиес и др. (2024) | Классификация стилей крафтового пива по физико-химическим параметрам. | глубокие нейронные сети |
| [ 242 ] | Гонсалес Вьехо и др. (2016) | оценка качества пивной пены | роботизированный дозатор + компьютерное зрение + распознавание образов |
| [ 243 ] | Гонсалес Вьехо и др. (2017) | оценка пенообразуемости и состава пива | ближнеинфракрасная спектроскопия + машинное обучение |
| [ 186 ] | Гонсалес Вьехо и др. (2018) | моделирование влияния обработки звуковыми волнами на пенообразование и сенсорные свойства | машинное обучение |
| [ 245 ] | Гонсалес Вьехо и др. (2018) | оценка характеристик пенообразования пива | Робототехника + компьютерное зрение + неинвазивная потребительская биометрия |
| [ 244 ] | Гонсалес Вьехо и др. (2018) | оценка качественных характеристик коммерческого пива | роботизированный дозатор + компьютерное зрение + машинное обучение |
| [ 214 ] | Гонсалес Вьехо и др. (2019) | Обзор технологий искусственного интеллекта для оценки качества напитков и потребительских предпочтений. | обзор |
| [ 246 ] | Гонсалес Вьехо и др. (2019) | прогнозирование приемлемости пива на основе его сенсорных свойств | искусственные нейронные сети + роботизированный дозатор |
| [ 247 ] | Гонсалес Вьехо и др. (2020) | оценка пенообразуемости пива на основе относительного содержания белка | RoboBEER + моделирование на основе машинного обучения |
| [ 249 ] | Гонсалес Вьехо и Фуэнтес (2020) | оценка аромата и качественных характеристик пива | робототехника + электронный нос |
| [ 250 ] | Гонсалес Вьехо и Фуэнтес (2020) | недорогая оценка качества пива | робототехника + электронный нос + машинное обучение |
| [ 248 ] | Гонсалес Вьехо и др. (2020) | оценка ароматических профилей пива | недорогой электронный нос + ИИ |
| [ 251 ] | Гонсалес Вьехо и др. (2021) | обнаружение дефектов пива | ближнеинфракрасная спектроскопия + недорогой электронный нос + ИИ |
| [ 230 ] | Гордон и др. (2018) | идентификация сортов пива по спектральным данным | ATR-спектроскопия в среднем инфракрасном диапазоне + многомерный анализ |
| [ 78 ] | Грасси и др. (2014) | мониторинг параметров брожения пива | ИК-спектроскопия с преобразованием Фурье + многомерный анализ данных |
| [ 103 ] | Гевара-Эрнандес и Гомес-Хиль (2011) | классификация зерен пшеницы и ячменя | машинное зрение |
| [ 170 ] | Гваздайтис и др. (1994) | Контроль температуры в бродильных емкостях пивоварни | нейронные сети + управление с обратной связью |
| [ 211 ] | Харрис и др. (2025) | Аутентификация пива, оценка качества и контроль качества на уровне бутылки. | неинвазивная спектроскопия + машинное обучение |
| [ 131 ] | Хассен и Асмаре (2019) | моделирование эффективности очистки сточных вод пивоваренного завода | искусственные нейронные сети |
| [ 234 ] | Хепворт и др. (2004) | определение распределения размеров пузырьков в пиве | компьютерное зрение |
| [ 81 ] | Хлангвани и др. (2021) | Моделирование биопроцесса для оптимального производства умкомботи | Методология поверхностей отклика + нейронные сети |
| [ 210 ] | Хольфельд и др. (2022) | классификация пивных бутылок | обнаружение объектов + перенос обучения |
| [ 152 ] | Хоу и др. (2003) | Онлайн-измерение загрязнения в испарителе сусла пивоварни. | мягкое сенсорное |
| [ 153 ] | Хоу и Чжоу (2005) | измерение периодического загрязнения при чередовании рецептур | гибридная нечеткая нейронная сеть |
| [ 200 ] | Говард и др. (2021) | Оптимизация энергоэффективности в системах охлаждения при ферментации | многоагентное моделирование |
| [ 201 ] | Говард и др. (2022) | анализ потенциала энергоэффективности пивоваренных заводов | моделирование на основе многоагентных систем |
| [ 82 ] | Ху и др. (2026) | Изучение пивного туризма, вдохновения потребителей и потребительского поведения, связанного с напитками. | искусственные нейронные сети + PLS-SEM + IPMA |
| [ 204 ] | Хуанг и др. (2018) | проверка пустой бутылки | машинное зрение |
| [ 228 ] | Иньон и др. (2006) | определение качественных свойств пива | среднеинфракрасная + ближнеинфракрасная спектроскопия |
| [ 134 ] | Кулурис и др. (2021) | Анализ моделирования и планирования производства с использованием технологических моделей и цифровых двойников. | обзор |
| [ 106 ] | Козловский и др. (2019) | Сортовая классификация зерен ячменя | сверточные нейронные сети |
| [ 107 ] | Козловский и др. (2024) | Выявление дефектов и идентификация сортов зерен ячменя для солодовенного производства. | компьютерное зрение |
| [ 193 ] | Курц и др. (2001) | Наблюдение и контроль процесса брожения пива. | когнитивные методы |
| [ 93 ] | Ламанья и др. (2004) | классификация хмеля | электронный нос |
| [ 85 ] | Ли и др. (2024) | Разработка гетерогенных цифровых двойников на основе моделей для мини-пивоварни | инструменты разработки цифровых двойников с открытым исходным кодом |
| [ 124 ] | Ли (2019) | прогнозирование задержек с выполнением заказов в пивоварнях крафтового пива | машинное обучение |
| [ 91 ] | Ли и Пэн (2026) | Оптимизация переработки отходов пивоварения для достижения углеродной нейтральности | многомасштабная структура принятия решений на основе тензорных сетей |
| [ 208 ] | Лян и др. (2021) | автоматическая проверка дефектов пивных бутылок | глубокое остаточное обучение |
| [ 224 ] | Либоа и др. (2023) | Обнаружение в реальном времени уровня восприятия диацетила в пиве | Массив датчиков MOX |
| [ 122 ] | Липка и др. (2026) | Интеграция гибкости планирования пакетного производства в проектирование и диспетчеризацию энергетических систем пивоваренных заводов. | смешанное целочисленное линейное программирование |
| [ 213 ] | Лукинац и др. (2019) | обзор компьютерного зрения для оценки качества пива | обзор |
| [ 197 ] | Лавринчук (2011) | Оптимизация заданных параметров в режиме онлайн и прогнозирующее управление дрожжевым брожением | нейронная сеть прогнозирующего управления |
| [ 198 ] | Маляр и др. (2025) | определение основных стадий брожения пива | алгоритм компьютерного зрения |
| [ 90 ] | Маркович и др. (2024) | поддержка устойчивого развития с помощью инфраструктуры данных пивоварни | обзор |
| [ 232 ] | Маттаруччи и др. (2010) | подлинность траппистского пива | LC-MS-отпечатки + многомерный анализ данных |
| [ 227 ] | Мен и др. (2017) | классификация вкусов пива | слияние данных электронного языка/электронного носа |
| [ 225 ] | Мен и др. (2018) | Классификация пива по данным электронного носа | стратегия извлечения признаков |
| [ 132 ] | Микейн и др. (2021) | планирование производства на пивоварне | система поддержки принятия решений |
| [ 133 ] | Микейн и др. (2022) | стратегическое планирование производства пивоваренной продукции | Многоуровневый метод определения оптимального размера партии с учетом вместимости + эвристика «фиксировать, ослаблять ограничения и оптимизировать» |
| [ 184 ] | Милева и Васильева (2008) | прогнозирование антиоксидантных характеристик в процессе пивоваренного брожения | искусственные нейронные сети |
| [ 162 ] | Муктадир и др. (2025) | Управление согласованностью моделей в цифровом двойнике пивоварни | цифровой двойник пивоварни |
| [ 206 ] | Мусич и др. (2023) | контроль уровня жидкости во время розлива в бутылки | датчик на основе изображения |
| [ 116 ] | Надыбский и Ревак (2022) | повышение эффективности производственного процесса | интеллектуальные методы оптимизации |
| [ 125 ] | Неттесхайм и др. (2024) | Оценка интеллектуальных кегов для логистики пивоварни | моделирование |
| [ 10 ] | Неттесхайм и др. (2024) | обзор применения машинного обучения в пивоварении | систематический обзор |
| [ 83 ] | Неттесхайм и др. (2026) | Пивоварение на основе данных для устойчивого развития в мини-пивоварнях | Архитектура сенсорной системы + машинное обучение |
| [ 140 ] | Нимбалкар и др. (2020) | повышение эффективности и производительности пивоваренного завода | интеллектуальные производственные технологии |
| [ 226 ] | Нимсук (2019) | улучшение классификации пива на основе сигналов электронного носа | Извлечение переходных характеристик из сигналов электронного носа |
| [ 238 ] | Ньярко и др. (2021) | оценка стабильности пены в лагерном пиве | цифровой анализ изображений с использованием RGB и 3D камер |
| [ 176 ] | О’Брайен и др. (2024) | моделирование и прогнозирование динамики брожения пива в смешанных культурах | авторегрессивные рекуррентные нейронные сети |
| [ 177 ] | О’Брайен и др. (2026) | моделирование динамики брожения пива | Сети LSTM |
| [ 192 ] | О’Коннор и др. (2002) | контроль процесса пивоварения | управление на основе нечеткой логики |
| [ 94 ] | Одди и др. (2025) | predicting hop cone ripening and optimal harvesting period | machine learning + IoT |
| [128] | Ogbu et al. (2026) | brewery production optimization | statistical and machine learning approaches |
| [229] | de Oliveira et al. (2017) | rapid monitoring of beer-quality attributes | UV-Vis spectroscopy |
| [92] | Patrício and Rieder (2018) | reviewing computer vision and AI for grain crops | review |
| [240] | Pérez-Calabuig et al. (2026) | detecting gluten in gluten-free beer | AI-powered computer vision |
| [156] | Pettigrew et al. (2015) | optimizing water use in brewery clean-in-place | reference nets |
| [255] | Pilone et al. (2023) | studying craft beer preferences and producer–consumer fit | random forest regression |
| [139] | Pogo et al. (2022) | representing mashing and boiling in craft beer production | virtual environment |
| [217] | Pornpanomchai and Suthamsmai (2008) | beer classification | electronic nose |
| [144] | Pribić et al. (2024) | modeling and optimizing triticale wort production | artificial neural network + genetic algorithm |
| [101] | Ramirez-Paredes and Hernandez-Belmonte (2020) | assessing malting barley quality | color, shape, and texture descriptors |
| [189] | Reid et al. (2021) | predicting fermentation rates in ale, lager, and whiskey | sigmoidal models |
| [142] | Rembold et al. (2024) | predicting wort density | LSTM network |
| [209] | Remmelzwaal (2023) | detecting and tracking crates and bottles in a bottling plant | deep learning for object detection and tracking |
| [126] | Rewak (2025) | generating brewing scenarios for batch fermentation scheduling | differential evolution |
| [95] | Rewak (2026) | beer recipe recommendation | heuristic and embedding models |
| [137] | Rewak and Rusiecki (2026) | dependable resource planning in smart breweries | digital twin of flexible batch fermentation processes |
| [241] | Rewak et al. (2026) | multi-attribute dataset of commercial bottles | dataset |
| [123] | Rewak (2026) | unified framework for production scheduling | review |
| [151] | Riverol and Napolitano (2002) | estimating the overall heat transfer coefficient under fouling in a flash pasteurizer | neural networks |
| [182] | Riverol and Cooney (2007) | estimating ester formation during beer fermentation | neural networks |
| [171] | Rousu et al. (1999) | predicting beer fermentation speed | neural networks and decision trees |
| [119] | Sáenz-Alanís et al. (2016) | batch scheduling in a brewing company | |
| [221] | Santos and Lozano (2015) | real-time detection of beer defects | handheld electronic nose |
| [222] | Santos et al. (2017) | reviewing electronic-nose applications in beer technology | review |
| [138] | Sarabia et al. (1999) | lauter tun control | neural networks |
| [136] | Schlechter et al. (2020) | engineering individualized beer brewing | digitalization methods |
| [11] | Schlechter (2024) | reviewing the impact of AI on the brewing industry | review |
| [87] | Schlechter et al. (2024) | developing a human-centric brewery | Industry 5.0 |
| [158] | Schreurs et al. (2024) | predicting and improving complex beer flavor | machine learning |
| [155] | Shen et al. (2019) | optimizing mash separation efficiency | statistical model |
| [220] | Siadat et al. (2014) | beer recognition from electronic-nose responses | supervised artificial neural networks |
| [231] | Sikorska et al. (2007) | discriminating beer flavors from volatile profiles | mass spectrometry used as an electronic nose |
| [235] | Silva et al. (2011) | identifying pale lager beers | image analysis |
| [169] | Simutis et al. (1993) | real-time state estimation and prediction during alcohol formation in brewing | fuzzy-aided neural network |
| [178] | Sipos et al. (2021) | estimating unmeasured fermentation state variables | neural networks |
| [141] | Song et al. (2001) | mashing assessment | machine-learning-based vision system |
| [239] | de Sousa Dutra et al. (2024) | predicting beer styles and brands | AI-based computer vision |
| [194] | Speers et al. (2003) | modeling industrial brewing fermentations | non-linear modeling |
| [80] | Su (2024) | optimizing brewery production decisions for sales and quality | multi-objective optimization |
| [130] | Sun (2023) | manufacturing scheduling | genetic algorithm + LSTM neural networks |
| [167] | Syu et al. (1994) | predicting brewing fermentation | neural networks |
| [102] | Szczypiński and Zapotoczny (2012) | barley kernel identification, orientation, and surface assessment | computer vision |
| [104] | Szczypiński et al. (2015) | identifying barley varieties | computer vision |
| [105] | Szczypiński et al. (2017) | identifying defects in barley kernels | image feature extraction and classification |
| [111] | Świerczyński et al. (2014) | identifying granary weevil in grain | artificial neural networks |
| [254] | Tabassum et al. (2025) | predicting sensory panel assessments in customized beer production | AI-based predictive modeling |
| [129] | Takahashi et al. (2019) | brewing process optimization | artificial neural networks + evolutionary algorithm |
| [173] | Trelea et al. (2001) | predicting brewing fermentation | модели прогнозирования, основанные на знаниях и методе «черного ящика» |
| [ 185 ] | Трелеа и др. (2004) | динамическая оптимизация производства аромата в процессе пивоварения | динамическая оптимизация |
| [ 165 ] | Ванн и др. (2017) | Онлайн-мониторинг и контроль критически важных параметров ферментации. | ближнеинфракрасная спектроскопия + управление с опережением |
| [ 160 ] | Васильева и Милева (2010) | мониторинг и контроль пивоварения | Программные инструменты на основе искусственного интеллекта |
| [ 9 ] | Виолино и др. (2020) | обзор интеллектуальных технологий во всей пивоваренной цепочке | обзор/структура «Интернета пива» |
| [ 223 ] | Восс и др. (2019) | определение содержания алкоголя в пиве | электронный нос |
| [ 114 ] | Вэй и др. (2006) | Определение жизнеспособности дрожжей без использования реагентов | машинное зрение на основе нейронных сетей + темнопольная микроскопия |
| [ 191 ] | Уитнелл и др. (1993) | Прогнозирование времени брожения на промышленном пивоваренном заводе | нечеткий предиктор |
| [ 253 ] | Уилсон и Треплтон (2003) | прогнозирование вкуса пива на основе химического анализа | нейронные сети |
| [ 135 ] | Вёстманн и др. (2022) | оптимизация рецептов на основе данных | Единые цифровые двойники + общие модели прогнозирования |
| [ 205 ] | Язди и др. (2011) | Проверка уровня наполнения и герметичности крышек во время розлива в бутылки. | алгоритм извлечения признаков |
| [ 159 ] | Ю и др. (2024) | Обзор подходов к применению искусственного интеллекта в традиционных ферментированных алкогольных напитках. | обзор |
| [ 196 ] | Замудио Лара и др. (2022) | оценка параметров динамических моделей брожения пива | оценка параметров динамических моделей |
| [ 183 ] | Чжан и др. (2012) | прогнозирование содержания уксусной кислоты в готовом пиве | нейронные сети + машины опорных векторов |
| [ 121 ] | Чжэн и Дай (2024) | планирование производства пива | совместная оптимизация + алгоритм роя хамелеонов |
| [ 261 ] | Чжоу и др. (2025) | связывание больших языковых моделей с обонятельной информацией | большие языковые модели |
Литература
- Pasteur, L. Études Sur La Bière, Ses Maladies, Causes Qui Les Provoquent, Procédé Pour La Rendre Inaltérable: Avec Une Théorie Nouvelle de La Fermentation; Gauthier-Villars: Paris, France, 1876. [Google Scholar]
- Hartley, A. Wastefulness in brewing. Trans. Lab. Club 1887, 1, 11–20. [Google Scholar] [CrossRef] [Scilit]
- LeCun, Y.; Bengio, Y.; Hinton, G. Deep learning. Nature 2015, 521, 436–444. [Google Scholar] [CrossRef] [Scilit]
- Topol, E.J. High-performance medicine: The convergence of human and artificial intelligence. Nat. Med. 2019, 25, 44–56. [Google Scholar] [CrossRef] [Scilit]
- Zhang, L.; Boom, R.M.; Ma, Y. Machine Learning in Automated Food Processing: A Mini Review. Annu. Rev. Food Sci. Technol. 2025, 16, 25–37. [Google Scholar] [CrossRef] [Scilit]
- Agrawal, K.; Goktas, P.; Holtkemper, M.; Beecks, C.; Kumar, N. AI-driven transformation in food manufacturing: A pathway to sustainable efficiency and quality assurance. Front. Nutr. 2025, 12, 1553942. [Google Scholar] [CrossRef] [Scilit]
- Izquierdo-Bueno, I.; Moraga, J.; Cantoral, J.M.; Carbú, M.; Garrido, C.; González-Rodríguez, V.E. Smart Viniculture: Applying Artificial Intelligence for Improved Winemaking and Risk Management. Appl. Sci. 2024, 14, 10277. [Google Scholar] [CrossRef] [Scilit]
- OECD; Group, B.C.; INSEAD. The Adoption of Artificial Intelligence in Firms: New Evidence for Policymaking; OECD Publishing: Paris, France, 2025. [Google Scholar] [CrossRef] [Scilit]
- Violino, S.; Figorilli, S.; Costa, C.; Pallottino, F. Internet of Beer: A Review on Smart Technologies from Mash to Pint. Foods 2020, 9, 950. [Google Scholar] [CrossRef] [Scilit]
- Nettesheim, P.; Burggräf, P.; Steinberg, F. Applications of machine learning in the brewing process: A systematic review. Discov. Artif. Intell. 2024, 4, 80. [Google Scholar] [CrossRef] [Scilit]
- Schlechter, T. Impact of AI on the Brewing Industry: A Comprehensive Summary. BrewingScience 2024, 77, 18–32. [Google Scholar]
- Dylkowski, W.; Gołębiewski, T. Technologia Browarnictwa; Wydawnictwo Przemysłu Lekkiego i Spożywczego: Warszawa, Poland, 1963. [Google Scholar]
- Farber, M.; Barth, R. Mastering Brewing Science: Quality and Production, 2nd ed.; Wiley: Hoboken, NJ, USA, 2025. [Google Scholar]
- McGregor, C.; McGregor, N. The Beer Brewing Guide: EBC Quality Handbook for Small Breweries; Lannoo: Tielt, Belgium, 2021. [Google Scholar]
- Jackowski, M. Filtracja brzeczki–jak usprawnić proces? Kierun. Spożywczy 2023, 3, 46–49. [Google Scholar]
- Hieronymus, S. For the Love of Hops: The Practical Guide to Aroma, Bitterness and the Culture of Hops; Brewers Association: Boulder, CO, USA, 2012. [Google Scholar]
- Lewis, M.; Young, T. Piwowarstwo; Wydawnictwo Naukowe PWN S.A.: Warszawa, Poland, 2001. [Google Scholar]
- Hornsey, I. Brewing; The Royal Society of Chemistry: Cambridge, UK, 2013. [Google Scholar]
- Salanţă, L.C.; Coldea, T.E.; Ignat, M.V.; Pop, C.R.; Tofană, M.; Mudura, E.; Borşa, A.; Pasqualone, A.; Zhao, H. Non-Alcoholic and Craft Beer Production and Challenges. Processes 2020, 8, 1382. [Google Scholar] [CrossRef] [Scilit]
- Hrivňák, J.; Šmogrovičová, D.; Nádaský, P.; Lakatošová, J. Determination of beer aroma compounds using headspace solid-phase microcolumn extraction. Talanta 2010, 83, 294–296. [Google Scholar] [CrossRef] [Scilit]
- Paz, A.I.; Blanco, C.A.; Andrés-Iglesias, C.; Palacio, L.; Pradanos, P.; Hernández, A. Aroma recovery of beer flavors by pervaporation through polydimethylsiloxane membranes. J. Food Process Eng. 2017, 40, e12556. [Google Scholar] [CrossRef] [Scilit]
- Anderson, R. Fermentation and Maturation: Manual of Good Practice; Fachverlag Hans Carl: Nürnberg, Germany, 2000. [Google Scholar]
- European Brewery Convention. Beer Filtration, Stabilisation and Sterilisation: Manual of Good Practice; Fachverlag Hans Carl: Nürnberg, Germany, 1999. [Google Scholar]
- Annemüller, G.; Manger, H.J. Applied Mathematics for Malting and Brewing Technologists: Technological Calculations, Benchmarks and Correlations for Process Optimization, English ed.; VLB Berlin: Berlin, Germany, 2017. [Google Scholar]
- Dragone, G.; Silva, D.P.; de Almeida E Silva, J.B. Factors influencing ethanol production rates at high-gravity brewing. LWT-Food Sci. Technol. 2004, 37, 797–802. [Google Scholar] [CrossRef] [Scilit]
- MacIntosh, A.J.; Josey, M.; Speers, R.A. An Examination of Substrate and Product Kinetics during Brewing Fermentations. J. Am. Soc. Brew. Chem. 2016, 74, 250–257. [Google Scholar] [CrossRef] [Scilit]
- Kucharczyk, K.; Żyła, K.; Tuszyński, T. Optimization of Fermentation Parameters in a Brewery: Modulation of Yeast Growth and Yeast Cell Viability. Processes 2025, 13, 906. [Google Scholar] [CrossRef] [Scilit]
- Mitchell, T.M. Machine Learning; McGraw-Hill: New York, NY, USA, 1997. [Google Scholar]
- Bishop, C.M. Pattern Recognition and Machine Learning; Springer: New York, NY, USA, 2006. [Google Scholar]
- Breiman, L. Statistical Modeling: The Two Cultures. Stat. Sci. 2001, 16, 199–231. [Google Scholar] [CrossRef] [Scilit]
- Jolliffe, I.T. Principal Component Analysis, 2nd ed.; Springer: New York, NY, USA, 2002. [Google Scholar] [CrossRef] [Scilit]
- Kohonen, T. The self-organizing map. Proc. IEEE 1990, 78, 1464–1480. [Google Scholar] [CrossRef] [Scilit]
- Sutton, R.S.; Barto, A.G. Reinforcement Learning: An Introduction, 2nd ed.; MIT Press: Cambridge, MA, USA, 2018. [Google Scholar]
- Bellman, R.E. Adaptive Control Processes: A Guided Tour; Princeton University Press: Princeton, NJ, USA, 1961. [Google Scholar]
- Wold, S.; Sjöström, M.; Eriksson, L. PLS-regression: A basic tool of chemometrics. Chemom. Intell. Lab. Syst. 2001, 58, 109–130. [Google Scholar] [CrossRef] [Scilit]
- Wold, S. Chemometrics; what do we mean with it, and what do we want from it? Chemom. Intell. Lab. Syst. 1995, 30, 109–115. [Google Scholar] [CrossRef] [Scilit]
- Breiman, L. Random Forests. Mach. Learn. 2001, 45, 5–32. [Google Scholar] [CrossRef] [Scilit]
- Cortes, C.; Vapnik, V. Support-vector networks. Mach. Learn. 1995, 20, 273–297. [Google Scholar] [CrossRef] [Scilit]
- Friedman, J.H. Greedy function approximation: A gradient boosting machine. Ann. Stat. 2001, 29, 1189–1232. [Google Scholar] [CrossRef] [Scilit]
- Rosenblatt, F. The perceptron: A probabilistic model for information storage and organization in the brain. Psychol. Rev. 1958, 65, 386–408. [Google Scholar] [CrossRef] [Scilit]
- Rumelhart, D.E.; Hinton, G.E.; Williams, R.J. Learning representations by back-propagating errors. Nature 1986, 323, 533–536. [Google Scholar] [CrossRef] [Scilit]
- Hornik, K.; Stinchcombe, M.; White, H. Multilayer feedforward networks are universal approximators. Neural Netw. 1989, 2, 359–366. [Google Scholar] [CrossRef] [Scilit]
- Goodfellow, I.; Bengio, Y.; Courville, A. Deep Learning; MIT Press: Cambridge, MA, USA, 2016. [Google Scholar]
- LeCun, Y.; Bottou, L.; Bengio, Y.; Haffner, P. Gradient-based learning applied to document recognition. Proc. IEEE 1998, 86, 2278–2324. [Google Scholar] [CrossRef] [Scilit]
- Krizhevsky, A.; Sutskever, I.; Hinton, G.E. ImageNet classification with deep convolutional neural networks. Commun. ACM 2017, 60, 84–90. [Google Scholar] [CrossRef] [Scilit]
- Bengio, Y.; Simard, P.; Frasconi, P. Learning long-term dependencies with gradient descent is difficult. IEEE Trans. Neural Netw. 1994, 5, 157–166. [Google Scholar] [CrossRef] [Scilit]
- Hochreiter, S.; Schmidhuber, J. Long Short-Term Memory. Neural Comput. 1997, 9, 1735–1780. [Google Scholar] [CrossRef] [Scilit]
- Vaswani, A.; Shazeer, N.; Parmar, N.; Uszkoreit, J.; Jones, L.; Gomez, A.N.; Kaiser; Polosukhin, I. Attention Is All You Need. Proc. Adv. Neural Inf. Process. Syst. 2017, 30, 5998–6008. [Google Scholar] [CrossRef] [Scilit]
- Pan, S.J.; Yang, Q. A Survey on Transfer Learning. IEEE Trans. Knowl. Data Eng. 2010, 22, 1345–1359. [Google Scholar] [CrossRef] [Scilit]
- Gardner, J.W.; Bartlett, P.N. A brief history of electronic noses. Sens. Actuators B Chem. 1994, 18, 210–211. [Google Scholar] [CrossRef] [Scilit]
- Vlasov, Y.; Legin, A.; Rudnitskaya, A.; Di Natale, C.; D’Amico, A. Nonspecific sensor arrays (“electronic tongue”) for chemical analysis of liquids. Pure Appl. Chem. 2005, 77, 1965–1983. [Google Scholar] [CrossRef] [Scilit]
- Holland, J.H. Adaptation in Natural and Artificial Systems; University of Michigan Press: Ann Arbor, MI, USA, 1975. [Google Scholar]
- Goldberg, D.E. Genetic Algorithms in Search, Optimization and Machine Learning; Addison-Wesley: Reading, MA, USA, 1989. [Google Scholar]
- Storn, R.; Price, K. Differential Evolution—A Simple and Efficient Heuristic for Global Optimization over Continuous Spaces. J. Glob. Optim. 1997, 11, 341–359. [Google Scholar] [CrossRef] [Scilit]
- Deb, K.; Pratap, A.; Agarwal, S.; Meyarivan, T. A fast and elitist multiobjective genetic algorithm: NSGA-II. IEEE Trans. Evol. Comput. 2002, 6, 182–197. [Google Scholar] [CrossRef] [Scilit]
- Pinedo, M.L. Scheduling: Theory, Algorithms, and Systems, 5th ed.; Springer: Cham, Switzerland, 2016. [Google Scholar] [CrossRef] [Scilit]
- Zadeh, L.A. Fuzzy sets. Inf. Control 1965, 8, 338–353. [Google Scholar] [CrossRef] [Scilit]
- Mamdani, E.H.; Assilian, S. An experiment in linguistic synthesis with a fuzzy logic controller. Int. J. Man.-Mach. Stud. 1975, 7, 1–13. [Google Scholar] [CrossRef] [Scilit]
- Camacho, E.F.; Bordons, C. Model Predictive Control, 2nd ed.; Springer: London, UK, 2007. [Google Scholar] [CrossRef] [Scilit]
- Kadlec, P.; Gabrys, B.; Strandt, S. Data-driven Soft Sensors in the process industry. Comput. Chem. Eng. 2009, 33, 795–814. [Google Scholar] [CrossRef] [Scilit]
- Kagermann, H.; Wahlster, W.; Helbig, J. Recommendations for Implementing the Strategic Initiative INDUSTRIE 4.0; Technical report; Acatech–National Academy of Science and Engineering: Frankfurt am Main, Germany, 2013. [Google Scholar]
- Lasi, H.; Fettke, P.; Kemper, H.G.; Feld, T.; Hoffmann, M. Industry 4.0. Bus. Inf. Syst. Eng. 2014, 6, 239–242. [Google Scholar] [CrossRef] [Scilit]
- European Commission; Directorate-General for Research and Innovation. Industry 5.0: Towards a Sustainable, Human-Centric and Resilient European Industry; Technical Report; Publications Office of the European Union: Luxembourg, 2021. [Google Scholar] [CrossRef]
- Grieves, M.; Vickers, J. Digital Twin: Mitigating Unpredictable, Undesirable Emergent Behavior in Complex Systems. In Transdisciplinary Perspectives on Complex Systems; Kahlen, F.J., Flumerfelt, S., Alves, A., Eds.; Springer: Cham, Switzerland, 2017; pp. 85–113. [Google Scholar] [CrossRef] [Scilit]
- Jones, D.; Snider, C.; Nassehi, A.; Yon, J.; Hicks, B. Characterising the Digital Twin: A systematic literature review. CIRP J. Manuf. Sci. Technol. 2020, 29, 36–52. [Google Scholar] [CrossRef] [Scilit]
- Mikolov, T.; Sutskever, I.; Chen, K.; Corrado, G.; Dean, J. Distributed Representations of Words and Phrases and their Compositionality. In Proceedings of the Advances in Neural Information Processing Systems 26 (NIPS 2013), Lake Tahoe, NV, USA, 5–10 December 2013; pp. 3111–3119. [Google Scholar] [CrossRef] [Scilit]
- Brown, T.B.; Mann, B.; Ryder, N.; Subbiah, M.; Kaplan, J.; Dhariwal, P.; Neelakantan, A.; Shyam, P.; Sastry, G.; Askell, A.; et al. Language Models are Few-Shot Learners. In Proceedings of the Advances in Neural Information Processing Systems 33 (NeurIPS2020), Virtual, 6–12 December 2020; pp. 1877–1901. [Google Scholar] [CrossRef] [Scilit]
- Wooldridge, M. An Introduction to MultiAgent Systems, 2nd ed.; John Wiley & Sons: Chichester, UK, 2009. [Google Scholar]
- Hastie, T.; Tibshirani, R.; Friedman, J. The Elements of Statistical Learning: Data Mining, Inference, and Prediction, 2nd ed.; Springer: New York, NY, USA, 2009. [Google Scholar] [CrossRef]
- Ribeiro, M.T.; Singh, S.; Guestrin, C. “Why Should I Trust You?”: Explaining the Predictions of Any Classifier. In Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, San Francisco, CA, USA, 13–17 August 2016; pp. 1135–1144. [Google Scholar] [CrossRef] [Scilit]
- Lundberg, S.M.; Lee, S.I. A Unified Approach to Interpreting Model Predictions. In Proceedings of the Advances in Neural Information Processing Systems, Long Beach, CA, USA, 4–9 December 2017; pp. 4765–4774. [Google Scholar] [CrossRef] [Scilit]
- McMahan, B.; Moore, E.; Ramage, D.; Hampson, S.; Agüera, Y.; Arcas, B. Communication-Efficient Learning of Deep Networks from Decentralized Data. In Proceedings of the 20th International Conference on Artificial Intelligence and Statistics (AISTATS), Fort Lauderdale, FL, USA, 20–22 April 2017; pp. 1273–1282. [Google Scholar] [CrossRef] [Scilit]
- Ding, L.; Lawson, C.; Shapira, P. Rise of Generative Artificial Intelligence in Science. Scientometrics 2025, 130, 5093–5114. [Google Scholar] [CrossRef] [Scilit]
- BarthHaas. BarthHaas Report 2024/25; Technical report; BarthHaas GmbH & Co. KG: Nuremberg, Germany, 2025. [Google Scholar]
- Kirin Holdings. Global Beer Consumption by Country in 2024; Technical report; Kirin Holdings Company, Limited: Tokyo, Japan, 2025; Press release. [Google Scholar]
- United Nations, Department of Economic and Social Affairs, Population Division. World Population Prospects 2024: Summary of Results; Technical report; United Nations: New York, NY, USA, 2024. [Google Scholar]
- Ghasemi-Varnamkhasti, M.; Mohtasebi, S.S.; Rodriguez-Mendez, M.L.; Lozano, J.R.; Razavi, S.H.; Ahmadi, H. Potential application of electronic nose technology in brewery. Trends Food Sci. Technol. 2011, 22, 165–174. [Google Scholar] [CrossRef] [Scilit]
- Grassi, S.; Amigo, J.M.; Lyndgaard, C.B.; Foschino, R.; Casiraghi, E. Beer fermentation: Monitoring of process parameters by FT-NIR and multivariate data analysis. Food Chem. 2014, 155, 279–286. [Google Scholar] [CrossRef] [Scilit]
- Cajka, T.; Riddellova, K.; Tomaniova, M.; Hajslova, J. Recognition of beer brand based on multivariate analysis of volatile fingerprint. J. Chromatogr. A 2010, 1217, 4195–4203. [Google Scholar] [CrossRef] [Scilit]
- Su, C. Optimization decisions in the brewery industry—Maximize Total Sales & Quality Score. In Proceedings of the ICCSMT’24: Proceeding of the 2024 5th International Conference on Computer Science and Management Technology, Xiamen, China, 18–20 October 2024. [Google Scholar] [CrossRef] [Scilit]
- Hlangwani, E.; Doorsamy, W.; Adebiyi, J.A.; Fajimi, L.I.; Adebo, O.A. A modeling method for the development of a bioprocess to optimally produce umqombothi (a South African traditional beer). Sci. Rep. 2021, 11, 20626. [Google Scholar] [CrossRef] [Scilit]
- Hu, J.; Lin, B.; Fu, X. Immersion in cheers: Experiencescape, customer inspiration, and drink statues in craft beer tourism using PLS-SEM, IPMA, and ANN. J. Vacat. Mark. 2026. [Google Scholar] [CrossRef] [Scilit]
- Nettesheim, P.; Burggräf, P.; Steinberg, F. A design concept for data-driven brewing: Sensor-based system architecture and ML applications for sustainability in micro-breweries. Discov. Artif. Intell. 2026, 6, 307. [Google Scholar] [CrossRef] [Scilit]
- Dias, A.L.; Pereira, G.M.; Da Silva, J.C.R.; Turcato, A.C.; Sestito, G.S. Proposal for Digital Transformation in Production Processes of Microbreweries: A Brazilian Market Approach. In Proceedings of the 2023 15th IEEE International Conference on Industry Applications (INDUSCON), São Bernardo do Campo, Brazil, 22–24 November 2023; pp. 1569–1575. [Google Scholar] [CrossRef] [Scilit]
- Lee, A.; Manrique Negrin, D.A.; Cleophas, L. Evaluating Open-Source Tools for Heterogeneous Model-Based Digital Twin Development: A Microbrewery Case Study. In Proceedings of the 2024 Annual Modeling and Simulation Conference (ANNSIM), Washington, DC, USA, 20–23 May 2024. [Google Scholar] [CrossRef] [Scilit]
- Deuse, J.; Wöstmann, R.; Syberg, M.; West, N.; Wagstyl, D.; Moreno, V.H. Establishing a Machine Learning and Internet of Things Learning Infrastructure by Operating Transnational Cyber-Physical Brewing Labs. In Proceedings of the Learning Factories of the Future (CFL 2024), Enschede, The Netherlands, 17–19 April 2024. [Google Scholar] [CrossRef] [Scilit]
- Schlechter, T.; Kopylov, P.; Wegen, J.; Manfrefi, K.; Nicoletti, L.; Padovano, A.; Cardamone, M.; Francalanza, E.; Siedl, M. Development and case study of an Industry 5.0 ready human-centric related brewing plant. Agron. Res. 2024, 22, 956–969. [Google Scholar] [CrossRef]
- Briatore, F.; Mosca, M.; Arena, S.; Orrù, P.F. Resilience 4.0 in beer production line: IoT, Edge Computing, Fog Computing, and Cloud. In Proceedings of the Summer School Francesco Turco—Industrial Systems Engineering, Lecce, Italy, 11–13 September 2024. [Google Scholar]
- Bowler, A.L.; Rodgers, S.; Meng, F.; McKechnie, J.; Cook, D.J.; Watson, N.J. Development of an open-source carbon footprint calculator of the UK craft brewing value chain. J. Clean. Prod. 2024, 435, 140181. [Google Scholar] [CrossRef] [Scilit]
- Markovic, M.; Li, A.; Ayall, T.A.; Watson, N.J.; Bowler, A.L.; Woods, M.; Edwards, P.; Ramsey, R.; Beddows, M.; Kuhnert, M.; et al. Embedding AI-Enabled Data Infrastructures for Sustainability in Agri-Food: Soft-Fruit and Brewery Use Case Perspectives. Sensors 2024, 24, 7327. [Google Scholar] [CrossRef] [Scilit]
- Li, Z.; Peng, D. Tensor network-driven pathway optimization for brewery waste recycling: A multi-scale decision framework towards carbon neutrality. Process Saf. Environ. Prot. 2026, 209, 108599. [Google Scholar] [CrossRef] [Scilit]
- Patrício, D.I.; Rieder, R. Computer vision and artificial intelligence in precision agriculture for grain crops: A systematic review. Comput. Electron. Agric. 2018, 153, 69–81. [Google Scholar] [CrossRef] [Scilit]
- Lamagna, A.; Reich, S.; Rodriguez, D.; Scoccola, N.N. Performance of an e-nose in hops classification. Sens. Actuators B Chem. 2004, 102, 278–283. [Google Scholar] [CrossRef] [Scilit]
- Oddi, G.; Galaverni, M.; Belli, L.; Rodolfi, M.; Davoli, L.; Ferrari, G.; Ganino, T. Prediction of hop cone ripening through Internet of Things (IoT) and Machine Learning (ML) technologies. Comput. Electron. Agric. 2025, 239, 110830. [Google Scholar] [CrossRef] [Scilit]
- Rewak, K. AI Assistant for Craft Breweries: Heuristic and Embedding Models for Beer Recipe Recommendations. In Proceedings of the Frontiers in Data Engineering and Retrieval Systems; Obaid, A.J., Polkowski, Z., Balas, V.E., Muthmainnah, M., Eds.; STEAM-H: Science, Technology, Engineering, Agriculture, Mathematics & Health: Cham, Switzerland, 2026. [Google Scholar]
- Bravin, M.; Pfäffli, D.; Kuhn, K.; Pouly, M. Towards Crafting Beer with Artificial Intelligence. In Proceedings of the SDS—2021 8th Swiss Conference on Data Science, Lucerne, Switzerland, 9 June 2021. [Google Scholar] [CrossRef] [Scilit]
- Ermi, G.; Ayton, E.; Price, N.; Hutchinson, B. Deep Learning Approaches to Chemical Property Prediction from Brewing Recipes. In Proceedings of the 2018 International Joint Conference on Neural Networks (IJCNN), Rio de Janeiro, Brazil, 8–13 July 2018; pp. 1–7. [Google Scholar] [CrossRef] [Scilit]
- Castro, P.; Luz, E.; Moreira, G. Dataset for Hop varieties classification. Data Brief. 2021, 38, 107312. [Google Scholar] [CrossRef] [Scilit]
- Castro, P.; Moreira, G.; Luz, E. An End-to-End Deep Learning System for Hop Classification. IEEE Lat. Am. Trans. 2021, 20, 430–442. [Google Scholar] [CrossRef] [Scilit]
- Castro, P.; Fortuna, G.; Silva, P.; Bianchi, A.G.C.; Moreira, G.; Luz, E. Merging Traditional Feature Extraction and Deep Learning for Enhanced Hop Variety Classification: A Comparative Study Using the UFOP-HVD Dataset. In Proceedings of the Intelligent Systems: 12th Brazilian Conference, BRACIS 2023; Naldi, M.C., Bianchi, R.A.C., Eds.; Lecture Notes in Computer Science; Springer: Cham, Switzerland, 2023. [Google Scholar] [CrossRef] [Scilit]
- Ramirez-Paredes, J.P.; Hernandez-Belmonte, U.H. Visual quality assessment of malting barley using color, shape and texture descriptors. Comput. Electron. Agric. 2020, 168, 105110. [Google Scholar] [CrossRef] [Scilit]
- Szczypiński, P.M.; Zapotoczny, P. Computer vision algorithm for barley kernel identification, orientation estimation and surface structure assessment. Comput. Electron. Agric. 2012, 87, 32–38. [Google Scholar] [CrossRef] [Scilit]
- Guevara-Hernández, F.; Gomez-Gil, J. A machine vision system for classification of wheat and barley grain kernels. Span. J. Agric. Res. 2011, 9, 672–680. [Google Scholar] [CrossRef] [Scilit]
- Szczypiński, P.M.; Klepaczko, A.; Zapotoczny, P. Identifying barley varieties by computer vision. Comput. Electron. Agric. 2015, 110, 1–8. [Google Scholar] [CrossRef] [Scilit]
- Szczypiński, P.M.; Klepaczko, A.; Kociołek, M. Barley defects identification. In Proceedings of the 2017 10th International Symposium on Image and Signal Processing and Analysis (ISPA), Ljubljana, Slovenia, 18–20 September 2017; pp. 216–219. [Google Scholar] [CrossRef] [Scilit]
- Kozłowski, M.; Górecki, P.; Szczypiński, P.M. Varietal classification of barley by convolutional neural networks. Biosyst. Eng. 2019, 184, 155–165. [Google Scholar] [CrossRef] [Scilit]
- Kozłowski, M.; Szczypiński, P.M.; Reiner, J.; Lampa, P.; Mrzygłód, M.; Szturo, K.; Zapotoczny, P. Identifying defects and varieties of Malting Barley Kernels. Sci. Rep. 2024, 14, 22143. [Google Scholar] [CrossRef] [Scilit]
- Embeyale, D.; Chen, Y.T.; Assabie, Y. Automatic grading of barley grain for brewery industries using convolutional neural network based on texture features. J. Agric. Food Res. 2025, 20, 101752. [Google Scholar] [CrossRef] [Scilit]
- Fornal, J.; Jeliński, T.; Sadowska, J.; Grundas, S.; Nawrot, J.; Niewiada, A.; Warchalewski, J.R.; Błaszczak, W. Detection of granary weevil Sitophilus granarius (L.) eggs and internal stages in wheat grain using soft X-ray and image analysis. J. Stored Prod. Res. 2007, 43, 142–148. [Google Scholar] [CrossRef] [Scilit]
- Boniecki, P.; Piekarska-Boniecka, H.; Świerczyński, K.; Koszela, K.; Zaborowicz, M.; Przybył, J. Detection of the granary weevil based on X-ray images of damaged wheat kernels. J. Stored Prod. Res. 2014, 56, 38–42. [Google Scholar] [CrossRef] [Scilit]
- Świerczyński, K.; Olejarski, P.; Boniecki, P. Using of artificial neuronal networks in identification process of granary weevils. J. Res. Appl. Agric. Eng. 2014, 53, 73–75. [Google Scholar]
- Boniecki, P.; Koszela, K.; Świerczyński, K.; Skwarcz, J.; Zaborowicz, M.; Przybył, J. Neural Visual Detection of Grain Weevil (Sitophilus granarius L.). Agriculture 2020, 10, 25. [Google Scholar] [CrossRef] [Scilit]
- Carvalhal Pinto, M.B.; Ghion, R.D.A.C.; Schmidt, F.L. Machine Learning Approach to Enhancing Drying Efficiency of Hop (Humulus lupulus L.). BrewingScience 2023, 76, 48–57. [Google Scholar] [CrossRef]
- Wei, N.; Flaschel, E.; Saalbach, A.; Twellmann, T.; Nattkemper, T.W. Reagent-free automatic cell viability determination using neural networks based machine vision and dark-field microscopy in Saccharomyces cerevisiae. In Proceedings of the 2005 IEEE Engineering in Medicine and Biology 27th Annual Conference, Shanghai, China, 17–18 January 2006. [Google Scholar] [CrossRef] [Scilit]
- Feizi, A.; Zhang, Y.; Greenbaum, A.; Guziak, A.; Luong, M.; Chan, R.Y.L.; Berg, B.; Ozkan, H.; Luo, W.; Wu, M.; et al. Rapid, portable and cost-effective yeast cell viability and concentration analysis using lensfree on-chip microscopy and machine learning. Lab A Chip 2016, 16, 4350–4358. [Google Scholar] [CrossRef] [Scilit]
- Nadybski, P.; Rewak, K. Wykorzystanie metod inteligentnej optymalizacji w celu podnoszenia efektywności procesów produkcyjnych. In Smart Industry; Medyński, D., Dąbrowska, M., Kolbusz, K., Eds.; Polskie Towarzystwo Ekonomiczne, Oddział w Poznaniu: Poznań, Poland, 2022; pp. 327–338. [Google Scholar]
- Baldo, T.A.; Santos, M.O.; Almada-Lobo, B.; Morabito, R. An optimization approach for the lot sizing and scheduling problem in the brewery industry. Comput. Ind. Eng. 2014, 72, 58–71. [Google Scholar] [CrossRef] [Scilit]
- Baldo, T.A.; Morabito, R.; Santos, M.O.; Guimarães, L. Alternative Mathematical Models and Solution Approaches for Lot-Sizing and Scheduling Problems in the Brewery Industry: Analyzing Two Different Situations. Math. Probl. Eng. 2017, 2017, 6754970. [Google Scholar] [CrossRef] [Scilit]
- Sáenz-Alanís, C.A.; D., J.V.; Salazar-Aguilar, M.A.; Boyer, V. A parallel machine batch scheduling problem in a brewing company. Int. J. Adv. Manuf. Technol. 2016, 87, 65–75. [Google Scholar] [CrossRef] [Scilit]
- Georgiadis, G.; Elekidis, A.; Georgiadis, M. Optimal Production Planning and Scheduling in Breweries. Food Bioprod. Process. 2021, 125, 204–221. [Google Scholar] [CrossRef] [Scilit]
- Zheng, S.; Dai, C. Collaborative Optimization Algorithm Based on Chameleon Swarm Algorithm Designed for the Problem of Beer Production Scheduling. Appl. Sci. 2024, 14, 6562. [Google Scholar] [CrossRef] [Scilit]
- Lipka, J.B.; Höttecke, L.; Stursberg, P.; Metzger, M.; Heger, H.J.; Niessen, S. Including batch scheduling flexibility in industrial energy system design and dispatch optimization: A case study of a brewery. Energy 2026, 346, 140295. [Google Scholar] [CrossRef] [Scilit]
- Rewak, K. Towards a Generalized Framework for Brewery Production Scheduling. Procedia Comput. Sci. 2026; accepted.
- Li, Y. Backorder Prediction Using Machine Learning For Danish Craft Beer Breweries. Master’s Thesis, Aalborg University, Aalborg, Denmark, 2019. [Google Scholar]
- Nettesheim, P.; Burggräf, P.; Steinberg, F. Enhancing brewery logistics with smart kegs: A simulation study. J. Transp. Supply Chain Manag. 2024, 18, 12. [Google Scholar] [CrossRef] [Scilit]
- Rewak, K. Optimizing batch fermentation scheduling in smart breweries with artificial intelligence methods. Procedia Comput. Sci. 2025, 270, 2838–2847. [Google Scholar] [CrossRef] [Scilit]
- Akaninwor, G.C.; Isaac, O.E.; Nkoi, B. Optimization of Production in a Brewery using Artificial Neural Network. J. Newviews Eng. Technol. 2021, 3, 43–53. [Google Scholar]
- Ogbu, C.M.; Okafor, B.E.; Obiukwu, O.O.; Opara, V.U.; Ekpechi, D.A. Statistical and Machine Learning Approaches to Production Optimization in the Brewery Industry. Intell. Sustain. Manuf. 2026, 3, 10013. [Google Scholar] [CrossRef] [Scilit]
- Takahashi, M.B.; de Oliveira, H.C.; Fernández Núñez, E.G.; Rocha, J.C. Brewing process optimization by artificial neural network and evolutionary algorithm approach. J. Food Process Eng. 2019, 42, e13103. [Google Scholar] [CrossRef] [Scilit]
- Sun, H. Optimizing Manufacturing Scheduling with Genetic Algorithm and LSTM Neural Networks. Int. J. Simul. Model. 2023, 22, 508–519. [Google Scholar] [CrossRef] [Scilit]
- Hassen, E.B.; Asmare, A.M. Predictive performance modeling of Habesha brewery wastewater treatment plant using artificial neural networks. Chem. Int. 2019, 5, 87–96. [Google Scholar] [CrossRef]
- Mickein, M.; Koch, M.; Haase, K. A Decision Support System for Brewery Production Planning at Feldschlösschen. Inf. J. Appl. Anal. 2021, 52, 158–172. [Google Scholar] [CrossRef] [Scilit]
- Mickein, M.; Koch, M.; Haase, K. Data-Driven Decision Making for Strategic Production Planning in a Brewing Company. In Proceedings of the Operations Research Proceedings 2021; Lecture Notes in Operations Research; Trautmann, N., Gnägi, M., Eds.; Springer: Cham, Switzerland, 2022; pp. 375–381. [Google Scholar] [CrossRef] [Scilit]
- Koulouris, A.; Misailidis, N.; Petrides, D. Applications of process and digital twin models for production simulation and scheduling in the manufacturing of food ingredients and products. Food Bioprod. Process. 2021, 126, 317–333. [Google Scholar] [CrossRef] [Scilit]
- Wöstmann, R.; Borggräfe, T.; Janßen, S.; Kimberger, J.; Ould, S.; Bennett, N.; Moreno, V.H.; Deuse, J. Data-driven recipe optimisation based on unified digital twins and shared prediction models. In Proceedings of the 34th European Modeling & Simulation Symposium (EMSS 2022), Rome, Italy, 19–21 September 2022. [Google Scholar] [CrossRef] [Scilit]
- Schlechter, T.; Froschauer, R.; Bronowicka-Schlechter, A. Towards a business and production engineering concept for individual beer brewing applying digitalization methodologies. Agron. Res. 2020, 18, 989–999. [Google Scholar] [CrossRef]
- Rewak, K.; Rusiecki, A. Dependable Resource Planning in Smart Breweries through a Digital Twin of Flexible Batch Fermentation Processes. In Proceedings of the Dependable Computer Systems: Methods, Models, and Applications; Lecture Notes in Networks and Systems; Zamojski, W., Mazurkiewicz, J., Sugier, J., Walkowiak, T., Kacprzyk, J., Eds.; Springer: Cham, Swizerland, 2026. [Google Scholar] [CrossRef] [Scilit]
- Sarabia, E.G.; Llata, J.R.; Fernandez, D.; Oria, J.P.; Landaluce, R. Lauter Tun control by neural networks. In Proceedings of the 1999 International Conference on Information Intelligence and Systems, Bethesda, MD, USA, 31 October–3 November 1999; pp. 242–248. [Google Scholar] [CrossRef] [Scilit]
- Pogo, S.I.; Granizo, J.; Andaluz, V.H.; Varela-Aldas, J. Virtual Environment for the Mashing and Boiling Process in Craft Beer Production. In Proceedings of the Seventh International Congress on Information and Communication Technology; Springer: Singapore, 2022. [Google Scholar] [CrossRef] [Scilit]
- Nimbalkar, S.; Supekar, S.D.; Meadows, W.; Wenning, T.; Guo, W.; Cresko, J. Enhancing operational performance and productivity benefits in breweries through smart manufacturing technologies. J. Adv. Manuf. Process. 2020, 2, 1–12. [Google Scholar] [CrossRef] [Scilit]
- Song, A.; Ciesielski, V.; Rogers, P.J. Vision system development by machine learning: Mashing assessment in brewing. Appl. Artif. Intell. 2001, 15, 777–795. [Google Scholar] [CrossRef] [Scilit]
- Rembold, D.; Stauss, B.; Schwarzkopf, S. Prediction of Wort Density with LSTM Network. arXiv 2024, arXiv:2403.06458. [Google Scholar] [CrossRef] [Scilit]
- Estracanholli, E.S.; Barreiro, J.C.; Diegues, F.S.; Bagnato, V.S. Real time quantification of carbohydrates in beer wort by FTIR and neural network analysis. J. Food Sci. Technol. 2024. [Google Scholar] [CrossRef] [Scilit]
- Pribić, M.; Kamenko, I.; Despotović, S.; Mirosavljević, M.; Pejin, J. Modeling and Optimization of Triticale Wort Production Using an Artificial Neural Network and a Genetic Algorithm. Foods 2024, 13, 343. [Google Scholar] [CrossRef] [Scilit]
- Bai, J.; Pu, T.; Xing, J.; Niu, G.; Zhang, S.; Liu, Q. Research on energy consumption analysis of beer brewing process. In Proceedings of the 2011 International Conference on Electronic & Mechanical Engineering and Information Technology, Harbin, China, 12–14 August 2011; pp. 182–185. [Google Scholar] [CrossRef] [Scilit]
- Conduah, J.E.; Kusakana, K.; Odufuwa, O.; Hohne, P.; Ma, T. Forecasting energy consumption and enhancing sustainability in microbreweries: Integrating ANN-based models with thermal storage solutions. J. Energy Storage 2025, 112, 115508. [Google Scholar] [CrossRef] [Scilit]
- Peterson, S.D.; Amón, R.; Wong, T.; Spang, E.S.; Simmons, C.W. Material and energy flow analysis of craft brewing: A case study at a California microbrewery. Front. Sustain. Food Syst. 2022, 6, 1028520. [Google Scholar] [CrossRef] [Scilit]
- Costa Júnior, L.F.; de Freitas Silva Valente, G.; da Mota Costa Silva, M. Modelling of the extraction of phenolic compounds from beer malt bagasse using artificial neural network. Braz. J. Dev. 2020, 6, 74010–74023. [Google Scholar] [CrossRef] [Scilit]
- Dewasme, L. Neural network-based software sensors for the estimation of key components in brewery wastewater anaerobic digester: An experimental validation. Water Sci. Technol. 2019, 80, 1975–1985. [Google Scholar] [CrossRef] [Scilit]
- Akinpelu, E.A.; Ntwampe, S.K.O.; Taiwo, A.E.; Nchu, F. Optimising Brewery-Wastewater-Supported Acid Mine Drainage Treatment vis-à-vis Response Surface Methodology and Artificial Neural Network. Processes 2020, 8, 1485. [Google Scholar] [CrossRef] [Scilit]
- Riverol, C.; Napolitano, V. Estimation of the overall heat transfer coefficient in a tubular heat exchanger under fouling using neural networks. Application in a flash pasteurizer. Int. Commun. Heat Mass Transf. 2002, 29, 453–457. [Google Scholar] [CrossRef] [Scilit]
- Hou, D.B.; Zhou, Z.; Zhang, G.X. On-line measurement for the BHE fouling of brewery wort evaporator using a soft sensing approach. In Proceedings of the IEEE International Conference on Industrial Technology, Maribor, Slovenia, 10–12 December 2003. [Google Scholar] [CrossRef] [Scilit]
- Hou, D.; Zhou, Z. A Novel Measurement Scheme for Periodic Fouling in Recipe Alternation Based on Hybrid Fuzzy Neural Network. In Proceedings of the 2005 IEEE International Conference on Systems, Man and Cybernetics, Waikoloa, HI, USA, 12 October 2005; pp. 1280–1285. [Google Scholar] [CrossRef] [Scilit]
- Edgar, B.; Eze, V.H.U.; Adam, S.A.; Yinka, S.; Erheyovwe, B.P. Hybrid Thermodynamic and Machine Learning Optimization of Plate Heat Exchanger Performance for Brewery Cooling Systems in Uganda. Open Res. Afr. 2025, 8, 24. [Google Scholar] [CrossRef] [Scilit]
- Shen, Q.F.; Weaser, M.; Griffiths, L.; Gerogiorgis, D.I. Statistical Modelling for Optimisation of Mash Separation Efficiency in Industrial Beer Production. Comput. Aided Chem. Eng. 2019, 46, 1465–1470. [Google Scholar] [CrossRef] [Scilit]
- Pettigrew, L.; Blomenhofer, V.; Hubert, S.; Groß, F.; Delgado, A. Optimisation of water usage in a brewery clean-in-place system using reference nets. J. Clean. Prod. 2015, 87, 583–593. [Google Scholar] [CrossRef] [Scilit]
- Al-Rifaie, M.M.; Cavazza, M. Multi-Objective Evolutionary Beer Optimisation. In Proceedings of the GECCO 2022—Genetic and Evolutionary Computation Conference, Boston, MA, USA, 9–13 July 2022. [Google Scholar] [CrossRef] [Scilit]
- Schreurs, M.; Piampongsant, S.; Roncoroni, M.; Cool, L.; Herrera-Malaver, B.; Vanderaa, C.; Theßeling, F.A.; Kreft; Botzki, A.; Malcorps, P.; et al. Predicting and improving complex beer flavor through machine learning. Nat. Commun. 2024, 15, 2368. [Google Scholar] [CrossRef] [Scilit]
- Yu, H.; Liu, S.; Qin, H.; Zhou, Z.; Zhao, H.; Zhang, S.; Mao, J. Artificial intelligence-based approaches for traditional fermented alcoholic beverages’ development: Review and prospect. Crit. Rev. Food Sci. Nutr. 2024, 64, 2879–2889. [Google Scholar] [CrossRef] [Scilit]
- Vassileva, S.; Mileva, S. Ai-Based Software Tools for Beer Brewing Monitoring and Control. Biotechnol. Biotechnol. Equip. 2010, 24, 1936–1939. [Google Scholar] [CrossRef] [Scilit]
- Dazzarola, C.; Tighe, R.; Pérez-Correa, J.R.; Saa, P.A. Toward a digital twin for beer quality control: Development of a digital model integrating industrial process data and model-based fermentation descriptors. J. Food Eng. 2026, 403, 112726. [Google Scholar] [CrossRef] [Scilit]
- Muctadir, H.M.; Liao, Y.; Cleophas, L. Model Consistency Management of a Brewery Digital Twin. In Proceedings of the ACM/IEEE 28th International Conference on Model Driven Engineering Languages and Systems Companion (MODELS-C), Grand Rapids, MI, USA, 5–10 October 2025. [Google Scholar] [CrossRef] [Scilit]
- Goffi, P.E.; Tremblay, R.; Oakes, B. Engineering a Digital Twin for the Monitoring and Control of Beer Fermentation Sampling. In Proceedings of the EDTconf, Grand Rapids, MI, USA, 6–7 October 2025; Volume 2025. [Google Scholar] [CrossRef] [Scilit]
- Buonocore, D.; Ciavolino, G.; Dello Iacono, S.; Liguori, C. Online Identification of Beer Fermentation Phases. Fermentation 2024, 10, 399. [Google Scholar] [CrossRef] [Scilit]
- Vann, L.; Layfield, J.B.; Sheppard, J.D. The application of near-infrared spectroscopy in beer fermentation for online monitoring of critical process parameters and their integration into a novel feedforward control strategy. J. Inst. Brew. 2017, 123, 347–360. [Google Scholar] [CrossRef] [Scilit]
- D’Amore, T.; Celotto, G.; Austin, G.D.; Stewart, G.G. Neural network modeling: Applications to brewing fermentations. In Proceedings of the European Brewery Convention: 24th Congress Oslo 1993, Oslo, Norway, 28 October 1993. [Google Scholar] [CrossRef] [Scilit]
- Syu, M.J.; Tsao, G.T.; Austin, G.D.; Celotto, G.; D’Amore, T. Neural Network Modeling for Predicting Brewing Fermentations. J. Am. Soc. Brew. Chem. 1994, 52, 15–19. [Google Scholar] [CrossRef]
- García, L.A.; Argüeso, F.; García, A.I.; Díaz, M. Application of neural networks for controlling and predicting quality parameters in beer fermentation. J. Ind. Microbiol. 1995, 15, 401–406. [Google Scholar] [CrossRef] [Scilit]
- Simutis, R.; Havlik, I.; Lübbert, A. Fuzzy-aided neural network for real-time state estimation and process prediction in the alcohol formation step of production-scale beer brewing. J. Biotechnol. 1993, 27, 203–215. [Google Scholar] [CrossRef] [Scilit]
- Gvazdaitis, G.; Beil, S.; Kreibaum, U.; Simutis, R.; Havlik, I.; Dors, M.; Schneider, F.; Lübbert, A. Temperature control in fermenters: Application of neural nets and feedback control in breweries. J. Inst. Brew. 1994, 100, 99–104. [Google Scholar] [CrossRef] [Scilit]
- Rousu, J.; Elomaa, T.; Aarts, R. Predicting the speed of beer fermentation in laboratory and industrial scale. In Proceedings of the Engineering Applications of Bio-Inspired Artificial Neural Networks (IWANN 1999); Springer: Berlin/Heidelberg, Germany, 1999. [Google Scholar] [CrossRef] [Scilit]
- Corrieu, G.; Trelea, I.C.; Perret, B. On-line estimation and prediction of density and ethanol evolution in the brewery. Tech. Q. 2000, 37, 173–181. [Google Scholar]
- Trelea, I.C.; Titica, M.; Landaud, S.; Latrille, E.; Corrieu, G.; Cheruy, A. Predictive modelling of brewing fermentation: From knowledge-based to black-box models. Math. Comput. Simul. 2001, 56, 405–424. [Google Scholar] [CrossRef] [Scilit]
- Becker, T.; Enders, T.; Delgado, A. Dynamic neural networks as a tool for the online optimization of industrial fermentation. Bioprocess Biosyst. Eng. 2002, 24, 347–354. [Google Scholar] [CrossRef] [Scilit]
- Assidjo, E.; Kouassi, B.Y.; Amane, D.; Ado, G.; Azzaro-Pantel, C.; Davin, A. Industrial Brewery Modelling by Using Artificial Neural Network. J. Appl. Sci. 2006, 6, 1858–1862. [Google Scholar] [CrossRef] [Scilit]
- O’Brien, A.; Zhang, H.; Allwood, D.; Rawsthorne, A. From Data to Draught: Modelling and Predicting Mixed-Culture Beer Fermentation Dynamics Using Autoregressive Recurrent Neural Networks. Modelling 2024, 5, 201–222. [Google Scholar] [CrossRef] [Scilit]
- O’Brien, A.; Zhang, H.; Allwood, D. Neural Brewmeister: Modelling Beer Fermentation Dynamics Using LSTM Networks. Processes 2026, 14, 233. [Google Scholar] [CrossRef] [Scilit]
- Sipos, A.; Florea, A.; Arsin, M.; Fiore, U. Using Neural Networks to Obtain Indirect Information about the State Variables in an Alcoholic Fermentation Process. Processes 2021, 9, 74. [Google Scholar] [CrossRef] [Scilit]
- Bowler, A.L.; Escrig, J.; Pound, M.; Watson, N.J. Predicting Alcohol Concentration during Beer Fermentation Using Ultrasonic Measurements and Machine Learning. Fermentation 2021, 7, 34. [Google Scholar] [CrossRef] [Scilit]
- Bowler, A.L.; Pound, M.; Watson, N.J. Domain Adaptation and Federated Learning for Ultrasonic Monitoring of Beer Fermentation. Fermentation 2021, 7, 253. [Google Scholar] [CrossRef] [Scilit]
- García, A.I.; García, L.A.; Díaz, M. Prediction of ester production in industrial beer fermentation. Enzym. Microb. Technol. 1994, 16, 66–71. [Google Scholar] [CrossRef] [Scilit]
- Riverol, C.; Cooney, J. Estimation of the ester formation during beer fermentation using neural networks. J. Food Eng. 2007, 82, 585–588. [Google Scholar] [CrossRef] [Scilit]
- Zhang, Y.; Jia, S.; Zhang, W. Predicting acetic acid content in the final beer using neural networks and support vector machine. J. Inst. Brew. 2012, 118, 361–367. [Google Scholar] [CrossRef] [Scilit]
- Mileva, S.; Vassileva, S. ANN-based Prediction of Antioxidant Characterizations during the Brewery Fermentation. In Proceedings of the International Scientific Conference Computer Science’2008, Kavala, Greece, 17–20 September 2008. [Google Scholar]
- Trelea, I.C.; Titica, M.; Corrieu, G. Dynamic optimisation of the aroma production in brewing fermentation. J. Process Control 2004, 14, 1–16. [Google Scholar] [CrossRef] [Scilit]
- Gonzalez Viejo, C.; Fuentes, S.; Torrico, D.; Lee, M.H.; Hu, Y.Q.; Chakraborty, S.; Dunshea, F.R. The Effect of Soundwaves on Foamability Properties and Sensory of Beers with a Machine Learning Modeling Approach. Beverages 2018, 4, 53. [Google Scholar] [CrossRef] [Scilit]
- Giovenzana, V.; Beghi, R.; Guidetti, R. Rapid evaluation of craft beer quality during fermentation process by vis/NIR spectroscopy. J. Food Eng. 2014, 142, 80–86. [Google Scholar] [CrossRef] [Scilit]
- França, L.; Grassi, S.; Pimentel, M.F.; Amigo, J.M. A single model to monitor multistep craft beer manufacturing using near infrared spectroscopy and chemometrics. Food Bioprod. Process. 2021, 126, 95–103. [Google Scholar] [CrossRef] [Scilit]
- Reid, S.J.; Josey, M.; MacIntosh, A.J.; Maskell, D.L.; Speers, R.A. Predicting Fermentation Rates in Ale, Lager and Whisky. Fermentation 2021, 7, 13. [Google Scholar] [CrossRef] [Scilit]
- de Andrés-Toro, B.; Girón-Sierra, J.M.; López Orozco, J.A.; Fernández Conde, C.J. Optimization of a Batch Fermentation Process by Genetic Algorithms. Proc. IFAC Proc. Vol. 1997, 30(30), 179–184. [Google Scholar] [CrossRef] [Scilit]
- Whitnell, G.P.; Davidson, V.J.; Brown, R.B.; Hayward, G.L. Fuzzy predictor for fermentation time in a commercial brewery. Comput. Chem. Eng. 1993, 17, 1025–1029. [Google Scholar] [CrossRef] [Scilit]
- O’Connor, B.; Riverol, C.; Kelleher, P.; Plant, N.; Bevan, R.; Hinchy, E.; D’Arcy, J. Integration of fuzzy logic based control procedures in brewing. Food Control 2002, 13, 23–31. [Google Scholar] [CrossRef] [Scilit]
- Kurz, T.; Fellner, M.; Becker, T.; Delgado, A. Observation and Control of the Beer Fermentation Using Cognitive Methods. J. Inst. Brew. 2001, 107, 241–252. [Google Scholar] [CrossRef] [Scilit]
- Speers, R.A.; Rogers, P.J.; Smith, B. Non-Linear Modelling of Industrial Brewing Fermentations. J. Inst. Brew. 2003, 109, 229–235. [Google Scholar] [CrossRef] [Scilit]
- Defernez, M.; Foxall, R.J.; O’Malley, C.J.; Montague, G.A.; Ring, S.M.; Kemsley, E.K. Modelling beer fermentation variability. J. Food Eng. 2007, 83, 167–172. [Google Scholar] [CrossRef] [Scilit]
- Zamudio Lara, J.M.; Dewasme, L.; Hernández-Escoto, H.; Vande Wouwer, A. Parameter Estimation of Dynamic Beer Fermentation Models. Foods 2022, 11, 3602. [Google Scholar] [CrossRef] [Scilit]
- Awryńczuk, M. Online set-point optimisation cooperating with predictive control of a yeast fermentation process: A neural network approach. Eng. Appl. Artif. Intell. 2011, 24, 968–982. [Google Scholar] [CrossRef] [Scilit]
- Malyar, A.; Vihuro, M.; Misiurenko, V. Computer vision algorithm for identifying main beer fermentation stages. Przegląd Elektrotechniczny 2025, 196–202. [Google Scholar] [CrossRef] [Scilit]
- Dietler, N.; Minder, M.; Gligorovski, V.; Economou, A.M.; Joly, D.A.H.L.; Sadeghi, A.; Chan, C.H.M.; Koziński, M.; Weigert, M.; Bitbol, A.F.; et al. A convolutional neural network segments yeast microscopy images with high accuracy. Nat. Commun. 2020, 11, 1–8. [Google Scholar] [CrossRef] [Scilit]
- Howard, D.A.; Ma, Z.; Engvang, J.A.; Hagenau, M.; Jørgensen, K.L.; Olesen, J.F.; Jørgensen, B.N. Optimization of Energy Flexibility in Cooling Process for Brewery Fermentation with Multi-Agent Simulation. In Proceedings of the SAMCON2020—The 6th IEEJ International Workshop on Sensing, Actuation, Motion Control, and Optimization, Tokyo, Japan, 14–16 March 2020. [Google Scholar]
- Howard, D.A.; Ma, Z.; Engvang, J.A.; Hagenau, M.; Jørgensen, K.L.; Olesen, J.F.; Jørgensen, B.N. Energy Flexibility Potential in the Brewery Sector: A Multi-agent Based Simulation of 239 Danish Breweries. In Proceedings of the 2022 IEEE PES 14th Asia-Pacific Power and Energy Engineering Conference (APPEEC), Melbourne, Australia, 20–23 November 2022. [Google Scholar] [CrossRef] [Scilit]
- Duan, F.; Wang, Y.N.; Liu, H.J.; Tan, W. Empty bottle inspector based on machine vision. In Proceedings of the Proceedings of 2004 International Conference on Machine Learning and Cybernetics (IEEE Cat. No.04EX826), Shanghai, China, 26–29 August 2004. [Google Scholar] [CrossRef] [Scilit]
- Duan, F.; Wang, Y.; Liu, H.J.; Li, Y.G. A machine vision inspector for beer bottle. Eng. Appl. Artif. Intell. 2007, 20, 1013–1021. [Google Scholar] [CrossRef] [Scilit]
- Huang, B.; Ma, S.; Wang, P.; Wang, H.; Yang, J.; Guo, X.; Zhang, W.; Wang, H. Research and implementation of machine vision technologies for empty bottle inspection systems. Eng. Sci. Technol. Int. J. 2018, 21, 159–169. [Google Scholar] [CrossRef] [Scilit]
- Yazdi, L.; Prabuwono, A.S.; Golkar, E. Feature extraction algorithm for fill level and cap inspection in bottling machine. In Proceedings of the 2011 International Conference on Pattern Analysis and Intelligence Robotics, Kuala Lumpur, Malaysia, 28–29 June 2011. [Google Scholar] [CrossRef] [Scilit]
- Musić, J.; Stančić, I.; Džaja, B.; Pekić, V. Image-Based Sensor for Liquid Level Monitoring during Bottling with Application to Craft and Home-Brewing. Sensors 2023, 23, 7126. [Google Scholar] [CrossRef] [Scilit]
- Campos, M.; Ferreira, M.; Martins, T.; Santos, C. Inspection of bottles crates in the beer industry through computer vision. In Proceedings of the IECON 2010—36th Annual Conference on IEEE Industrial Electronics Society, Glendale, AZ, USA, 7–10 November 2010. [Google Scholar] [CrossRef] [Scilit]
- Liang, Q.; Xiang, S.; Long, J.; Zhang, D.; Coppola, G.; Sun, W.; Wang, Y. Automatic defect inspection system for beer bottles based on deep residual learning. Int. J. Comput. Vis. Robot. 2021, 11, 299. [Google Scholar] [CrossRef] [Scilit]
- Remmelzwaal, L. Object Detection and Tracking for Crate and Bottle Identification in a Bottling Plant Using Deep Learning. Artif. Intell. Appl. 2023, 1, 175–179. [Google Scholar] [CrossRef]
- Hohlfeld, P.; Ostermeier, T.; Brandl, D. Classification of Beer Bottles using Object Detection and Transfer Learning. arXiv 2022, arXiv:2201.03791. [Google Scholar] [CrossRef] [Scilit]
- Harris, N.; Gonzalez Viejo, C.; Zhang, J.; Pang, A.; Hernandez-Brenes, C.; Fuentes, S. Enhancing beer authentication, quality, and control assessment using non-invasive spectroscopy through bottle and machine learning modeling. J. Food Sci. 2025, 90, e17670. [Google Scholar] [CrossRef] [Scilit]
- da Costa, N.L.; da Costa, M.S.; Barbosa, R. A Review on the Application of Chemometrics and Machine Learning Algorithms to Evaluate Beer Authentication. Food Anal. Methods 2020, 14, 136–155. [Google Scholar] [CrossRef] [Scilit]
- Lukinac, J.; Mastanjević, K.; Mastanjević, K.; Nakov, G.; Jukić, M. Computer vision method in beer quality evaluation—A review. Beverages 2019, 5, 38. [Google Scholar] [CrossRef] [Scilit]
- Gonzalez Viejo, C.; Torrico, D.; Dunshea, F.R.; Fuentes, S. Emerging Technologies Based on Artificial Intelligence to Assess the Quality and Consumer Preference of Beverages. Beverages 2019, 5, 62. [Google Scholar] [CrossRef] [Scilit]
- Gardner, J.W.; Pearce, T.C.; Friel, S.; Bartlett, P.N.; Blair, N. A multisensor system for beer flavour monitoring using an array of conducting polymers and predictive classifiers. Sens. Actuators B Chem. 1994, 18, 240–243. [Google Scholar] [CrossRef] [Scilit]
- Ciosek, P.; Wróblewski, W. The recognition of beer with flow-through sensor array based on miniaturized solid-state electrodes. Talanta 2006, 69, 1156–1161. [Google Scholar] [CrossRef] [Scilit]
- Pornpanomchai, C.; Suthamsmai, N. Beer classification by electronic nose. In Proceedings of the 2008 International Conference on Wavelet Analysis and Pattern Recognition, Hong Kong, China, 30–31 August 2008. [Google Scholar] [CrossRef] [Scilit]
- Ghasemi-Varnamkhasti, M.; Mohtasebi, S.S.; Siadat, M.; Lozano, J.R.; Ahmadi, H.; Razavi, S.H.; Dicko, A. Aging fingerprint characterization of beer using electronic nose. Sens. Actuators B Chem. 2011, 159, 51–59. [Google Scholar] [CrossRef] [Scilit]
- Ghasemi-Varnamkhasti, M.; Mohtasebi, S.S.; Siadat, M.; Ahmadi, H.; Razavi, S.H. From simple classification methods to machine learning for the binary discrimination of beers using electronic nose data. Eng. Agric. Environ. Food 2015, 8, 44–51. [Google Scholar] [CrossRef] [Scilit]
- Siadat, M.; Losson, E.; Ghasemi-Varnamkhasti, M.; Mohtasebi, S.S. Application of electronic nose to beer recognition using supervised artificial neural networks. In Proceedings of the 2014 International Conference on Control, Decision and Information Technologies (CoDIT), Metz, France, 3–5 November 2014. [Google Scholar] [CrossRef] [Scilit]
- Santos, J.P.; Lozano, J.R. Real time detection of beer defects with a hand held electronic nose. In Proceedings of the 2015 10th Spanish Conference on Electron Devices (CDE), Aranjuez-Madrid, Spain, 11–13 February 2015. [Google Scholar] [CrossRef] [Scilit]
- Santos, J.P.; Lozano, J.; Aleixandre, M. Electronic Noses Applications in Beer Technology. In Brewing Technology; Kanauchi, M., Ed.; IntechOpen: London, UK, 2017. [Google Scholar] [CrossRef] [Scilit]
- Voss, H.G.J.; Mendes Júnior, J.J.A.; Farinelli, M.E.; Stevan, S.L., Jr. A Prototype to Detect the Alcohol Content of Beers Based on an Electronic Nose. Sensors 2019, 19, 2646. [Google Scholar] [CrossRef] [Scilit]
- Liboà, A.; Genzardi, D.; Núñez-Carmona, E.; Carabetta, S.; Di Sanzo, R.; Russo, M.; Sberveglieri, V. Different Diacetyl Perception Detected through MOX Sensors in Real-Time Analysis of Beer Samples. Chemosensors 2023, 11, 147. [Google Scholar] [CrossRef] [Scilit]
- Men, H.; Shi, Y.; Jiao, Y.; Gong, F.; Liu, J. Electronic nose sensors data feature mining: A synergetic strategy for the classification of beer. Anal. Methods 2018, 17, 2016–2025. [Google Scholar] [CrossRef] [Scilit]
- Nimsuk, N. Improvement of accuracy in beer classification using transient features for electronic nose technology. J. Food Meas. Charact. 2019, 13, 656–662. [Google Scholar] [CrossRef] [Scilit]
- Men, H.; Shi, Y.; Fu, S.; Jiao, Y.; Qiao, Y.; Liu, J. Mining Feature of Data Fusion in the Classification of Beer Flavor Information Using E-Tongue and E-Nose. Sensors 2017, 17, 1656. [Google Scholar] [CrossRef] [Scilit]
- Iñón, F.A.; Garrigues, S.; de la Guardia, M. Combination of mid- and near-infrared spectroscopy for the determination of the quality properties of beers. Anal. Chim. Acta 2006, 571, 167–174. [Google Scholar] [CrossRef] [Scilit]
- de Oliveira, H.C.; da Cunha Filho, J.C.E.; Rocha, J.C.; Fernández Núñez, E.G. Rapid monitoring of beer-quality attributes based on UV-Vis spectral data. Int. J. Food Prop. 2017, 20, 1686–1699. [Google Scholar] [CrossRef] [Scilit]
- Gordon, R.; Chapman, J.; Power, A.; Chandra, S.; Roberts, J.; Cozzolino, D. Unfrazzled by Fizziness: Identification of Beers Using Attenuated Total Reflectance Mid-infrared Spectroscopy and Multivariate Analysis. Food Anal. Methods 2018, 11, 2360–2367. [Google Scholar] [CrossRef] [Scilit]
- Sikorska, E.; Chmielewski, J.; Górecki, T.; Khmelinskii, I.; Sikorski, M.; De Keukeleire, D. Discrimination of Beer Flavours by Analysis of Volatiles Using the Mass Spectrometer as an Electronic Nose. J. Inst. Brew. 2007, 113, 110–116. [Google Scholar] [CrossRef] [Scilit]
- Mattarucchi, E.; Stocchero, M.; Moreno-Rojas, J.M.; Giordano, G.; Reniero, F.; Guillou, C. Authentication of Trappist Beers by LC-MS Fingerprints and Multivariate Data Analysis. J. Agric. Food Chem. 2010, 58, 12089–12095. [Google Scholar] [CrossRef] [Scilit]
- Fengxia, S.; Yuwen, C.; Zhanming, Z.; Yifeng, Y. Determination of Beer Color Using Image Analysis. J. Am. Soc. Brew. Chem. 2004, 62, 163–167. [Google Scholar] [CrossRef] [Scilit]
- Hepworth, N.J.; Hammond, J.R.; Varley, J. Novel application of computer vision to determine bubble size distributions in beer. J. Food Eng. 2004, 61, 119–124. [Google Scholar] [CrossRef] [Scilit]
- Silva, T.C.O.; Godinho, M.S.; de Oliveira, A.E. Identification of pale lager beers via image analysis. Lat. Am. Appl. Res. 2011, 41, 141–145. [Google Scholar]
- Cimini, A.; Pallottino, F.; Menesatti, P.; Moresi, M. A Low-Cost Image Analysis System to Upgrade the Rudin Beer Foam Head Retention Meter. Food Bioprocess Technol. 2016, 9, 1587–1597. [Google Scholar] [CrossRef] [Scilit]
- Gabrova, R.; Ganchovska, V.; Andreeva, H.; Danev, A. Determination of the Change in Volume and Stability of Beer Foam by Digital Image Processing. J. Hyg. Eng. Des. 2021, 37, 20. [Google Scholar]
- Nyarko, E.K.; Glavaš, H.; Habschied, K.; Mastanjević, K. Determination of Foam Stability in Lager Beers Using Digital Image Analysis of Images Obtained Using RGB and 3D Cameras. Fermentation 2021, 7, 46. [Google Scholar] [CrossRef] [Scilit]
- de Sousa Dutra, J.V.; Salles, M.O.; Michel, R.C.; Vale, D.L. Computer vision with artificial intelligence for a fast, low-cost, eco-friendly and accurate prediction of beer styles and brands. Anal. Methods 2024, 26, 4285–4290. [Google Scholar] [CrossRef] [Scilit]
- Pérez-Calabuig, A.M.; Pradana-López, S.; Cancilla, J.C.; López-Ortega, S.; Torrecilla, J.S. AI-powered computer vision for detecting gluten in gluten-free beer. Food Control 2026, 179, 111557. [Google Scholar] [CrossRef] [Scilit]
- Rewak, K.; Zygadło, K.; Jackowski, M. A Multi-Attribute Dataset of Commercial Bottles; Zenodo: Genève, Switzerland, 2026. [Google Scholar] [CrossRef]
- Gonzalez Viejo, C.; Fuentes, S.; Li, G.; Collmann, R.; Condé, B.; Torrico, D. Development of a robotic pourer constructed with ubiquitous materials, open hardware and sensors to assess beer foam quality using computer vision and pattern recognition algorithms: RoboBEER. Food Res. Int. 2016, 89, 504–513. [Google Scholar] [CrossRef] [Scilit]
- Gonzalez Viejo, C.; Fuentes, S.; Torrico, D.; Howell, K.; Dunshea, F.R. Assessment of beer quality based on foamability and chemical composition using computer vision algorithms, near infrared spectroscopy and machine learning algorithms. J. Sci. Food Agric. 2017, 98, 618–627. [Google Scholar] [CrossRef] [Scilit]
- Gonzalez Viejo, C.; Fuentes, S.; Torrico, D.; Howell, K.; Dunshea, F.R. Assessment of Beer Quality Based on a Robotic Pourer, Computer Vision, and Machine Learning Algorithms Using Commercial Beers. J. Food Sci. 2018, 83, 1381–1388. [Google Scholar] [CrossRef] [Scilit]
- Gonzalez Viejo, C.; Fuentes, S.; Howell, K.; Torrico, D.; Dunshea, F.R. Robotics and computer vision techniques combined with non-invasive consumer biometrics to assess quality traits from beer foamability using machine learning: A potential for artificial intelligence applications. Food Control 2018, 92, 72–79. [Google Scholar] [CrossRef] [Scilit]
- Gonzalez Viejo, C.; Torrico, D.; Dunshea, F.R.; Fuentes, S. Development of Artificial Neural Network Models to Assess Beer Acceptability Based on Sensory Properties Using a Robotic Pourer: A Comparative Model Approach to Achieve an Artificial Intelligence System. Beverages 2019, 5, 33. [Google Scholar] [CrossRef] [Scilit]
- Gonzalez Viejo, C.; Caboche, C.H.; Kerr, E.D.; Pegg, C.L.; Schutz, B.L.; Howell, K.; Fuentes, S. Development of a Rapid Method to Assess Beer Foamability Based on Relative Protein Content Using RoboBEER and Machine Learning Modeling. Beverages 2020, 6, 28. [Google Scholar] [CrossRef] [Scilit]
- Gonzalez Viejo, C.; Fuentes, S.; Godbole, A.; Widdicombe, B.; Unnithan, R.R. Development of a low-cost e-nose to assess aroma profiles: An artificial intelligence application to assess beer quality. Sens. Actuators B Chem. 2020, 308, 127688. [Google Scholar] [CrossRef] [Scilit]
- Gonzalez Viejo, C.; Fuentes, S. Beer Aroma and Quality Traits Assessment Using Artificial Intelligence. Fermentation 2020, 6, 56. [Google Scholar] [CrossRef] [Scilit]
- Gonzalez Viejo, C.; Fuentes, S. Low-Cost Methods to Assess Beer Quality Using Artificial Intelligence Involving Robotics, an Electronic Nose, and Machine Learning. Fermentation 2020, 6, 104. [Google Scholar] [CrossRef] [Scilit]
- Gonzalez Viejo, C.; Fuentes, S.; Hernandez-Brenes, C. Smart Detection of Faults in Beers Using Near-Infrared Spectroscopy, a Low-Cost Electronic Nose and Artificial Intelligence. Fermentation 2021, 7, 117. [Google Scholar] [CrossRef] [Scilit]
- Fuentes, S.; Gonzalez Viejo, C.; Torrico, D.; Dunshea, F.R. Development of a Biosensory Computer Application to Assess Physiological and Emotional Responses from Sensory Panelists. Sensors 2018, 18, 2958. [Google Scholar] [CrossRef] [Scilit]
- Wilson, C.I.; Threapleton, L. Application of artificial intelligence for predicting beer flavours from chemical analysis. In Proceedings of the 29th European Brewery Convention Congress, Dublin, Ireland, 17–22 May 2003. [Google Scholar]
- Tabassum, M.; De Rouck, G.; De Brabanter, K. Predictive modeling using artificial intelligence for sensory panel assessments of customized beer production. Int. J. Gastron. Food Sci. 2025, 42, 101311. [Google Scholar] [CrossRef] [Scilit]
- Pilone, V.; Di Pasquale, A.; Stasi, A. Consumer Preferences for Craft Beer by Means of Artificial Intelligence: Are Italian Producers Doing Well? Beverages 2023, 9, 26. [Google Scholar] [CrossRef] [Scilit]
- Brattin, R.; Ukena, C.; Sexton, R. Predicting brewery customer satisfaction using an artificial neural network. Int. J. Inf. Bus. Manag. 2018, 10, 58–68. [Google Scholar] [CrossRef] [Scilit]
- Al-Rifaie, M.M.; Cavazza, M. Evolutionary Optimisation of Beer Organoleptic Properties: A Simulation Framework. Foods 2022, 11, 351. [Google Scholar] [CrossRef] [Scilit]
- Dębska, B.; Guzowska-Świder, B. Application of artificial neural network in food classification. Anal. Chim. Acta 2011, 705, 283–291. [Google Scholar] [CrossRef] [Scilit]
- Bonatto, D. A new classification system of beer categories and styles based on large-scale data mining and self-organizing maps of beer recipes. Food Humanit. 2026, 6, 101083. [Google Scholar] [CrossRef] [Scilit]
- Gómez Pamies, L.C.; Bianchi, M.A.; Farco, A.P.; Vázquez, R.; Benítez, E.I. Improving craft beer style classification through physicochemical determination and the application of deep learning techniques. Food Sci. Technol. 2024, 44. [Google Scholar] [CrossRef] [Scilit]
- Zhou, X.; Lu, Q.; Chae, D.K. What If LLMs Can Smell: A Prototype. In Proceedings of the Thirty-Fourth International Joint Conference on Artificial Intelligence, Guangzhou, China, 16–22 August 2025. [Google Scholar] [CrossRef] [Scilit]
- Eastment, C.; Jo, J. Effectiveness of Generative AI in Craft Beer Promotional Campaigns for Small Breweries. ICHRIE Res. Rep. 2024, 9, 6. Available online: https://via.library.depaul.edu/ichrie_rr/vol9/iss2/6/ (accessed on 7 September 2026).
- Lu, Y.; Young, S. A Survey of Public Datasets for Computer Vision Tasks in Precision Agriculture. Comput. Electron. Agric. 2020, 178. [Google Scholar] [CrossRef] [Scilit]
- Cortez, P.; Cerdeira, A.; Almeida, F.; Matos, T.; Reis, J. Modeling wine preferences by data mining from physicochemical properties. Decis. Support Syst. 2009, 47, 547–553. [Google Scholar] [CrossRef] [Scilit]
- Postigo, V.; Mauro, L.; Diaz, T.; Saiz, R.; Arroyo, T.; García, M. Autochthonous Ingredients for Craft Beer Production. Fermentation 2024, 10, 225. [Google Scholar] [CrossRef] [Scilit]
- Klimczak, K.; Cioch-Skoneczny, M.; Poreda, A.; Ciosek, A. Evaluation of commercial yeast strains to produce reduced-alcohol beer. Eur. Food Res. Technol. 2025, 251, 3965–3979. [Google Scholar] [CrossRef] [Scilit]
- McCabe, A.K.; Keyes, J.K.; Hemetsberger, H.; Kurr, C.V.; Albright, B.; Ward, M.G.; McKinley, M.L.; Breezley, S.J.; Cole, C.A. Aroma Profile Development in Beer Fermented with Azacca, Idaho-7, and Sultana Hops. Molecules 2023, 28, 5802. [Google Scholar] [CrossRef] [Scilit]
- Modzelewska, A.; Jackowski, M.; Trusek, A. Physical, Chemical, and Enzymatic Pretreatment of Spent Hops and Its Impact on Xanthohumol Extraction Yield. Molecules 2025, 30, 2200. [Google Scholar] [CrossRef] [Scilit]
- Guido, L.F.; Ferreira, I.M. The Role of Malt on Beer Flavour Stability. Fermentation 2023, 9, 464. [Google Scholar] [CrossRef] [Scilit]
- Tocci, N.; Riccio, G.M.; Ramu Ganesan, A.; Hoellrigl, P.; Robatscher, P.; Conterno, L. The Impact of Rye and Barley Malt and Different Strains of Saccharomyces cerevisiae on Beer Volatilome. Beverages 2023, 9, 93. [Google Scholar] [CrossRef] [Scilit]
- Thompson-Witrick, K.A.; Yuabov, D.; Rose, L.; Crosco, K.; Verespie, R.; Ferguson, L.; Bell, L.; Budner, D. Investigation of Millet-Based Beer Fermentation and the Volatile Compounds Formed. Beverages 2026, 12, 37. [Google Scholar] [CrossRef] [Scilit]
- Satora, P.; Pater, A. The Influence of Different Non-Conventional Yeasts on the Odour-Active Compounds of Produced Beers. Appl. Sci. 2023, 13, 2872. [Google Scholar] [CrossRef] [Scilit]
- Şutea, C.M.; Mudura, E.; Pop, C.R.; Salanţă, L.C.; Fărcaş, A.C.; Balaş, P.C.; Gal, E.; Geană, E.I.; Zhao, H.; Coldea, T.E. Beer Aroma Compounds: Key Odorants, Off-Flavour Compounds and Improvement Proposals. Foods 2025, 14, 4287. [Google Scholar] [CrossRef] [Scilit]
- Meza-Márquez, O.G.; Rodríguez-Híjar, A.R.; Gallardo-Velázquez, T.; Osorio-Revilla, G.; Ramos-Monroy, O.A. The Prediction of Quality Parameters of Craft Beer with FT-MIR and Chemometrics. Foods 2024, 13, 1157. [Google Scholar] [CrossRef] [Scilit]
- Rewak, K. Ai4brewing: Bibliographic Corpus of AI Applications in Beer Brewing; Zenodo: Genève, Switzerland, 2026. [Google Scholar] [CrossRef]
Авторы: Krzysztof Rewak, Karol Zygadło, Mateusz Jackowski