


Представьте мир, где камеры видеонаблюдения на заводе не просто записывают терабайты «слепого» видео, а моментально замечают микротрещину на детали размером с волосок и пишут инженеру отчет: «Внимание, партия №42 повреждена из-за износа пресса». Представьте ИИ-ассистента врача, который изучает МРТ-снимок, сопоставляет его с многолетней историей болезни пациента и выдает готовый план лечения.
Это не фантастика из книг Филипа Дика — это реальность, которую прямо сейчас создают модели компьютерного зрения и естественного языка (Vision-Language Models, или VLM).
Долгое время искусственный интеллект развивался в строгой изоляции: «глаза» машин (компьютерное зрение) были отделены от их «речи» (обработки текста). Но эволюция ИИ привела нас к переломному моменту — мультимодальности. Современные VLM способны не просто «видеть» пиксели или «читать» символы, они понимают контекст их взаимодействия, соединяя визуальный мир с человеческим языком.
Чтобы понять, какой колоссальный прыжок совершила индустрия, нужно вернуться на несколько десятилетий назад. Эволюция систем ИИ прошла три ключевых этапа:
- Эпоха жестких алгоритмов и классического Computer Vision (1960-е – 2010-е):
Ранние системы компьютерного зрения опирались на жестко прописанные правила, математические фильтры и поиск базовых геометрических контуров (линий, углов). Машина могла распознать белый круг на черном фоне, но малейшее изменение освещения или угла обзора вводило алгоритм в ступор. О понимании семантики (смысла) изображения не шло и речи. - Эра глубокого обучения и специализированных моделей (2010-е – 2020-е):
Появление сверточных нейросетей (CNN), таких как AlexNet и ResNet, совершило революцию. Нейросети научились с высокой точностью классифицировать объекты (например, отличать кошку от собаки) и находить их на фото (Object Detection). Параллельно с этим в текстовом мире (NLP) зародилась архитектура Transformer, породившая мощные языковые модели (LLM). Однако эти миры существовали параллельно: текстовые модели были «слепыми», а визуальные — «немыми». - Эра мультимодального ИИ и VLM (с 2021 года по настоящее время):
Настоящий прорыв случился, когда исследователи объединили зрение и текст в рамках единого семантического пространства. Появление таких моделей, как CLIP от OpenAI (2021), показало: ИИ может обучаться на парах «изображение-текст» из интернета, связывая визуальные образы с их языковым описанием. Сегодняшние архитектуры (например, GPT-4o, Claude 3.5 Sonnet, LLaVA, Gemini) перешагнули этот рубеж. Они способны поддерживать сложный диалог о загруженном изображении, находить логические ошибки на схемах, считывать текст с рукописных документов и генерировать программный код на основе веб-дизайна.
Бизнес быстро осознал: способность ИИ «видеть и понимать» — это ключ к автоматизации процессов, которые раньше требовали исключительно человеческого контроля. Технология VLM превратилась из академического эксперимента в один из главных драйверов цифровой трансформации во всех ключевых отраслях мировой экономики.
Большинство корпоративных систем искусственного интеллекта по-прежнему обрабатывают только один элемент за раз. Языковая модель читает текст. Модель компьютерного зрения классифицирует изображения. Задача языковых моделей компьютерного зрения — заставить их работать вместе, чтобы единая система могла анализировать изображение, читать окружающий его текст и делать выводы на основе и того, и другого.
Они принимают изображение и текст в качестве совместного входного сигнала и обрабатывают их. Та же система, которая считывает ваш запрос, интерпретирует содержимое изображения и связывает их. Практическая область применения широка: обработка документов, автоматизация каталогов продукции, сортировка медицинских изображений, промышленный контроль качества. Варианты использования проверены. Трудности возникают при запуске надежной системы в производство, что является наиболее распространенной проблемой в большинстве проектов.
Именно это и рассматривается в данном руководстве, основанном на опыте нашей компании в разработке систем компьютерного зрения и LLM для производителей, розничных продавцов и компаний финансового сектора по всему миру.
Основные выводы
- VLM — это не более совершенная LLM. Это другая архитектура для другого класса задач: рабочих процессов, где смысл заключен в визуальном слое.
- Три компонента, обеспечивающие работу VLM (кодировщик изображений, кросс-модальный коннектор и языковая платформа), также являются тремя местами, где система дает сбои в процессе эксплуатации.
- В большинстве проектов VLM неудача возникает не на этапе выбора модели. Проблемы возникают на этапах подготовки данных, определения задержки и мониторинга — решениях, принимаемых до выбора какой-либо модели.
- Показатели производительности (бенчмарки) измеряют эффективность на общедоступных наборах данных. Они практически ничего не говорят о том, как модель работает на ваших документах, типах дефектов или изображениях вашей продукции.
- Тонкая настройка — не отправная точка. Оперативное проектирование и RAG решают большинство задач адаптации предметной области без использования размеченного набора данных. Начните с этого.
- Выбор между открытым исходным кодом и API — это вопрос соответствия нормативным требованиям и стоимости. В регулируемых отраслях зачастую вообще нельзя использовать внешние API в производственной среде.
- VLA расширяют возможности VLM за счет вывода результатов действий. Актуально для робототехники и автономных систем. Не подходит для большинства современных корпоративных программных приложений.
- Модели VLM, работающие на этапе тестирования, будут ухудшаться в производственной среде без мониторинга. Выявление дрейфа выходных данных является критически важной частью инфраструктуры.
Что такое языковые модели компьютерного зрения?
Языковая модель компьютерного зрения (VLM) — это система искусственного интеллекта, которая принимает изображения и текст в качестве совместного входного сигнала и выдает текстовый результат. В отличие от стандартной языковой модели, которая обрабатывает только текст, или модели компьютерного зрения, которая классифицирует визуальный контент без языкового анализа, VLM делает и то, и другое одновременно. Она может одновременно анализировать изображение, считывать связанный с ним текст и рассуждать на основе обоих данных.

Ни одна из систем не справляется с этими задачами в одиночку. Для счета-фактуры, в котором рукописная аннотация противоречит печатному изображению, требуется модель, способная считывать и то, и другое. Изображение с заводской проверки, где дефект необходимо описать, классифицировать и передать в техническое обслуживание, требует языкового анализа в дополнение к визуальному восприятию. Каталог продукции с 400 000 изображений требует генерации структурированных тегов со скоростью, недостижимой для любой команды экспертов: стандартные корпоративные рабочие процессы, все до единого. К 2027 году 40% решений на основе генеративного ИИ будут многомодальными, по сравнению с 1% в 2023 году. Большая часть корпоративных данных никогда не была чисто текстовой. ИИ, работающий только с текстом, на этом этапе останавливается.
VLM — это стандартное сокращение. Эта категория иногда встречается под более широким названием «мультимодальные модели ИИ», которое охватывает системы, обрабатывающие любые комбинации текста, изображений, аудио и видео. Модели Vision LLM — это подмножество, работающее с изображениями и текстом. На данный момент эта категория обладает наиболее зрелым набором инструментов, самым широким выбором моделей и наибольшим количеством документированных корпоративных внедрений среди всех мультимодальных категорий.
Языковые модели изменили подход предприятий к обработке текста. VLM-модели делают то же самое для всего остального: документов с визуальной структурой, изображений, полученных в ходе проверок, фотографий продукции, медицинских снимков. Если ваши данные не состоят исключительно из текста, обратите внимание на VLM.
Как работают языковые модели зрения
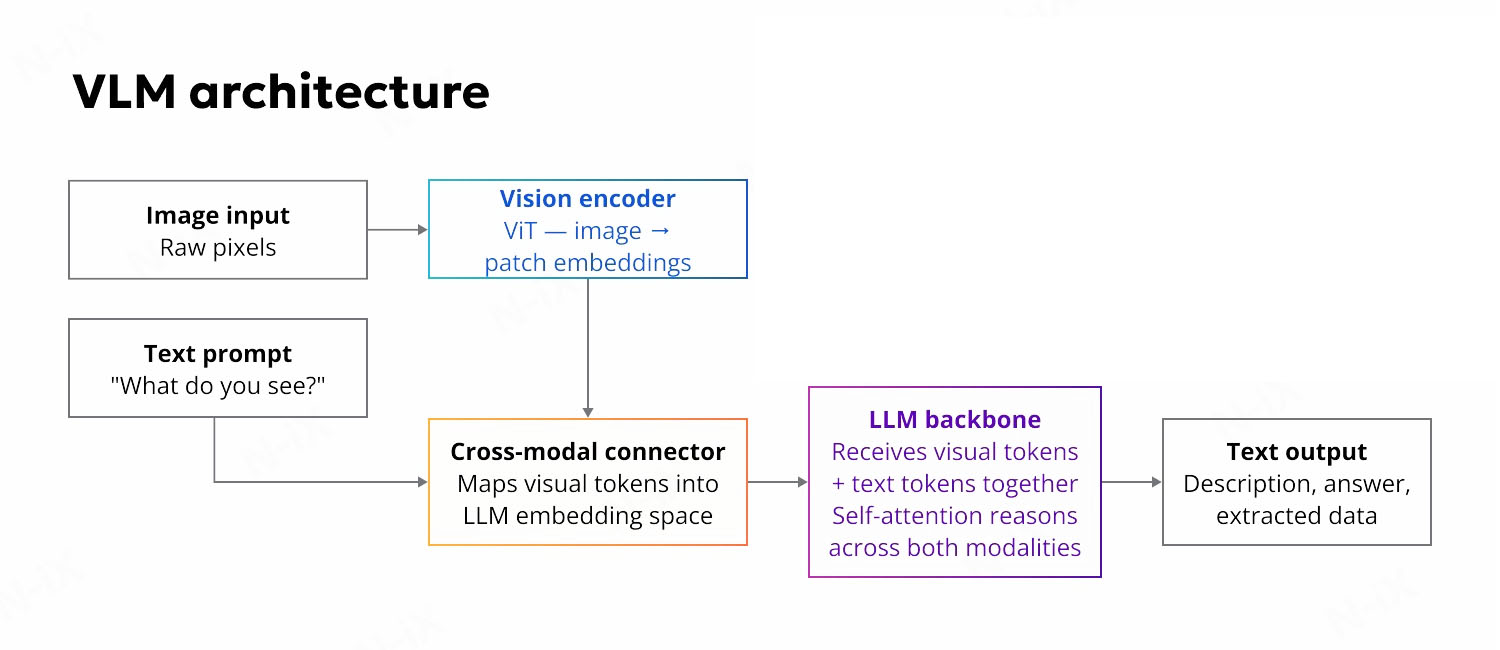
Объяснение языковых моделей обработки изображений: каждая языковая модель обработки изображений работает на одном и том же трехкомпонентном конвейере, и каждая ошибка связана с одним из этих трех мест.
Видеокодировщик
Первым делом используется кодировщик изображения. Он принимает необработанные пиксели изображения и преобразует их в числовые представления, которые может обрабатывать языковая модель. Большинство производственных языковых моделей используют преобразователь изображения (ViT), который делит изображение на фрагменты и обрабатывает их последовательно, подобно тому, как языковая модель читает слова. Некоторые продвинутые реализации обрабатывают изображения в исходном разрешении без изменения размера, что сохраняет мелкие детали, важные в медицинской визуализации и контроле качества в точном производстве. Слабый кодировщик означает, что модель рассуждает на основе неполного изображения, независимо от возможностей базовой архитектуры.
Кросс-модальный соединитель
Межмодальный коннектор располагается между кодировщиком и языковой моделью. Его задача — перевод: отображение визуальных представлений в пространство встраивания языковой модели, чтобы изображения и текст могли обрабатываться вместе. Конструкция коннектора варьируется в зависимости от модели. В более простых реализациях используется слой линейной проекции.
В более сложных системах используются Q-Formers, которые сжимают визуальную информацию в фиксированный набор обучаемых токенов, или слои перекрестного внимания, вплетенные непосредственно в языковую модель. В корпоративных средах коннектор — это место, где происходит большая часть тонкой настройки, специфичной для предметной области. Большинство сбоев в производственной среде начинаются именно здесь: когда визуальное и языковое представления расходятся, модель описывает то, что она ожидает увидеть.
Языковая модель
Основная языковая модель обрабатывает логические рассуждения. Она принимает переведенные визуальные токены вместе с текстовой подсказкой, объединяет их и генерирует ответ. Масштаб и качество обучения основной модели определяют, насколько надежно она обрабатывает многоэтапные рассуждения, неоднозначные входные данные и язык, специфичный для предметной области.
Появился новый класс архитектур, не требующих кодировщика, которые полностью обходят графический кодировщик, передавая необработанные фрагменты изображений непосредственно в языковую модель. Конвейер обработки проще, а задержка ниже, но этим моделям обычно требуется больше обучающих данных для достижения сопоставимого качества визуального анализа.
Как эти компоненты взаимодействуют друг с другом
VLM-системы различаются по способу объединения визуальной и языковой информации, и выбор архитектуры имеет практические последствия для развертывания.
- Модульные мостовые модели разделяют кодировщик машинного зрения и языковую модель, соединяя их через обученный адаптер. Каждый компонент можно обновлять или заменять независимо. Существующие предварительно обученные модели можно использовать повторно, а не обучать с нуля. Это наиболее распространенный шаблон в корпоративных развертываниях и наиболее практичная отправная точка для большинства сценариев использования. Инструменты для тонкой настройки хорошо развиты, а архитектуру легко оценить на данных, специфичных для предметной области, прежде чем принимать окончательное решение.
- Унифицированные однопотоковые модели обрабатывают визуальные и текстовые токены вместе через единый общий преобразователь. Qwen2-VL использует именно такой подход. Архитектура модели обработки изображений и текста естественным образом обрабатывает чередующиеся изображения и текст и хорошо справляется со сложными задачами рассуждения, хотя и требует больших вычислительных ресурсов, чем альтернативные модульные мостовые решения.
- Кодировщики Fusion объединяют текстовые и графические признаки на более ранних этапах, либо с помощью одного общего трансформера, либо с помощью двух трансформеров, которые объединяются посредством перекрестного внимания. Взаимодействие между модальностями становится более глубоким, но обучение и развертывание требуют больших ресурсов.
- Двухканальные кодировщики обрабатывают изображение и текст совершенно раздельно и отображают их в общее пространство встраивания для вычисления показателей сходства. Хорошо подходят для поиска изображений и текста в больших масштабах. Не подходят для понимания документов, визуального контроля качества или задач, требующих сложных рассуждений в обеих модальностях.
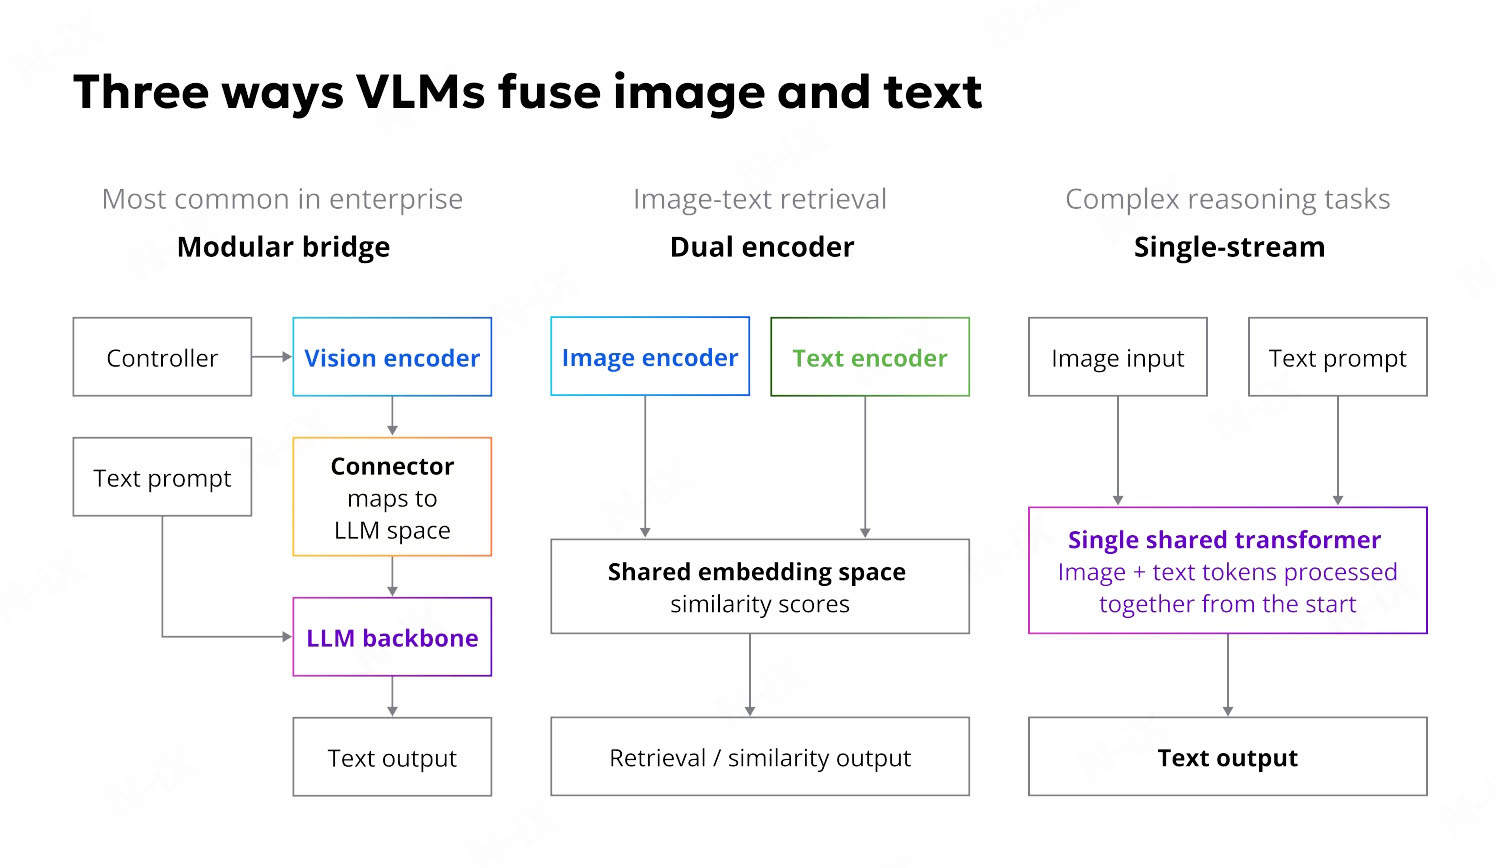

Для большинства корпоративных сценариев выбор архитектуры определяется поставленной задачей. Если требуется поиск — например, извлечение релевантных изображений из большого каталога или сопоставление товаров по визуальному сходству — то правильным отправным пунктом являются двухканальные кодировщики. Если же требуется рассуждение, описание или понимание документов, то модульные мостовые модели — это то, с чего обычно начинают развертывание в производственной среде.
Как обучают виртуальных менеджеров по работе с клиентами.
Модели обработки визуальной информации (VLM) не обучаются с нуля. Обучение начинается с предварительно обученного кодировщика изображений и предварительно обученной языковой модели, с использованием многоэтапного конвейера для обучения их совместной работе. Для корпоративных команд это важно, поскольку структура обучения объясняет большинство сбоев в работе, рассматриваемых далее в этом руководстве.
Этап 1: Согласование модальностей
На первом этапе кодировщик изображений и языковая модель обучаются работе с одними и теми же представлениями. Модель обучается на больших наборах данных пар изображение-текст с использованием трех основных методов:
| Техника | Что это делает | Почему это важно |
| Контрастивное обучение | Обучает модель распознавать, какие изображения и подписи относятся друг к другу, а какие нет. | Создаёт базовую схему сопоставления изображения и текста. |
| Маскированное моделирование | Обучает модель предсказывать скрытые слова на изображении или восстанавливать скрытые области изображения из текста. | Обучает модель рассуждать в различных модальностях. |
| Генеративное обучение | Обучает модель создавать текст на основе визуального ввода и текстового префикса. | Подготавливает модель для открытого описания и ответов на вопросы. |
Эти цели проверяются на миллиардах примеров, прежде чем разовьются какие-либо специфические для данной задачи возможности.
Этап 2: Настройка инструкций
После того как задана базовая согласованность, модель обучается на специально подобранных наборах данных с конкретными подсказками и ожидаемыми ответами, такими как «опишите это изображение», «выявите аномалию» или «извлеките позиции из этого счета-фактуры». Именно это превращает способную, но универсальную модель в модель, которая надежно следует структурированным инструкциям в различных типах задач.
Этап 3: Тонкая настройка для вашего домена
Этот этап наиболее актуален для корпоративных команд. Эффективные с точки зрения параметров методы, такие как LoRA (Low-Rank Adaptation), фиксируют исходные веса модели и вставляют небольшие обучаемые слои, позволяя модели адаптироваться к конкретным областям, таким как форматы документов, типы дефектов и категории продукции.
Три вещи, которые нужно знать перед началом процесса тонкой настройки:
- Требования к вычислительным ресурсам ниже, чем при полном обучении. LoRA работает на гораздо меньшем количестве оборудования, чем требуется для предварительного обучения. Для большинства инженерных групп вполне по силам выполнить детальную настройку модели.
- Требования к качеству данных не снижаются. Плохо размеченные примеры приводят к созданию модели, которая заведомо неверна именно в тех входных данных, которые имеют наибольшее значение.
- Пороговые значения объема имеют значение. Для большинства задач адаптации предметной области практическим минимумом является от 1000 до 5000 высококачественных аннотированных пар изображение-текст. При объеме ниже этого порога стоит в первую очередь исчерпать возможности оперативного проектирования и методов, расширяющих возможности поиска.
Что это означает в производстве
Структура обучения объясняет два типа производственного поведения, с которыми сталкивается большинство команд и которых ни одна из них не ожидает.
Базовое поведение модели VLM отражает распределение данных, использованных для её предварительного обучения. Если ваша предметная область совершенно не похожа на широко распространённые в интернете пары «изображение-текст», на которых обучалась модель, например, специализированная медицинская визуализация или нишевые промышленные компоненты, модель будет плохо обобщать данные, пока не будет доработана на репрезентативных примерах. Разница проявляется не в очевидных ошибках, а в уверенных, правдоподобно звучащих результатах, которые на самом деле являются незначительными.
Галлюцинации в моделях LLM для обработки визуальной информации — это не случайные ошибки. Это когда модель делает именно то, чему её обучали, в ситуации, когда её визуальное представление неполное или распределение обучающих данных не соответствует входным данным. Именно поэтому стандартные тесты точности не выявляют риск галлюцинаций в ваших конкретных данных. Он проявляется только при тестировании модели на примерах, которые она не видела в вашей предметной области.
Модели визуально-языковых действий: что следует за моделями визуально-языковых действий?
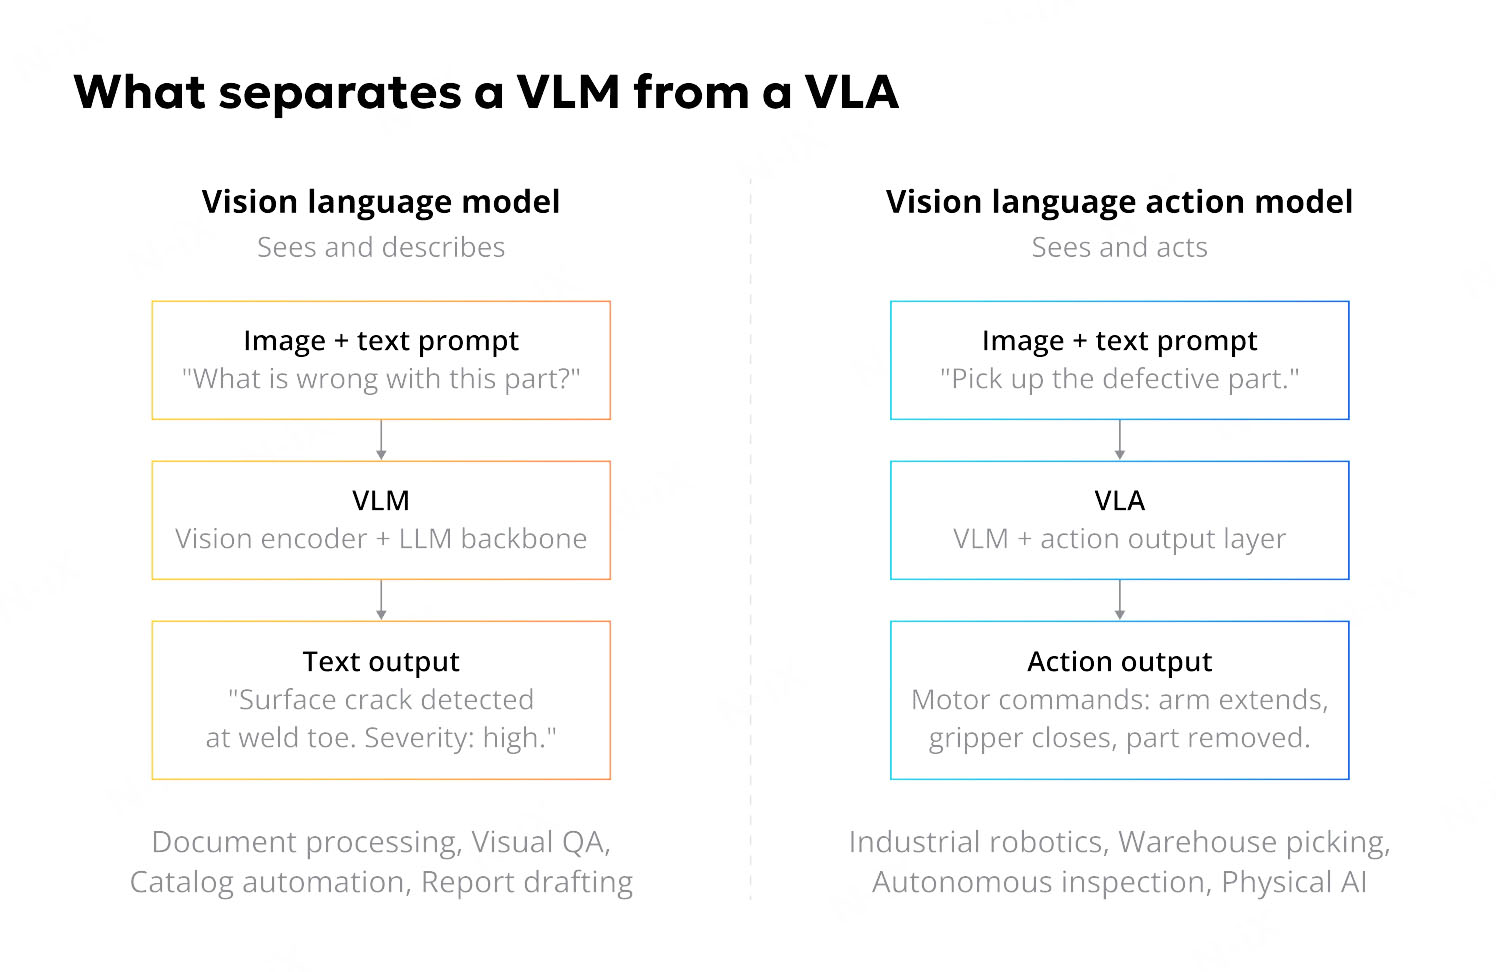
Модель визуального языка и действий (VLM) сообщает вам, что она видит. Модель визуального языка и действий (VLA) реагирует на это.
Архитектура расширяет стандартный конвейер VLM слоем вывода действий. Вместо генерации текстового описания или ответа, модель генерирует команды управления движением, системные вызовы или физические движения на основе своего восприятия. Это система, которая получает инструкции на естественном языке, интерпретирует визуальную среду и выполняет физическую задачу без участия человека на этапе выполнения действия.
Где сегодня развернуты VLA-системы
Наиболее документированные примеры применения — в промышленной робототехнике и автоматизации складских операций.
Первые производственные системы продемонстрировали, что модель, обученная на данных изображений и текста интернет-масштаба, может обобщаться на задачи физического манипулирования, с которыми она никогда явно не сталкивалась во время обучения. С тех пор реализации с открытым исходным кодом используются в структурированных процессах захвата и перемещения, а также контроля качества в ограниченных производственных средах.
Эффективность моделей действий, основанных на визуальном языке, сохраняется в контролируемых условиях: постоянное освещение, ограниченное пространство действий, предсказуемое расположение объектов. Когда эти условия нарушаются, надежность моделирования на основе визуального языка также снижается.

Где используются языковые модели обработки изображений?
Производство: выявление дефектов и составление отчетов о качестве.
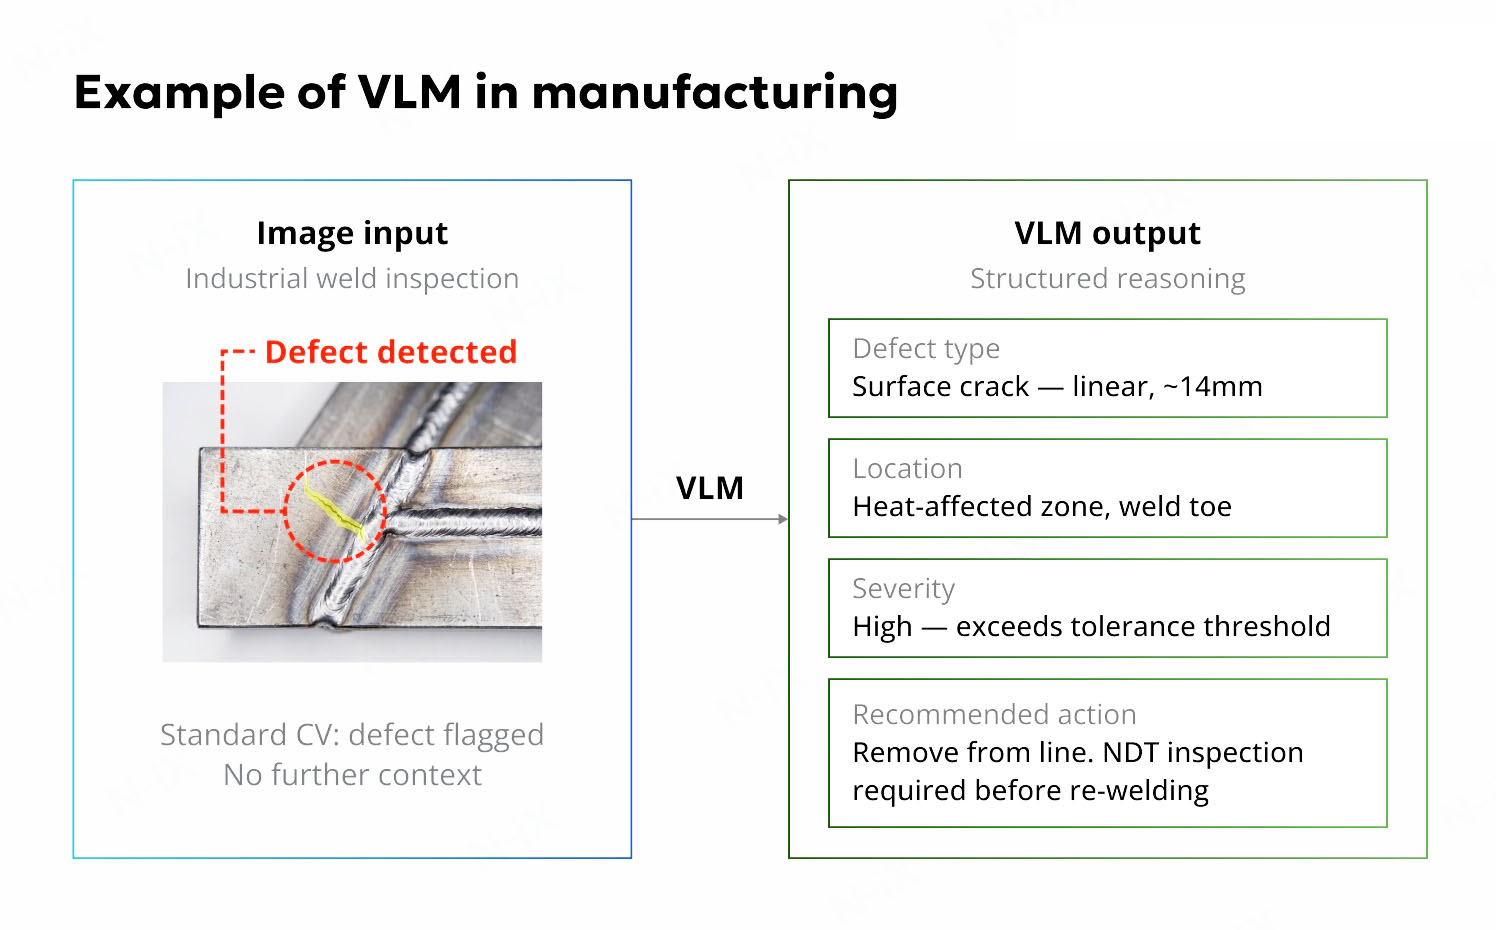
Ручной визуальный осмотр на производственной скорости имеет две недостатки: он медленный по сравнению с производительностью и непоследовательный. Один и тот же дефект классифицируется по-разному разными операторами или полностью пропускается в условиях усталости материала.
Стандартные модели компьютерного зрения решают проблему скорости. Они выявляют аномалии в режиме реального времени. Однако они не предоставляют структурированного описания того, что представляет собой аномалия, где она появляется и что, вероятно, стало ее причиной. Именно этот уровень логического анализа добавляет VLM: описание дефекта, классификация серьезности и предварительное заполнение заявки на техническое обслуживание наряду с результатами обнаружения. Та же логика распространяется и на мониторинг инфраструктуры. Агенты, работающие на основе VLM, анализируют видеозаписи осмотра дорог, объектов и промышленного оборудования, выявляют опасности и генерируют структурированные отчеты о техническом обслуживании с данными о местоположении.

Когда мы разрабатывали системы компьютерного зрения и обработки естественного языка для ведущей европейской инженерной компании, основная проблема заключалась не в обнаружении, а в том, что происходило после. Необходимо было структурировать отчеты о повреждениях, проверять этикетки и сверять документы с данными о грузе. Компьютерное зрение отвечало за визуальный слой; решения на основе обработки естественного языка обрабатывали структурированный вывод и исправляли ошибки после распознавания текста.
Финансовые услуги: обработка документов и проверка личности клиента (KYC).
Финансовые документы сочетают в себе печатные поля, рукописные пометки, печати и структуру макета, которая несет смысл наряду с текстом. OCR извлекает слова, но теряет пространственные связи, определяющие их значение. Цифра в правом верхнем углу формы означает нечто иное, чем та же цифра в ячейке таблицы.
Системы визуального анализа документов (VLM) анализируют документ в целом: оптимальное распознавание символов на нескольких языках , интерпретация визуального макета, извлечение структурированных полей и выявление несоответствий за один проход. Юридические и комплаенс-отделы, обрабатывающие сложные многоязычные контракты, использовали VLM для сокращения времени извлечения пунктов с нескольких дней до нескольких часов. Ранее этот рабочий процесс требовал выделения отдельного времени аналитика на каждый набор документов.
Юридические и комплаенс-отделы используют аналогичные возможности для обработки нормативной документации, журналов аудита, соглашений с поставщиками и любых других наборов документов, где структура и язык имеют одинаковое значение. Логистические подразделения используют виртуальные логистические системы для обработки транспортных накладных, контейнерных форм и PDF-документов, включая сканированные изображения низкого качества. Полученные данные напрямую передаются в нижестоящие системы, исключая ручной ввод данных, на котором постоянно не справляются конвейеры оптического распознавания текста на основе правил.
Главным ограничением при развертывании является суверенитет данных. Большинство финансовых учреждений не могут передавать данные клиентских документов через API сторонних разработчиков без специальных договорных соглашений. В этом секторе стандартным выбором для рабочих процессов с документами являются модели с открытым исходным кодом на частной инфраструктуре. Решение об архитектуре необходимо принять до начала разработки.
Розничная торговля и электронная коммерция: автоматизация каталогов в масштабах предприятия
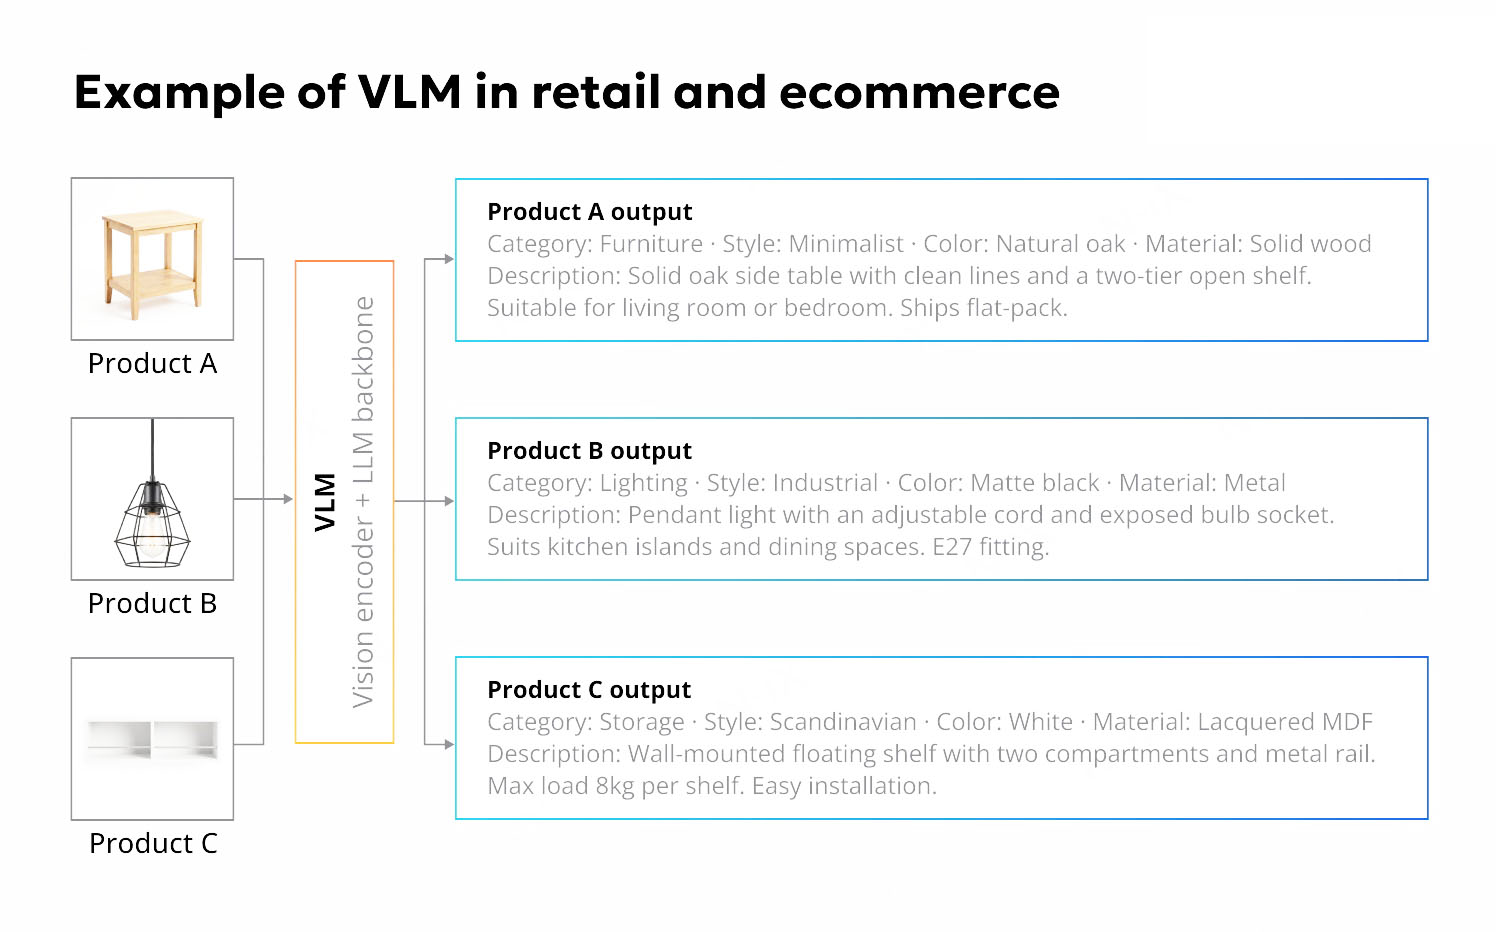
Розничному продавцу с сотнями тысяч товарных позиций необходимы структурированные теги, извлечение атрибутов и черновые описания, генерируемые на основе изображений товаров. Постоянно. С такой скоростью, с которой не справится ни одна команда, занимающаяся проверкой вручную. Обновление по мере изменения запасов.
Системы визуального языкового моделирования (VLM) обрабатывают это пакетно. Имея изображение товара и структурированный шаблон вывода, хорошо настроенная система визуального языкового моделирования генерирует теги, извлекает атрибуты и составляет описания, которые требуют лишь незначительной проверки человеком перед публикацией. Визуальный поиск работает на основе той же возможности: покупатель загружает фотографию и находит визуально похожие товары в каталоге любого размера. Цифровые агенты, построенные на основе VLM, расширяют эти возможности. Они обрабатывают скриншоты для навигации по интерфейсам, заполнения записей в CRM и выполнения административных задач на основе визуального ввода, не преобразуя предварительно изображение в текст.

Медиа- и контент-платформы следуют одной и той же схеме. Когда мы помогли ведущей платформе стоковой фотографии оптимизировать анализ контента и поиск ресурсов, результатом стал поиск ресурсов в 100 раз быстрее, основанный на применении ИИ и машинного обучения для анализа больших объемов изображений . Образовательные платформы применяют это к длинным видеороликам: исследователь или студент запрашивает информацию по концепции и находит точную временную метку, вместо того чтобы вручную просматривать часовую запись. Во всех трех случаях требование одинаково: модель, которая понимает, что содержит изображение или кадр в контексте.
Здравоохранение: сортировка образцов при медицинской визуализации и подготовка отчета.
Рентгенологи и сотрудники лаборатории тратят значительную часть своего времени на документирование и первичный анализ, который не требует от них полного клинического суждения. Vision LLM занимается подготовительным этапом: созданием структурированного отчета на основе исследования изображений, выделением областей интереса и направлением запроса на квалифицированный анализ на основе предварительных результатов.
Процесс проверки человеком не является необязательным. Это требование соответствия. Результат работы VLM в клиническом рабочем процессе — это черновик. Модели общего назначения также хорошо работают на стандартных тестовых наборах данных и плохо — на специализированных, без тонкой настройки под конкретные условия на репрезентативных клинических наборах данных. Уровень валидации в здравоохранении более требователен, чем в любой другой отрасли. Определение масштаба проекта VLM без учета этого фактора — наиболее надежный способ управления сроками и бюджетом подобных проектов.
Такое противоречие хорошо знакомо. Мы работали с поставщиками медицинских технологий над модернизацией данных и инфраструктурой машинного обучения , включая создание конвейеров обработки клинических данных для ведущей компании в области аналитики здравоохранения. В ходе всех проектов наблюдается закономерность: модель редко является ограничивающим фактором. Проблемы с управлением данными, качеством аннотаций и проверкой на соответствие нормативным требованиям — вот где проекты заходят в тупик, и для принятия решения по модели требуется предварительное определение объема работ.
Что на самом деле требуется для развертывания VLM в корпоративной среде
Мы видели достаточно подобных проектов, чтобы знать, где они дают сбой. Редко дело в самой модели. Чаще всего проблема в аудите данных, который не был проведен до начала тонкой настройки. Требование к задержке всплыло только после того, как архитектура была утверждена. Ограничение по соответствию стандартам, которое исключило API через три месяца. Ничто из этого не является неизбежным. Все это предсказуемо, если знать, на что обращать внимание.
Четыре причины провала проектов VLM в производстве.
- Модель описывает свои ожидания . Если входные данные не соответствуют обучающему распределению, используется новый шаблон документа, другой ракурс камеры или тип дефекта, слишком редко встречающийся во время обучения, модель не указывает на неопределенность. Она генерирует уверенный, правдоподобно звучащий результат, который на самом деле неверен. Никакого сообщения об ошибке или сигнала о низкой уверенности. Просто неправильный ответ, представленный с уверенностью.
- Проблемы с данными возникают поздно. Корпоративные архивы изображений созданы для хранения данных. Пробелы в аннотациях, непоследовательная разметка и пропущенные граничные случаи остаются скрытыми до тех пор, пока кто-нибудь не проведет аудит набора данных. Большинство команд делают это через шесть месяцев, после начала тонкой настройки и исчерпания бюджета. Модель обучается на неправильных шаблонах именно тогда, когда изменение курса обходится дороже всего.
- Результаты бенчмарков не переносятся. Визуальные ответы на вопросы (VQA), масштабное междисциплинарное мультимодальное понимание (MMMU) и текстовые VQA оценивают производительность на общедоступных наборах данных, собранных исследователями. Ваши счета-фактуры, категории дефектов и изображения продукции отсутствуют в этих наборах данных. Модель, лидирующая в рейтинге, все еще может показывать худшие результаты, чем более компактная, оптимизированная для конкретной предметной области альтернатива, на ваших конкретных входных данных. Команды, которые пропускают оценку, специфичную для предметной области, узнают об этом только после того, как архитектура утверждена и сроки сдвинуты.
- Система мониторинга так и не создается. Рабочие модели VLM на этапе тестирования незаметно ухудшаются в процессе производства. Распределение входных данных меняется, например, из-за появления новых категорий продукции, обновления шаблонов документов, сезонных изменений освещения на заводе, а выходные данные смещаются без видимого сигнала.
Каждой из этих проблем можно избежать. Шесть приведенных ниже решений непосредственно касаются их решения.
Готовность данных — это определяющий фактор.
Есть ли у вас достаточное количество аннотированных пар «изображение-текст», представляющих ваши фактические производственные данные, с одинаковым качеством аннотаций? Если честный ответ — нет, то это первая проблема, которую нужно решить. Все остальное — второстепенно.
Большинство корпоративных архивов изображений были собраны для хранения. Аннотирование занимает больше времени, чем интеграция модели. Команды, которые начинают тонкую настройку до проверки качества данных, создают модель, которая демонстрирует высокую степень уверенности и ошибочность именно в тех сценариях, которые имеют наибольшее значение. Заложите в бюджет подготовку данных как первоклассный результат проекта. Это критически важный этап.
Требования к задержке и пропускной способности определяют архитектуру.
Решение о выборе модели, принятое до определения требований к задержке, — это предположение. Пакетная обработка документов, например, обработка счетов-фактур в течение ночи, обновление каталогов и проверка соответствия, допускает многосекундные задержки. Проверка в реальном времени на скорости линии — нет. Визуальный поиск в реальном времени — нет. Периферийные вычисления или облако, размер модели, стратегия пакетной обработки, квантование — эти решения зависят от ваших требований к пропускной способности. Модель, которая показывает хорошие результаты по точности, но не соответствует вашим требованиям к задержке, — это неправильная модель.
Точная настройка против оперативного проектирования против RAG
Тонкая настройка — самый дорогой вариант, требующий наибольших объемов данных и наиболее сложный для отмены. Большинство команд начинают с нее, потому что это звучит как строгий подход. Зачастую это неверная отправная точка.
Оперативное проектирование решает большинство задач адаптации предметной области для универсальной модели машинного зрения. Никаких обновлений весов, никаких размеченных наборов данных, никаких запусков обучения. Если задача достаточно общая, чтобы инструкции на естественном языке позволили достичь приемлемой точности, вы сэкономите недели и значительные средства. Генерация с использованием дополненных знаний обрабатывает следующий уровень: динамические знания, на которых модель не обучалась, извлекаются во время вывода, а не внедряются в процессе переобучения.
Тонкая настройка оправдана, когда ключевым требованием является точность визуализации в конкретной предметной области, и у вас есть 1000 или более высококачественных пар «изображение-текст» с аннотациями. Ниже этого порога вы обучаете модель на шуме и называете это специализацией.
Оценка, специфичная для предметной области, проводится до выбора модели.
Выбор модели из рейтинга — разумная отправная точка. Однако развертывание модели без тестирования на собственных данных приводит к обнаружению проблем с точностью через шесть месяцев после запуска.
Прежде чем окончательно определиться с моделью, создайте 100-200 репрезентативных примеров на основе реальных производственных данных. Протестируйте каждый из них. Результаты расскажут вам больше, чем любые сравнительные тесты. Команды, пропускающие этот шаг, обнаруживают проблему только после того, как архитектура утверждена, тонкая настройка завершена, и уровень ошибок в производственной среде уже виден бизнесу.
Выбор между открытым исходным кодом и API — это вопрос личного выбора.
Большинство команд разрабатывают прототипы на основе API, потому что это быстро. Однако некоторые затем обнаруживают, что их производственная среда не может его использовать. Требования к размещению данных, обязательства по аудиту и договорные ограничения на передачу конфиденциальных графических данных третьим сторонам могут исключить возможность развертывания API, независимо от того, насколько хорошо работает модель.
В регулируемых отраслях часто невозможно передавать данные об образах клиентов или операционные данные через внешние API без специальных соглашений об обработке данных. Модели с открытым исходным кодом на частной инфраструктуре полностью снимают это ограничение. Это решение также влияет на тонкую настройку доступа, проектирование мониторинга и долгосрочную структуру затрат. Принимайте его до проектирования архитектуры, а не после создания прототипа на инфраструктуре, которую производство не может использовать.
Мониторинг — это производственная инфраструктура.
Виртуальная модель обучения (VLM), работающая на тестовом сервере, начнет деградировать в рабочей среде, если за ней никто не следит. Изменение распределения входных данных. Новая категория товаров. Обновленный шаблон документа. Изменение освещения в цехе. Выходные данные смещаются, и модель не осознает своих проблем. Она продолжает выдавать уверенные ответы, в то время как частота ошибок незаметно растет, пока кто-то не заметит это в бизнес-показателях, а не в показателях модели.
Перед развертыванием системы необходимо предусмотреть калибровку достоверности, обнаружение дрейфа выходных данных и процедуру проверки результатов с низкой степенью достоверности человеком. Команды, которые рассматривают мониторинг как задачу после запуска, подают отчеты об инцидентах через три месяца.
Как наша компания создает решения VLM
У нас более 200 экспертов в области ИИ/машинного обучения и обработки данных. Команды, занимающиеся компьютерным зрением и машинным обучением, работают вместе над каждым проектом, а не последовательно. Команда, создающая слой компьютерного зрения, разрабатывает слой логического мышления и вывода результатов. Большинство сбоев в машинном обучении происходит на стыке этих двух этапов, и это сложнее обнаружить, когда за каждый из них отвечают две разные команды.
Каждое сотрудничество начинается с аудита данных. Мы не будем рекомендовать модель, пока не проверим ваши данные изображений, качество размеченных образцов и ваши требования к интеграции. Далее последовательность действий определяется заранее: проектирование архитектуры, выбор модели, создание оценочного набора данных для конкретной предметной области, а затем тонкая настройка, если этого требуют данные. Мониторинг и обнаружение дрейфа поставляются вместе с системой. Они не запланированы на более поздний этап.
Проверка концепции охватывает один четко определенный рабочий процесс, с оценочным показателем, согласованным до начала работы. Если показатели изменятся, у вас будет подтвержденная основа для полномасштабного внедрения. Если нет, у вас будет честный ответ до начала реальных затрат.
Если у вас есть конкретный рабочий процесс (например, обработка документов, визуальный контроль или автоматизация каталогизации), наша команда специалистов по искусственному интеллекту может проанализировать ваш сценарий использования и структуру данных, определить, подходит ли вам VLM, и посоветовать, что потребуется для его создания.
Часто задаваемые вопросы
Что такое языковая модель обработки изображений?
Языковая модель визуального восприятия (VLM) — это система искусственного интеллекта, которая принимает изображения и текст в качестве совместного входного параметра и выдает текстовый результат. Она может анализировать документ, интерпретировать его визуальное оформление и одновременно рассуждать как об изображении, так и о тексте. Стандартная языковая модель видит только текст. Все остальное, такое как оформление, визуальный контекст и содержимое изображения, для нее невидимо.
В чём разница между VLM и стандартным LLM?
Стандартная языковая модель обработки текста (LLM) обрабатывает только текст. Визуальная языковая модель (VLM) добавляет кодировщик изображения и кросс-модальный коннектор, которые преобразуют содержимое изображения в формат, понятный языковой модели. Если ваши входные данные — это исключительно текст, стандартная LLM проще, быстрее и дешевле. Мультимодальная LLM оправдывает себя, когда визуальный слой изменяет ответ.
Как оцениваются языковые модели зрения?
К распространенным бенчмаркам относятся VQA (Visual Question Answering), MMMU (Massive Multidisciplinary Multimodal Understanding) и TextVQA (текст, встроенный в изображения). Они измеряют производительность на общедоступных наборах данных. Они практически ничего не говорят о том, как модель работает с вашими документами, типами дефектов или изображениями вашей продукции. Создайте 100-200 примеров на основе ваших реальных производственных данных и протестируйте каждый вариант, прежде чем принимать окончательное решение.
Какие наборы данных используются для обучения языковых моделей компьютерного зрения?
Большинство базовых моделей визуального обучения (VLM) предварительно обучаются на больших наборах данных «изображение-текст». LAION-5B содержит пять миллиардов пар; COCO предоставляет размеченные изображения для задач создания подписей и обнаружения объектов. Для корпоративного развертывания данные для предварительного обучения имеют меньшее значение, чем данные для тонкой настройки. Модель, обученная на общем веб-контенте, будет показывать низкую производительность на специализированных промышленных, медицинских или финансовых данных, пока не получит достаточно примеров из вашей предметной области.
В чём разница между языковой моделью визуального восприятия и языковой моделью действий визуального восприятия?
Модель визуального языка действий (VLM) принимает на вход изображение и текст и выдает текстовый результат. Она анализирует увиденное. Модель визуального языка действий (VLA) добавляет слой вывода действий, описывающий воспринимаемое и реагирующий на него: команды управления двигателями, системные вызовы, физические движения. VLA уже сегодня готовы к использованию в узких, контролируемых средах, таких как промышленная робототехника и автоматизация складских операций. Для обработки документов, визуального контроля и большинства рабочих процессов корпоративного программного обеспечения VLM являются подходящей системой.
Какая модель обработки изображений лучше всего подходит для корпоративного использования?
Единого ответа нет. Модели с закрытым API обеспечивают наиболее быструю окупаемость инвестиций для общих задач на неконфиденциальных данных; модели с открытым исходным кодом являются практичным выбором, когда ограничениями являются суверенитет данных, тонкая настройка или стоимость вывода на основе объема. Перед выбором любой модели создайте набор данных для оценки, специфичный для вашей предметной области. Позиция в бенчмарке плохо предсказывает производительность на ваших конкретных входных данных.